Any Time, Any Space (ATAS)
Ett agentsystem som gör om ett filmmanus till många videoklipp och håller reda på rum och händelser i ett 3D-minne, så att platser och föremål ser likadana ut varje gång man återvänder till dem.
- Videogenerering
- Agenter
- Minne
- 3D
 1 / 8
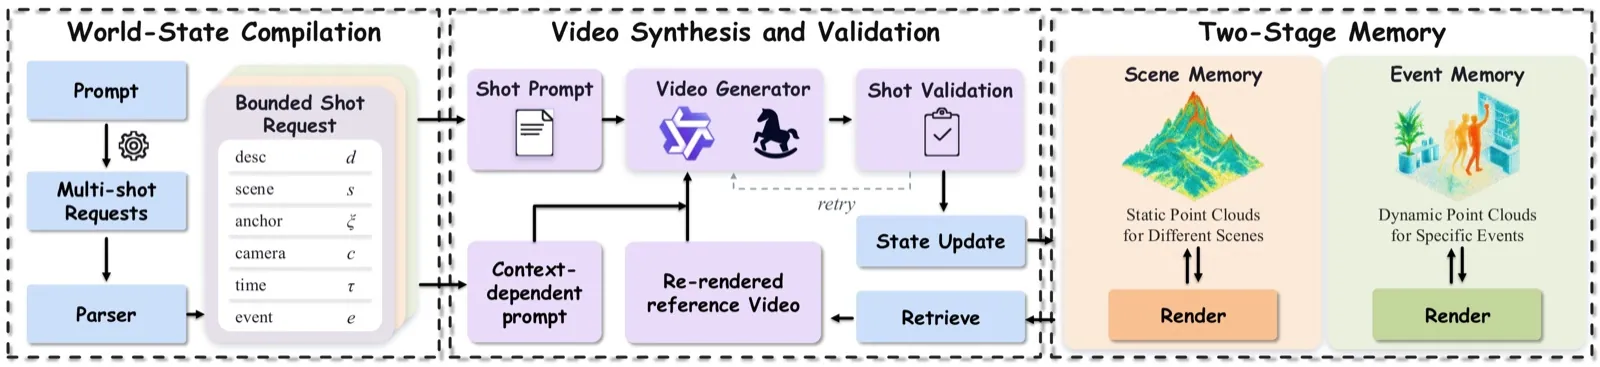
Så fungerar ATAS: manuset blir klipp, och scen- och händelseminnet styr och uppdateras av varje klipp [1]
Om Any Time, Any Space (ATAS)[1][2][3][4][5]
Any Time, Any Space (ATAS) är ett forskningsprojekt om att göra längre filmer med AI-videogeneratorer, som oftast bara klarar korta klipp. När en film delas upp i många klipp är det svårt att få samma rum att se likadant ut när man återvänder dit, eller att visa en tidigare händelse igen från en ny vinkel. Att bara skicka med text eller de senaste bildrutorna mellan klippen räcker inte.
ATAS bygger i stället upp ett beständigt världstillstånd bakom hela filmen. Manuset delas upp i klipp med uttalad plats, kamera och tidpunkt. Före varje klipp hämtar systemet underlag ur två minnen: ett scenminne med rummens fasta 3D-geometri och ett händelseminne med rörliga saker kopplade till en viss händelse och tidpunkt. Efter varje klipp återskapas det i 3D och läggs in i minnet, men bara om det klarar en granskning och en kontroll av att det stämmer med världen. Klippet hamnar i filmen oavsett.
Forskarna har testat ATAS med fyra olika videogeneratorer. Enligt dem förbättrar systemet alla redovisade mått på samstämmighet mellan klippen, slår jämförda agentsystem och 3D-styrda metoder på att återvända till en plats, och får högst betyg av mänskliga bedömare på alla sex kriterier.
Arbetet kommer från ZIP Lab vid Zhejiang University tillsammans med Monash University, UC Berkeley och Adelaide University. Koden finns på GitHub under MIT-licens. Själva videon görs av befintliga videogeneratorer, och kodens exempelinställningar kräver bland annat en API-nyckel till Alibabas DashScope.
Det viktigaste[1][2][3]
- Gör om ett filmmanus till många korta klipp som hänger ihop i rum och tid.
- Ett scenminne med 3D-geometri gör att rum ser likadana ut när kameran återvänder, även från en ny vinkel.
- Ett händelseminne gör att en tidigare händelse kan visas igen från en annan kamera.
- Nya klipp läggs bara in i minnet om de klarar en granskning, så att fel inte sprider sig.
- Enligt forskarna bättre samstämmighet med alla fyra testade videogeneratorer och högst betyg av mänskliga bedömare på alla sex kriterier.
- Koden finns på GitHub under MIT-licens, men systemet använder befintliga videogeneratorer och externa tjänster.
Källor
- [1] Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation ↗Zhejiang University, Monash University, UC Berkeley och Adelaide University Officiell sida lhmd.topPublicerad okänt datum Läst 25 okt 2026
- [3] Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation ↗ZIP Lab Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [5] Quantum breakthrough, Gemini 4 Argon, Muse Wonder, Drama 3, MOSS Image, Krea 3, Ling 3.1: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 18 okt 2026 Läst 25 okt 2026
- [4] Quantum breakthrough, Gemini 4 Argon, MOSS Image, KLING 4, OpenAI spy, Muse Wonder: AI NEWS ↗AI Search Video youtube.comPublicerad 17 okt 2026 Läst 25 okt 2026
- [2] Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 14 okt 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från ZIP Lab
- Block3D 20 aug 2026