COSMI
Skapar rörelser där en människa hanterar upp till fem föremål samtidigt, utifrån en textbeskrivning, genom att sätta ihop enklare inspelningar.
- Animation & rörelse
- 3D
 1 / 3
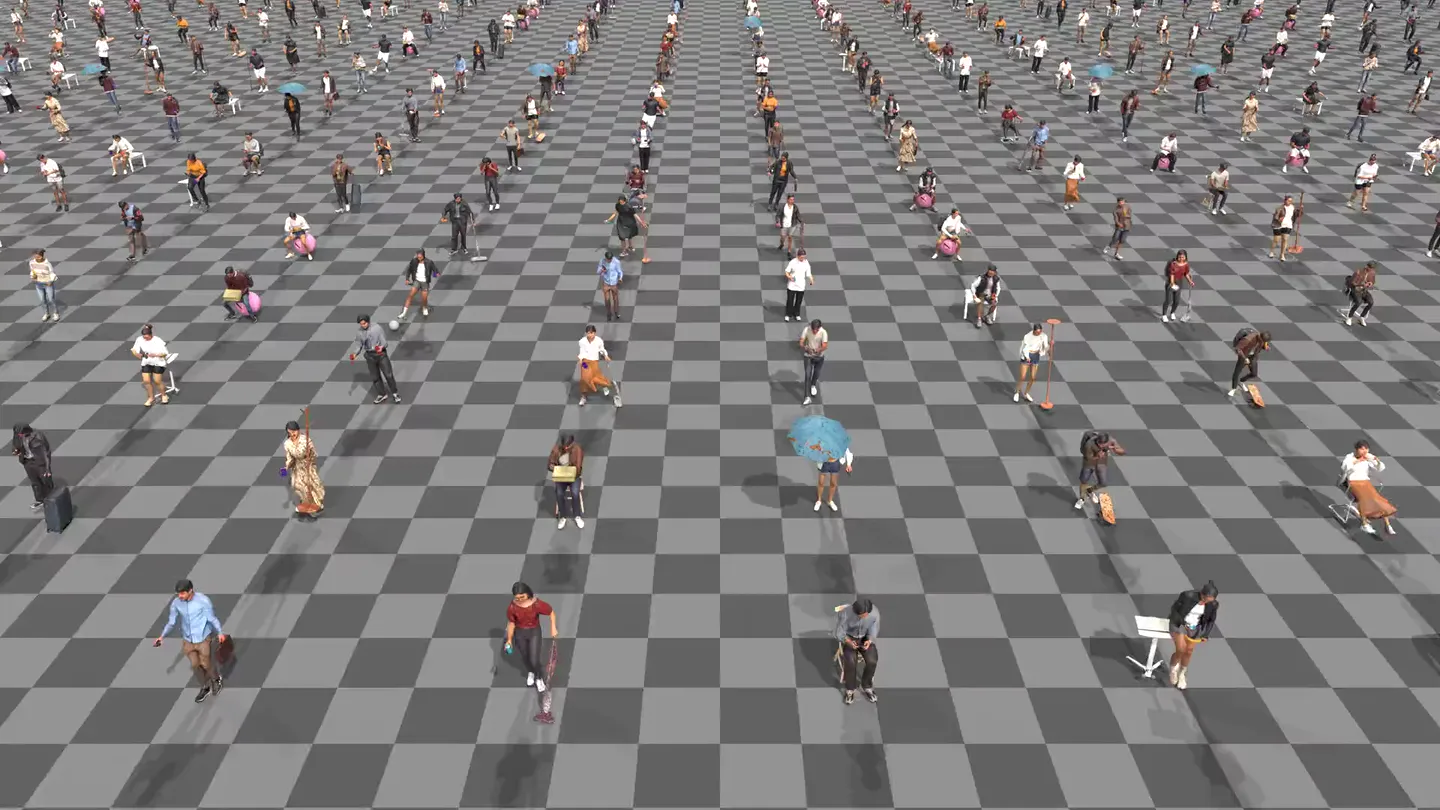
Sekvenser ur COSMI-datasetet, sammansatta av enklare inspelningar [1]
Om COSMI[1][2][3][4]
COSMI (Compositional Synthesis of Multi-Object Interactions) är ett forskningsprojekt om att generera människors rörelser när de hanterar flera föremål, som att sitta på en pall, prata i telefon och dricka ur en flaska. Vardagliga aktiviteter involverar ofta flera saker, men de flesta inspelade dataset visar bara ett föremål i taget eftersom det är dyrt att spela in allt samtidigt.
Forskarnas iakttagelse är att interaktioner är lokala: att sitta använder höften och att dricka använder höger hand. De klipper därför befintliga inspelningar i korta klipp med en handling var, speglar dem så att båda händerna blir representerade, och låter en språkmodell och geometriska kontroller välja vilka kombinationer som är rimliga. Resultatet är COSMI-datasetet med 222 000 sekvenser och 275 timmar rörelse med ett till fem föremål, enligt forskarna nästan trettio gånger större än den största inspelningen med flera föremål.
På datan tränas en diffusionsmodell som utifrån text genererar en människa och ett till fem föremål. Varje föremål placeras i förhållande till den kroppsdel som rör det, som en kopp vid handleden. Enligt forskarna slår COSMI jämförda metoder (HIMO samt varianter av MDM och PriorMDM) i hur väl rörelsen följer texten och i kontaktprecision. Koden, modellerna och datasetet ska enligt GitHub-sidan släppas snart.
Arbetet kommer från Universität Tübingen, Tübingen AI Center, Zuse School ELIZA och Max Planck Institute for Informatics.
Det viktigaste[1][2][3]
- Genererar rörelser med en människa och ett till fem föremål från en textbeskrivning.
- COSMI-datasetet: 222 000 sekvenser, 275 timmar, 29,7 miljoner bildrutor, 36 föremål och 59 personer.
- Datasetet byggs genom att sätta ihop inspelningar av enklare interaktioner med ett föremål i taget.
- Enligt forskarna bättre än jämförda metoder på textföljsamhet och kontaktprecision, särskilt med föremål som modellen inte sett.
- Kod, modeller och dataset är ännu inte släppta.
Källor
- [1] COSMI: Compositional Synthesis of Multi-Object Interactions ↗Universität Tübingen, Tübingen AI Center och Max Planck Institute for Informatics Officiell sida ptrvilya.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] COSMI: COmpositional Synthesis of Multi-object Interactions ↗Ilya Petrov (GitHub) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] OpenAI math breakthroughs, AlphaProtein Novo, Botanic-1, Iris 3B, Kandinsky 6.0: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 11 okt 2026 Läst 25 okt 2026
- [2] COSMI: COmpositional Synthesis of Multi-object Interactions ↗arXiv Forskningsartikel arxiv.orgPublicerad 2 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-10-11). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Universität Tübingen
- PAMI 29 sep 2026