dots3-note Preview
Den minsta modellen i RedNotes dots3-serie: en öppen multimodal modell som läser text, bilder, video och ljud, har 512 000 tokens kontext och är byggd för långa agentuppgifter.
- Språkmodell
- Resonemang
- Agenter
- Kod
- Multimodal
- Bildförståelse
 1 / 4
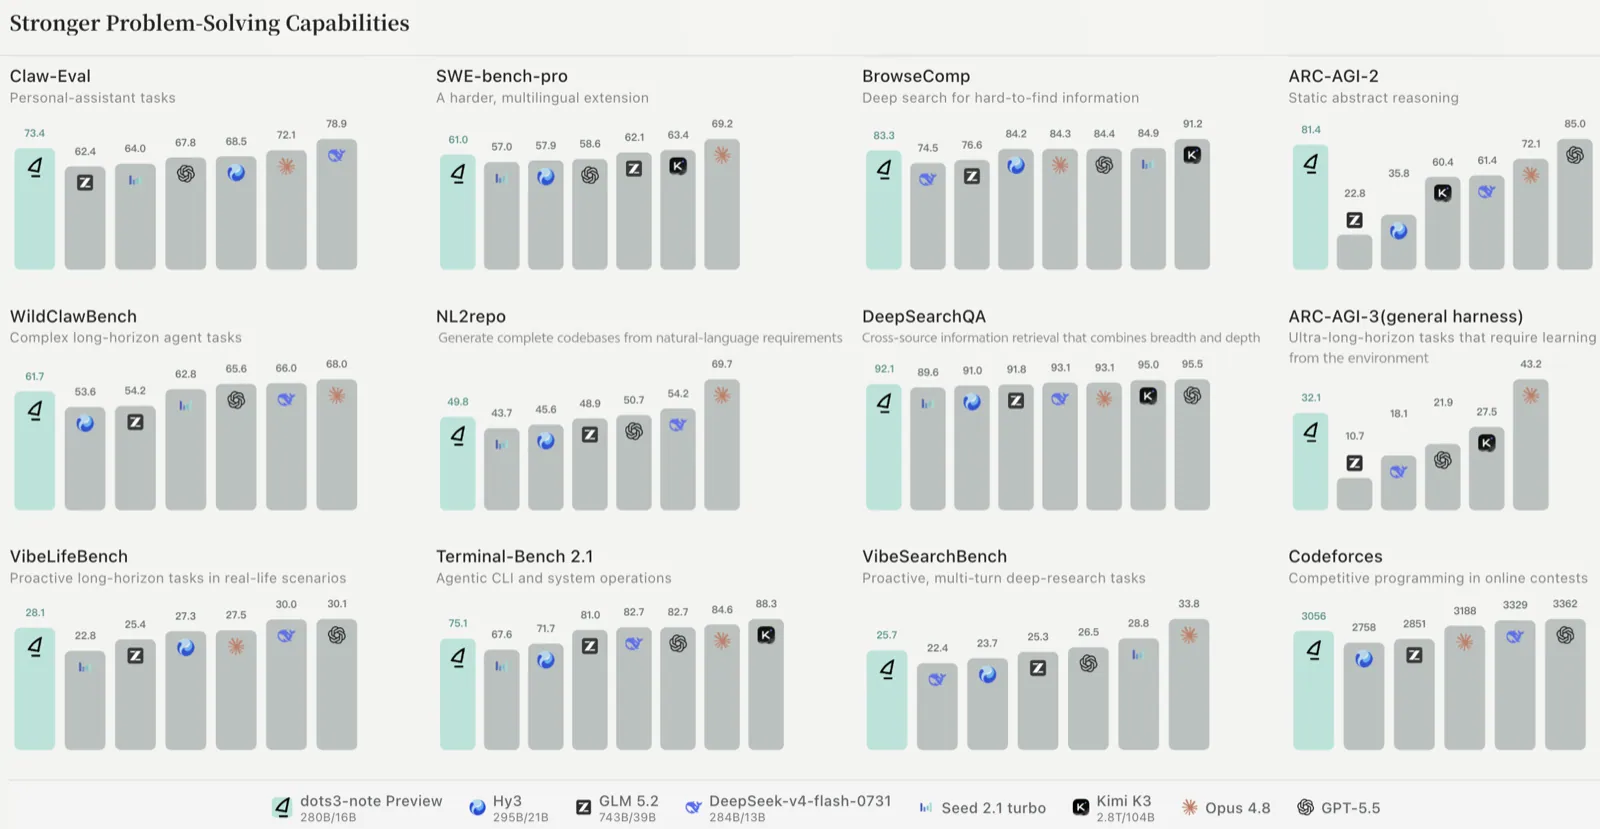
Resultat på tester av resonemang, kod och agentuppgifter, enligt Dots Studio [2]
Om dots3-note Preview[1][2][4]
dots3-note Preview är den första och lättaste modellen i dots3-serien från Dots Studio, AI-teamet hos den kinesiska plattformen RedNote (Xiaohongshu). Hela serien ska enligt teamet bestå av note, jazz och aria, med olika avvägningar mellan förmåga, svarstid och kostnad. De två större är inte släppta än.
Modellen är en mixture of experts med 280 miljarder parametrar totalt, varav 16 miljarder används per token. Den tar emot text, bilder, video och ljud och svarar med text, och klarar upp till 512 000 tokens kontext. Den är tränad för resonemang, kod, verktygsanvändning och långa agentuppgifter. Enligt Dots Studio presterar den i nivå med eller bättre än modeller som är flera gånger större, till exempel 78,4 på SWE-bench Verified och 61 på SWE-bench Pro.
Teamet har utvecklat en träningsmetod, TEMPO, där samma agent växlar mellan att agera och att bedöma sina egna framsteg, så att den kan tränas på uppgifter som tar tiotals timmar. Enligt teamet fick en intern variant av modellen full pott, 42 av 42, och guldmedalj vid IMO 2026. Med släppet följer också två testmiljöer för vardagliga uppgifter, VibeSearchBench och VibeLifeBench.
Vikterna finns på Hugging Face och GitHub under Apache 2.0, även i en FP8-version, och modellen går att prova gratis via OpenRouter. En teknisk rapport utlovades inom en vecka efter släppet.
Det viktigaste[1][2]
- Öppen multimodal modell: läser text, bilder, video och ljud, svarar med text.
- 280 miljarder parametrar totalt, 16 miljarder aktiva, och 512 000 tokens kontext.
- Enligt Dots Studio 78,4 på SWE-bench Verified och 61 på SWE-bench Pro, i nivå med mycket större modeller.
- Enligt teamet fick en intern variant guld med 42 av 42 poäng vid IMO 2026.
- Den lättaste av tre planerade dots3-modeller (note, jazz och aria).
- Apache 2.0, gratis att prova via OpenRouter.
Källor
- [1] dots3-note Preview: A Small but Mighty Step Toward Long-Horizon Agency in Real Life ↗Dots Studio (RedNote) Officiell sida studio.dots.aiPublicerad okänt datum Läst 25 okt 2026
- [4] GPT 6 Sol, Gemini 3.8 TTS, Grok 4.7, Opus 5.5, Mimo 2.6, WorldCrafter: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 27 sep 2026 Läst 25 okt 2026
- [5] Waifus incoming, GPT 6 Sol, Grok 4.7, Opus 5.5, Mimo 2.6, Step 5, OpenMuse: AI NEWS ↗AI Search Video youtube.comPublicerad 26 sep 2026 Läst 25 okt 2026
- [3] Deepseek v4 0813, Qwen 3.8 27B, GLM 5.3, Grok 4.6, LTX 2.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 16 aug 2026 Läst 25 okt 2026
- [2] dots-studio/dots3-note-prev ↗Dots Studio (RedNote) Modellkort huggingface.coPublicerad 9 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-16 och 2026-09-27, video 2026-09-26). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.