DuoMatching
En träningsmetod som gör snabb videogenerering i få steg skarpare genom att lära från både en videomodell (för rörelse) och en bildmodell (för varje enskild bildruta).
- Videogenerering
 1 / 3
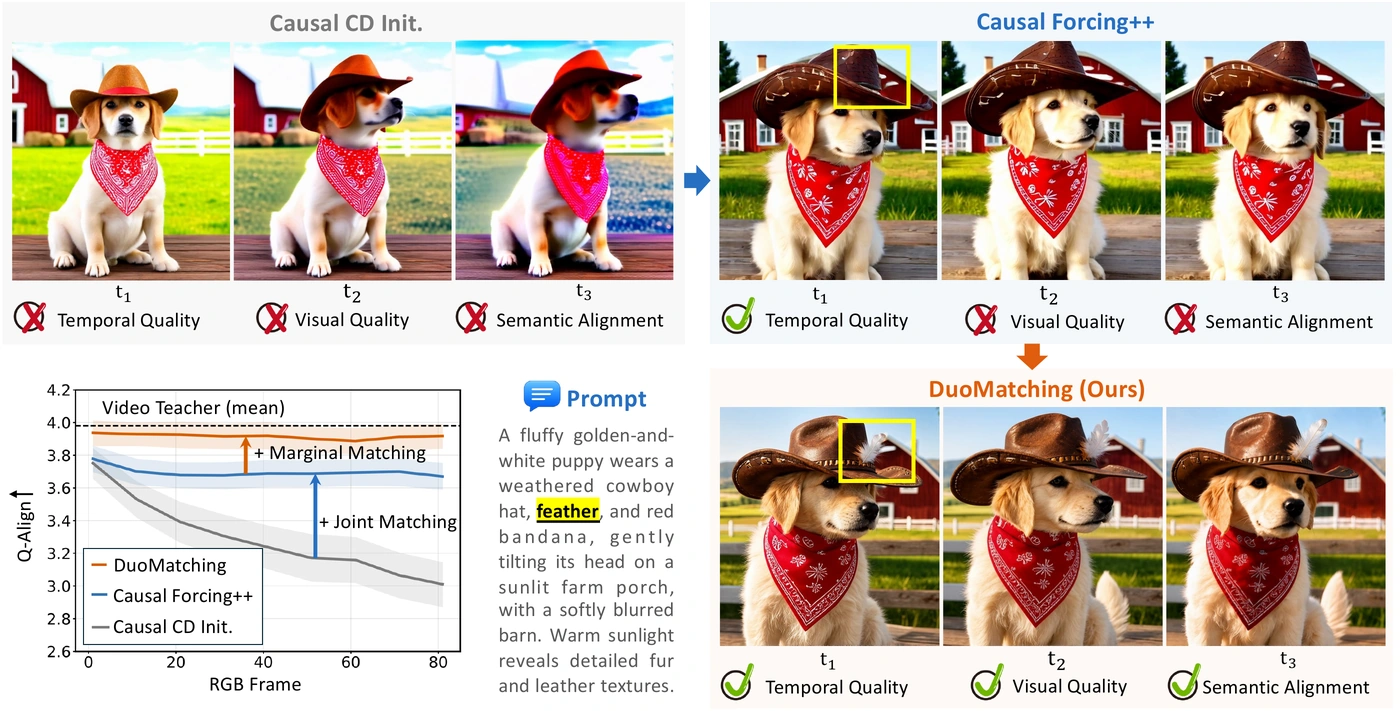
Jämförelse: med bara videoläraren försämras bildkvaliteten, med bildläraren tillagd blir bilderna skarpare [1]
Om DuoMatching[1][2][3][5]
DuoMatching (Joint–Marginal Distribution Matching for Few-Step Video Generation) handlar om att destillera stora videomodeller till snabba modeller som skapar video i bara några få steg, ofta strömmande bildruta för bildruta. Den vanliga metoden (distribution matching distillation) låter en stor videomodell vara lärare för hela klippet. Det håller rörelserna stabila, men bildkvaliteten och hur väl videon följer prompten blir lidande.
DuoMatching lägger till en andra lärare: en bildmodell som granskar varje enskild bildruta. Videoläraren styr rörelse och sammanhang över tid, medan bildläraren bidrar med skärpa, komposition och bättre följsamhet mot prompten. För att det ska fungera behövs en översättning mellan videomodellens och bildmodellens interna format, som forskarna kallar LatentBridge, och en teknik som sprider bildlärarens tillsyn över olika delar av klippet.
Enligt forskarna förbättrar metoden bildkvalitet, komposition och följsamhet mot prompten och behåller rörelserna i stort sett. I mänskliga jämförelser föredrogs DuoMatching i över 80 procent av fallen mot alla jämförda metoder (bland andra CausVid och Reward Forcing).
Arbetet kommer från MMLab vid Chinese University of Hong Kong, ByteDance, HKUST och CPII. Koden är öppen under Apache 2.0, och en färdig modell som skapar video i två steg, destillerad från Wan2.1-T2V-14B, ligger på Hugging Face.
Det viktigaste[1][3]
- Lär en snabb videomodell från både en videolärare (rörelse) och en bildlärare (varje bildruta).
- Ger enligt forskarna bättre bildkvalitet, komposition och följsamhet mot prompten med bibehållen rörelse.
- I mänskliga jämförelser föredragen i över 80 procent av fallen mot alla jämförda metoder, enligt forskarna.
- Färdig modell som skapar video i två steg, destillerad från Wan2.1-T2V-14B, finns på Hugging Face.
Källor
- [1] DuoMatching: Joint–Marginal Distribution Matching for Few-Step Video Generation ↗CUHK MMLab, ByteDance, HKUST och CPII Officiell sida johnzhan2023.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] DuoMatching ↗GitHub (JohnZhan2023) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [5] OpenAI math breakthroughs, AlphaProtein Novo, Botanic-1, Iris 3B, Kandinsky 6.0: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 11 okt 2026 Läst 25 okt 2026
- [2] DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 2 okt 2026 Läst 25 okt 2026
- [4] DuoMatching ↗Hugging Face (JohnZhan) Modellkort huggingface.coPublicerad 28 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-10-11). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från The Chinese University of Hong Kong
- OpenGame 21 apr 2026
- Gen-Searcher 30 mar 2026