Edge0
Ett öppet ramverk som kör stora MoE-språkmodeller på Mac med Apple-chip genom att låta det mesta av modellen ligga kvar på SSD-disken och bara läsa in de delar som behövs, så att en 35B-modell klarar sig på runt 3 GB minne.
- Kör lokalt
- Språkmodell
 1 / 4
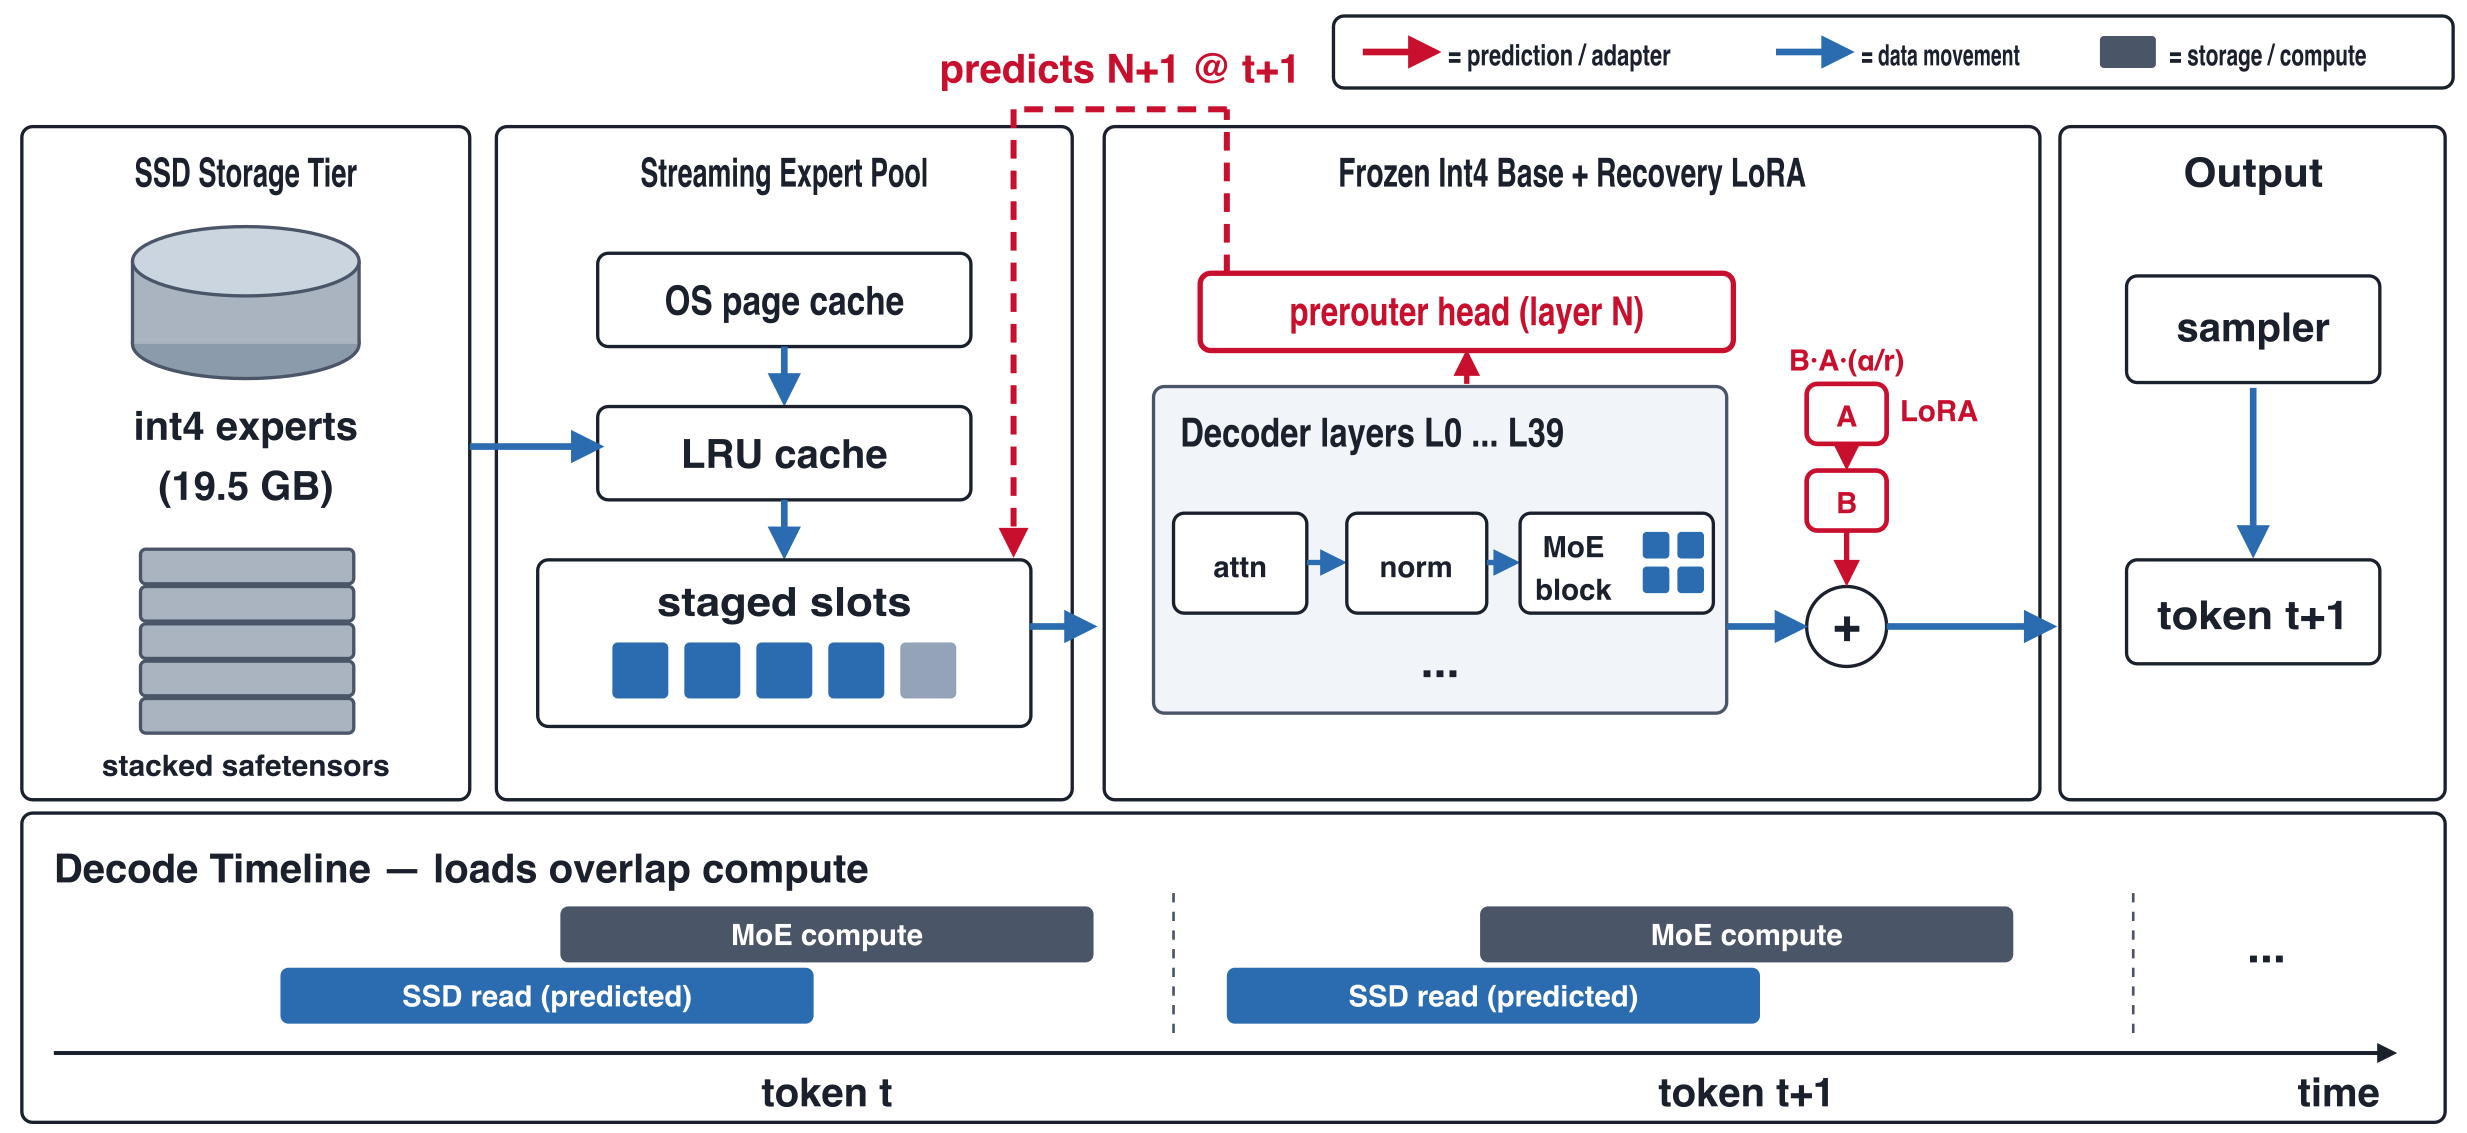
Så fungerar Edge0: expertvikterna ligger på SSD och läses in efter vad prerouten förutser [2]
Om Edge0[1][2][3]
Edge0 är öppen programvara för att köra stora AI-modeller lokalt på datorer med lite arbetsminne. Den är byggd för så kallade MoE-modeller (mixture of experts), där bara en liten del av modellens "experter" används för varje ord. Edge0 låter experternas vikter ligga kvar på SSD-disken och läser bara in dem som behövs. En liten extra modell, en "prerouter", gissar ett steg i förväg vilka experter som kommer att behövas, så att de kan hämtas i tid. Enligt utvecklarna ger det upp till 59 % snabbare textgenerering. Små LoRA-adaptrar återställer en del av kvaliteten som går förlorad när modellen komprimeras till 4 bitar.
Två modeller släpptes samtidigt: edge0-35b, byggd på Qwen3.6-35B-A3B, och edge0-8b, byggd på Ling 3.0. Enligt utvecklarnas mätningar på en Mac mini M4 Pro behöver 35b-versionen cirka 2,9 GB minne och genererar 15–18 tokens per sekund, och 8b-versionen cirka 1 GB och 24–25 tokens per sekund. Samma 35b-version ska gå att köra på en MacBook M2 med 16 GB. Priset är något lägre kvalitet: i OpenCompass-tester får 35b-versionen i snitt 79,2 mot 83,2 för originalmodellen, och 8b-versionen 69,9 mot 72,7.
Edge0 släpptes som öppen källkod under Apache 2.0 den 8 september 2026, med en teknisk rapport på arXiv. Python-versionen fungerar i dagsläget bara på Mac med Apple-chip (M1–M4) och kan starta en lokal server som är kompatibel med OpenAI:s API. Den 30 september släpptes även källkoden för motorer till iOS, macOS, Android och Windows. Stöd för Nvidia-grafikkort (CUDA) är planerat till fjärde kvartalet 2026.
Det viktigaste[1][2]
- Kör en 35B MoE-modell med cirka 2,9 GB minne genom att läsa experterna från SSD-disken vid behov, enligt utvecklarna.
- En prerouter förutser vilka experter som behövs härnäst och ger enligt utvecklarna upp till 59 % snabbare generering.
- Enligt utvecklarna 15–18 tokens per sekund för edge0-35b och 24–25 för edge0-8b på en Mac mini M4 Pro.
- Något sämre kvalitet än originalen: 79,2 mot 83,2 (35b) och 69,9 mot 72,7 (8b) i snitt på OpenCompass, enligt rapporten.
- Öppen källkod under Apache 2.0; i dag bara Mac med Apple-chip i Python, med motorer för iOS, Android och Windows publicerade som källkod.
Källor
- [2] The Other Half of the Memory Wall: Serving 35B MoEs from SSD with Trained Routing Prediction ↗arXiv Forskningsartikel arxiv.orgPublicerad 16 sep 2026 Läst 25 okt 2026
- [3] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
- [1]
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.