Fibo 2.0
Brias nya öppna bildmodell som både skapar och redigerar bilder i en och samma modell, styrd av detaljerade strukturerade beskrivningar och tränad enbart på licensierat material.
- Bildgenerering
- Bildredigering
 1 / 7
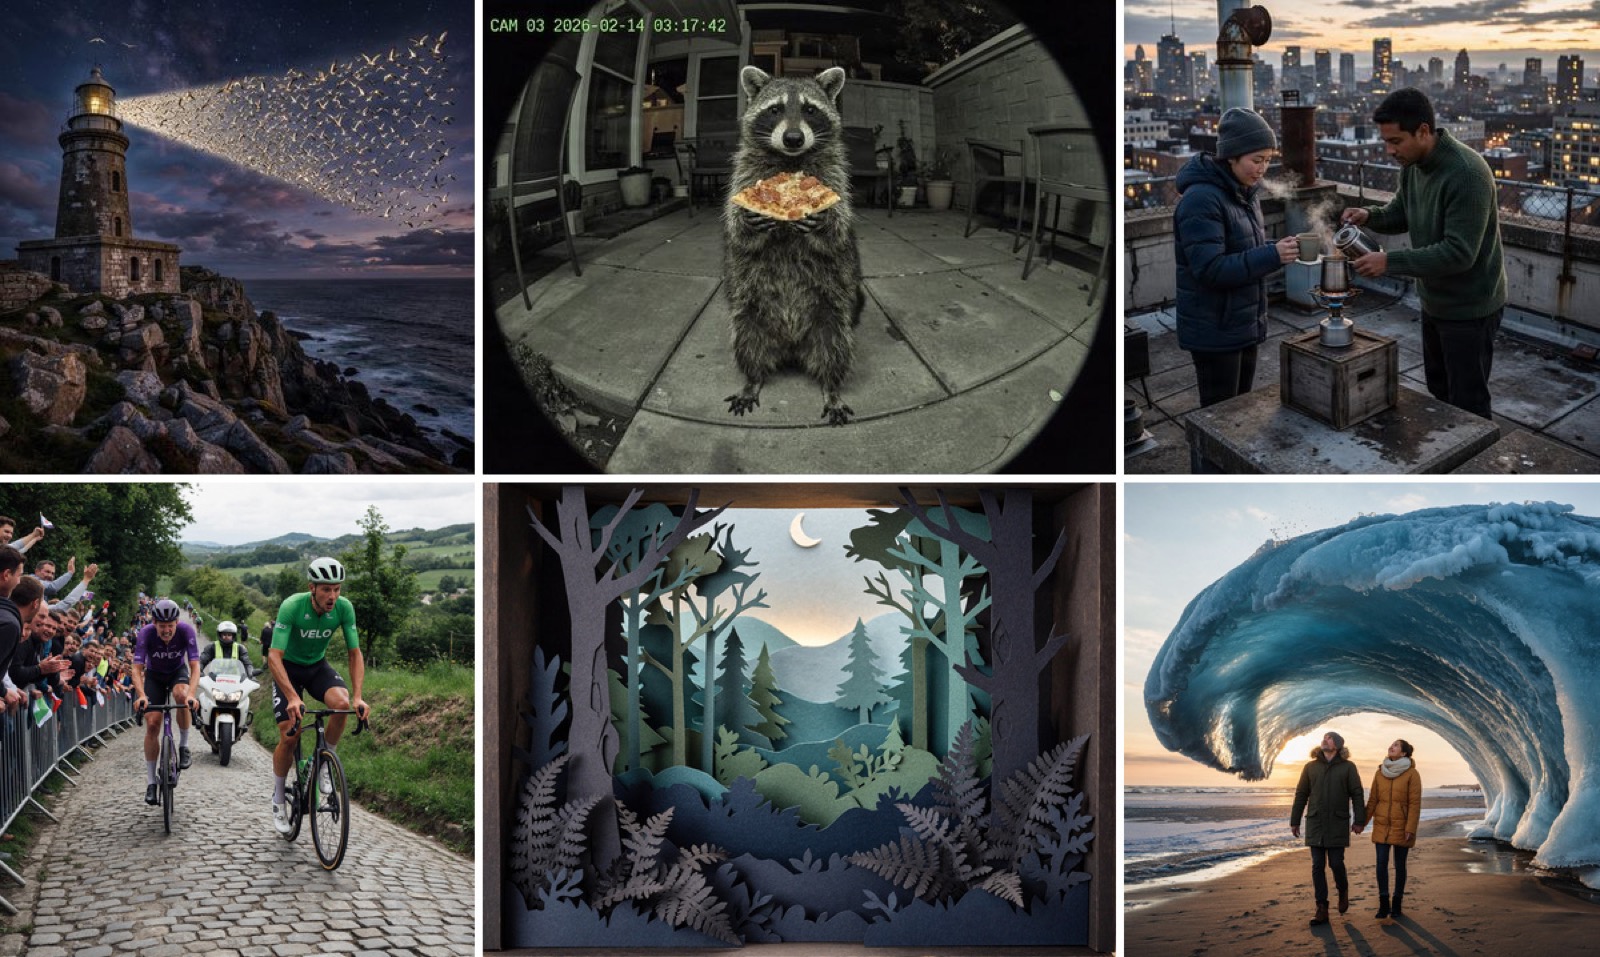
Ett urval bilder skapade med Fibo 2.0 från text [1]
Om Fibo 2.0[1][2][3]
Fibo 2.0 är nästa generation av Brias FIBO-familj. Det nya är att bildgenerering och bildredigering finns i samma modell: man kan skapa en bild från en kort text, ändra en befintlig bild med en instruktion, begränsa ändringen till ett markerat område (mask) eller kombinera upp till fyra referensbilder, till exempel för virtuell provning av kläder eller för att placera en produkt i en miljö. Enligt Bria behåller modellen det man inte bett om att ändra, som identitet, komposition, ljus och detaljer, och är tydligt bättre än tidigare versioner på text i bilder, materialkänsla och anatomi (händer, ansikten, poser).
Modellen styrs med Brias beskrivningsformat VGL (Visual GenAI Language), där en bild beskrivs som en lång strukturerad JSON-text med separata fält för ljus, komposition, kamera, stil och varje objekt. Man behöver inte skriva den själv: Brias öppna paket bria-vgl gör om en kort prompt eller en vanlig redigeringsinstruktion till en sådan beskrivning (paketet använder i sin tur Googles Gemini). Det finns också fem valfria fotostilar, bland annat "Boring Reality" för vardaglig, opolerad realism, Kodak-film och hård blixt.
Tekniskt är det en flow matching-modell med cirka 8 miljarder parametrar och 44 transformerblock, som använder Qwen3-VL-4B-Instruct som textkodare. Versionen på Hugging Face, Fibo 2.0 Dev, är den fullständiga, odestillerade basmodellen och är tänkt som utgångspunkt för egen finjustering; för snabb redigering i få steg finns den destillerade varianten Fibo 2.0 Edit Turbo. Vikterna kräver att man fyller i ett formulär och får bara användas icke-kommersiellt (CC BY-NC 4.0); kommersiell användning kräver ett avtal med Bria. Modellen finns även via Brias API, fal.ai och ComfyUI.
Det viktigaste[1]
- En enda modell för både bildgenerering och bildredigering, med stöd för mask och upp till fyra referensbilder.
- Enligt Bria etta bland öppna modeller i bildredigering och tvåa i text-till-bild på Artificial Analysis Image Arena (20 oktober 2026).
- Enligt Bria bättre text i bilder, materialkänsla och anatomi än tidigare FIBO-versioner.
- Tränad enbart på licensierat material, enligt Bria.
- Styrs med strukturerade JSON-beskrivningar (VGL) så att man kan ändra en sak, till exempel kameravinkel, utan att resten av bilden förändras.
- Cirka 8B parametrar; vikterna är öppna för icke-kommersiellt bruk, kommersiell användning kräver avtal.
Källor
- [3] Cybersecurity chaos, AI for DNA, Kimi K3.1, Claude Duet, Dessa, Fibo 2, Minimax 3.1: AI NEWS ↗AI Search Video youtube.comPublicerad 24 okt 2026 Läst 25 okt 2026
- [2] Fibo 2.0: Bria's 8B open-weights model edits and generates images ↗ComfyUI Wiki Artikel comfyui-wiki.comPublicerad 20 okt 2026 Läst 25 okt 2026
- [1]
Historik
- 25 okt 2026Tillagd i listan efter AI Search-videon. [3]