Fire3D
Gör om en bild eller en vardaglig video till en 3D-scen med separata, redigerbara föremål på under en minut, utan att man behöver markera något själv.
- 3D
- Bildförståelse
 1 / 3
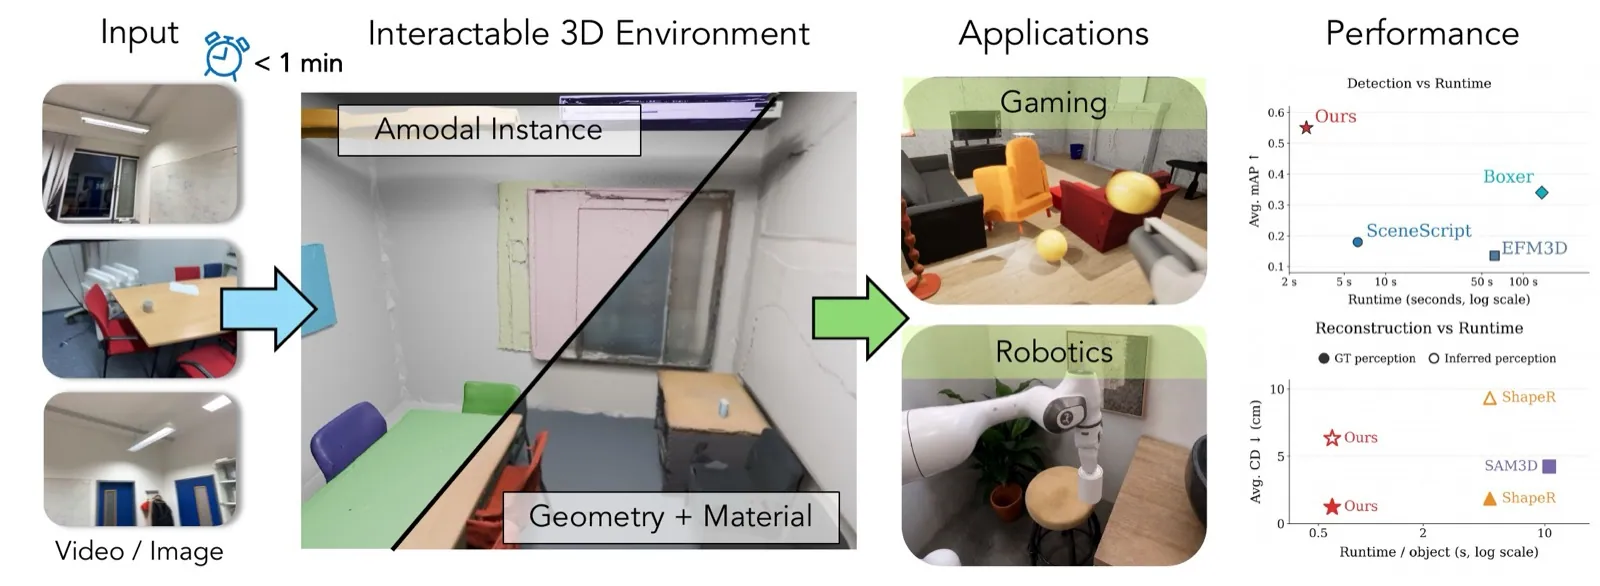
Från bild eller video till en 3D-scen med separata, texturerade föremål [1]
Om Fire3D[1][2][3][4][5]
Fire3D (Feed-forward Interactive 3D Scene Reconstruction Within A Minute) tar en vanlig bild eller en enkel mobilvideo av ett rum och bygger upp en 3D-scen där varje föremål är en egen, komplett 3D-modell med textur. Även rummet självt (väggar, golv) blir en egen del. Föremålen kan sedan flyttas och redigeras var för sig, till exempel i spel eller simuleringar.
Andra metoder brukar bara lösa en del av problemet: vissa hittar föremålen men ger inga kompletta 3D-modeller, andra skapar ett föremål i taget men kräver att man markerar det först, och ytterligare andra optimerar fram en hel scen men tar minuter till timmar per inspelning. Fire3D gör allt i ett flöde utan optimering per scen: modellen räknar ut hur många föremål som finns, var de står och hur de är vända, och skapar sedan kompletta modeller av dem, även de delar som inte syns i bilden.
Enligt forskarna klarar systemet upp till tolv texturerade föremål, inklusive bakgrunden, på under en minut, och upp till 16 föremål kan skapas parallellt på ett grafikkort tack vare en komprimerad representation (HC-VAE). Det bygger delvis på Pi3X för kamerapositioner och djup, och på delar från TRELLIS.2 och DINOv3.
Arbetet kommer från University of Illinois Urbana-Champaign och Cornell University. Kod (även träningskod), modellvikter och exempeldata är släppta; Fire3D:s egen kod är MIT-licensierad, medan de medföljande delarna från DINOv3 och TRELLIS.2 har sina egna licenser. Forskarna testade utgåvan på ett grafikkort med 96 GB minne.
Det viktigaste[1][3][4]
- En bild eller en vardaglig video blir en 3D-scen med separata, redigerbara föremål.
- Enligt forskarna upp till tolv texturerade föremål inklusive rummet på under en minut.
- Ingen markering av föremål behövs och ingen optimering per scen.
- Kod, träningskod och vikter släppta; egen kod under MIT, delar från DINOv3 och TRELLIS.2 har egna licenser.
Källor
- [1] FIRE3D: Feed-forward Interactive 3D Scene Reconstruction Within A Minute ↗University of Illinois Urbana-Champaign och Cornell University Officiell sida xiahongchi.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3]
- [5] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
- [2] FIRE3D: Feed-forward Interactive 3D Scene Reconstruction Within A Minute ↗arXiv Forskningsartikel arxiv.orgPublicerad 8 sep 2026 Läst 25 okt 2026
- [4] hongchi/Fire3D ↗Hugging Face (hongchi) Modellkort huggingface.coPublicerad 8 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.