GE-Act 2.0
AgiBots robotmodell som först föreställer sig hur scenen ska se ut efter en handling och sedan räknar ut rörelserna som tar roboten dit, tränad från grunden på upp till 30 000 timmar robotdata.
- Robotik
- Världsmodeller
 1 / 4
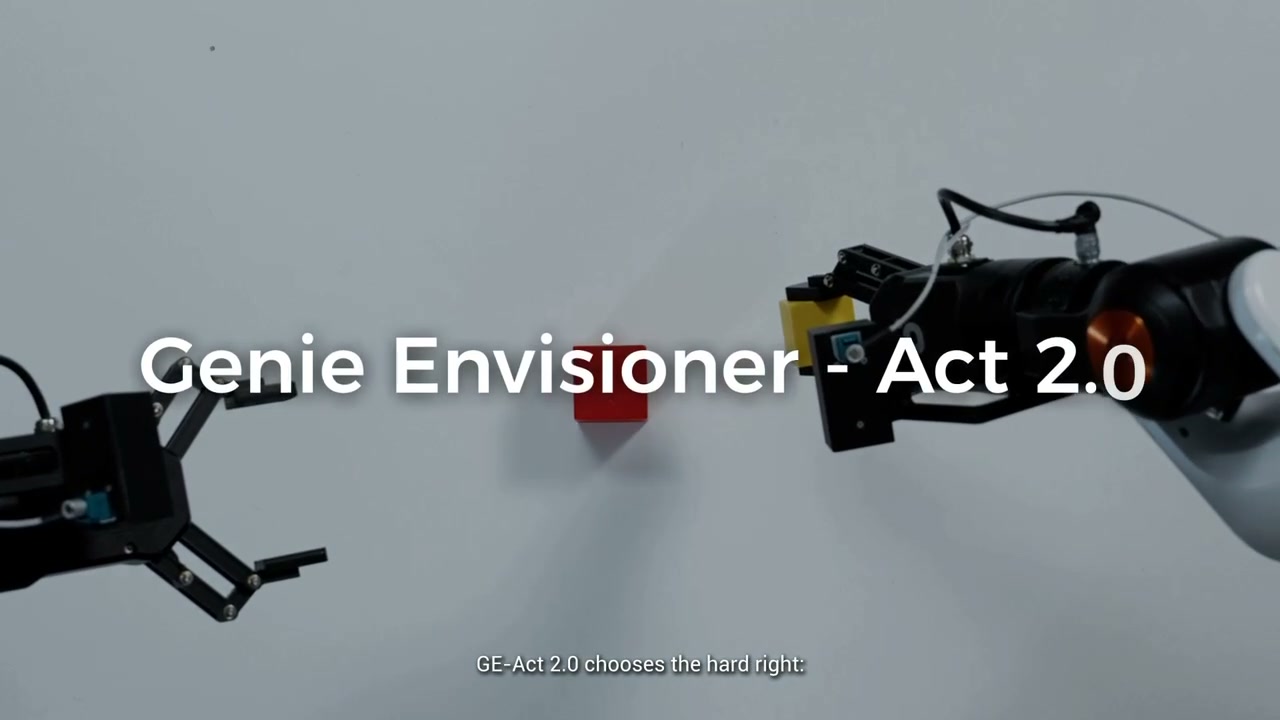
Bild ur AgiBots presentationsfilm för GE-Act 2.0 [1]
Om GE-Act 2.0[1][2][3]
GE-Act 2.0 (Genie Envisioner Act 2.0) är en så kallad världs- och handlingsmodell för robotarmar från AgiBot. Den förutser först hur framtiden ska se ut, alltså hur scenen ser ut när uppgiften är gjord, och räknar sedan ut vilka rörelser som behövs för att komma dit. Till skillnad från många liknande modeller bygger den inte på en färdig videogenerator, utan alla delar är tränade från grunden på data från robotar som hanterar föremål.
Modellen har tre delar. En komprimerare (CoAE) gör om varje kamerabild till bara 24 tokens men behåller det som spelar roll för rörelser och instruktioner. En planerare (SVP) skapar hela den framtida bildsekvensen i ett enda steg utifrån instruktionen och vad kameran ser. En tredje del (IDM) gör om nuläget och den förutsagda framtiden till konkreta armrörelser. Hela kedjan tar enligt AgiBot 104 millisekunder per rörelsesekvens på ett RTX 5090.
AgiBot har undersökt hur modellen blir bättre med mer data. När träningsdatan ökade från 300 till 30 000 timmar steg andelen lyckade försök på helt nya situationer från 17,1 % till 44,1 % på roboten G1-OP och från 13,4 % till 31,1 % på G2-90D, utan finjustering för enskilda uppgifter. Testerna omfattade 100 uppgifter i 20 färdighetsgrupper. Att G2-90D förbättrades så mycket, fast den stod för under 2 % av datan, tolkar forskarna som att kunskap förs över mellan olika robotar.
Artikeln och projektsidan är publicerade, men koden är markerad som "kommer snart" och inga modellvikter är släppta.
Det viktigaste[1][2]
- Förutser först hur scenen ska se ut och räknar sedan ut rörelserna som tar roboten dit.
- Alla delar är tränade från grunden på robotdata, inte byggda på en färdig videomodell.
- Enligt AgiBot steg andelen lyckade försök från 17,1 % till 44,1 % när träningsdatan ökade från 300 till 30 000 timmar.
- Enligt AgiBot tar hela kedjan 104 millisekunder per rörelsesekvens på ett RTX 5090.
- Koden är aviserad men inte släppt.
Källor
- [1] GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation ↗AgiBot Research Officiell sida ge-act-v2.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
- [2] GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation ↗arXiv Forskningsartikel arxiv.orgPublicerad 4 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.