InfiniSplat v2
En AI-modell som på en gång bygger en 3D-scen av några vanliga foton, med eller utan uppgifter om var kameran stod, så att man kan se scenen från nya vinklar.
- 3D
 1 / 8
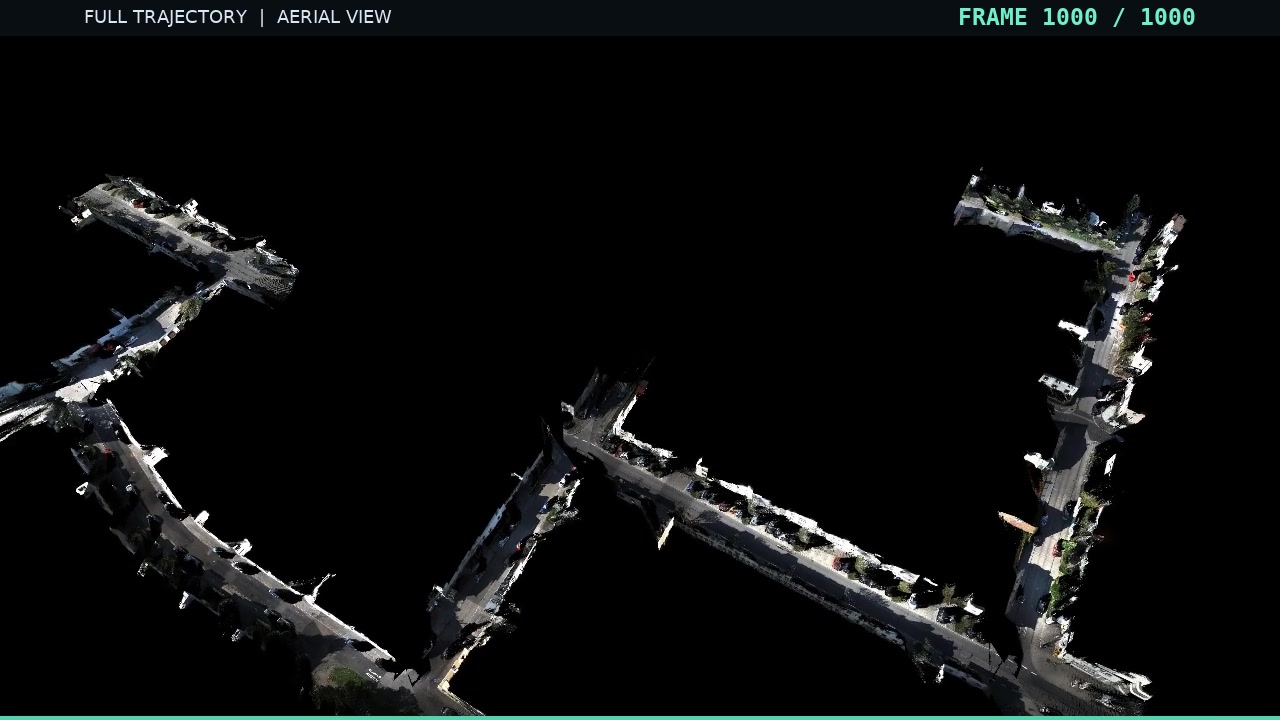
Bild ur KITTI-rekonstruktionen [1]
Om InfiniSplat v2[1][2][3][5][6]
InfiniSplat v2 (Analyzing and Improving Feed-Forward 3DGS from Any Views) är ett forskningsprojekt som gör om en samling bilder till en 3D-scen i formatet 3D Gaussian Splatting, där scenen byggs upp av miljontals små färgade, genomskinliga "fläckar". Modellen gör det i ett enda svep, utan den långa optimering per scen som sådana metoder traditionellt kräver. Den fungerar både när man vet var kameran stod för varje bild och när man inte vet det.
Forskarna har analyserat varför tidigare modeller av den här typen ger sämre bilder när man tittar på scenen från helt andra vinklar än fotona. Lösningen är en modell med två delar: en del för geometrin som hålls fryst och en del som lär sig hur fläckarna ska se ut. Under träningen justeras modellens uppskattade 3D-form mot de verkliga kamerapositionerna, och den tränas mot vyer som skiljer sig mycket från indata. Enligt forskarna lär sig modellen dessutom att göra felaktiga punkter genomskinliga, vilket minskar störningar i bilden.
Enligt artikeln når samma tränade modell bäst resultat bland de jämförda metoderna på sex dataset, både med och utan kamerapositioner. Med kända kamerapositioner minskar felmåtten LPIPS och DISTS med 25,8 respektive 32,9 procent jämfört med de starkaste jämförelsemetoderna. Modellen bygger vidare på Depth Anything 3 och har även visats rekonstruera över 1 000 bildrutor från KITTI-datasetet för självkörande bilar. Den tar 2–32 bilder som standard, och det finns verktyg för att göra om 360-graderspanoramabilder till 3D-scener.
Arbetet kommer från ZJU3DV-gruppen vid Zhejiang University tillsammans med Hello TransTech, Shenzhen University och Causa Robotics. Det är en uppföljare till InfiniSplat (v1), som gör 3D-scener av en enda bild.
Det viktigaste[1][2][3]
- Bygger en 3D-scen av vanliga bilder i ett enda svep, med eller utan kända kamerapositioner.
- Enligt forskarna bäst bland de jämförda metoderna på sex dataset, och med kända kamerapositioner minskar felmåtten LPIPS och DISTS med 25,8 respektive 32,9 procent.
- Särskilt inriktad på att ge bra bilder när man tittar från helt andra vinklar än fotona.
- Har visats rekonstruera en sekvens på över 1 000 bildrutor från KITTI-datasetet.
- Vikter, kod och en webbdemo finns öppet; organisationer måste registrera sig för att använda den.
- Kan också göra om 360-graderspanoramabilder till 3D-scener.
Källor
- [1] InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views ↗Zhejiang University m.fl. Officiell sida zju3dv.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] InfiniSplat ↗ZJU3DV, Zhejiang University Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [6] Quantum breakthrough, Gemini 4 Argon, Muse Wonder, Drama 3, MOSS Image, Krea 3, Ling 3.1: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 18 okt 2026 Läst 25 okt 2026
- [5] Quantum breakthrough, Gemini 4 Argon, MOSS Image, KLING 4, OpenAI spy, Muse Wonder: AI NEWS ↗AI Search Video youtube.comPublicerad 17 okt 2026 Läst 25 okt 2026
- [2] InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views ↗arXiv Forskningsartikel arxiv.orgPublicerad 14 okt 2026 Läst 25 okt 2026
- [4] InfiniSplat v2 ↗Hugging Face (Edisoneh) Modellkort huggingface.coPublicerad 11 okt 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.