Intern Lumina U2
En öppen diffusionsspråkmodell från Shanghai AI Laboratory som i en och samma modell svarar på frågor, förstår och redigerar bilder, skapar bilder och förstår video och 3D.
- Språkmodell
- Bildförståelse
- Bildgenerering
- Bildredigering
- 3D
- Multimodal
 1 / 4
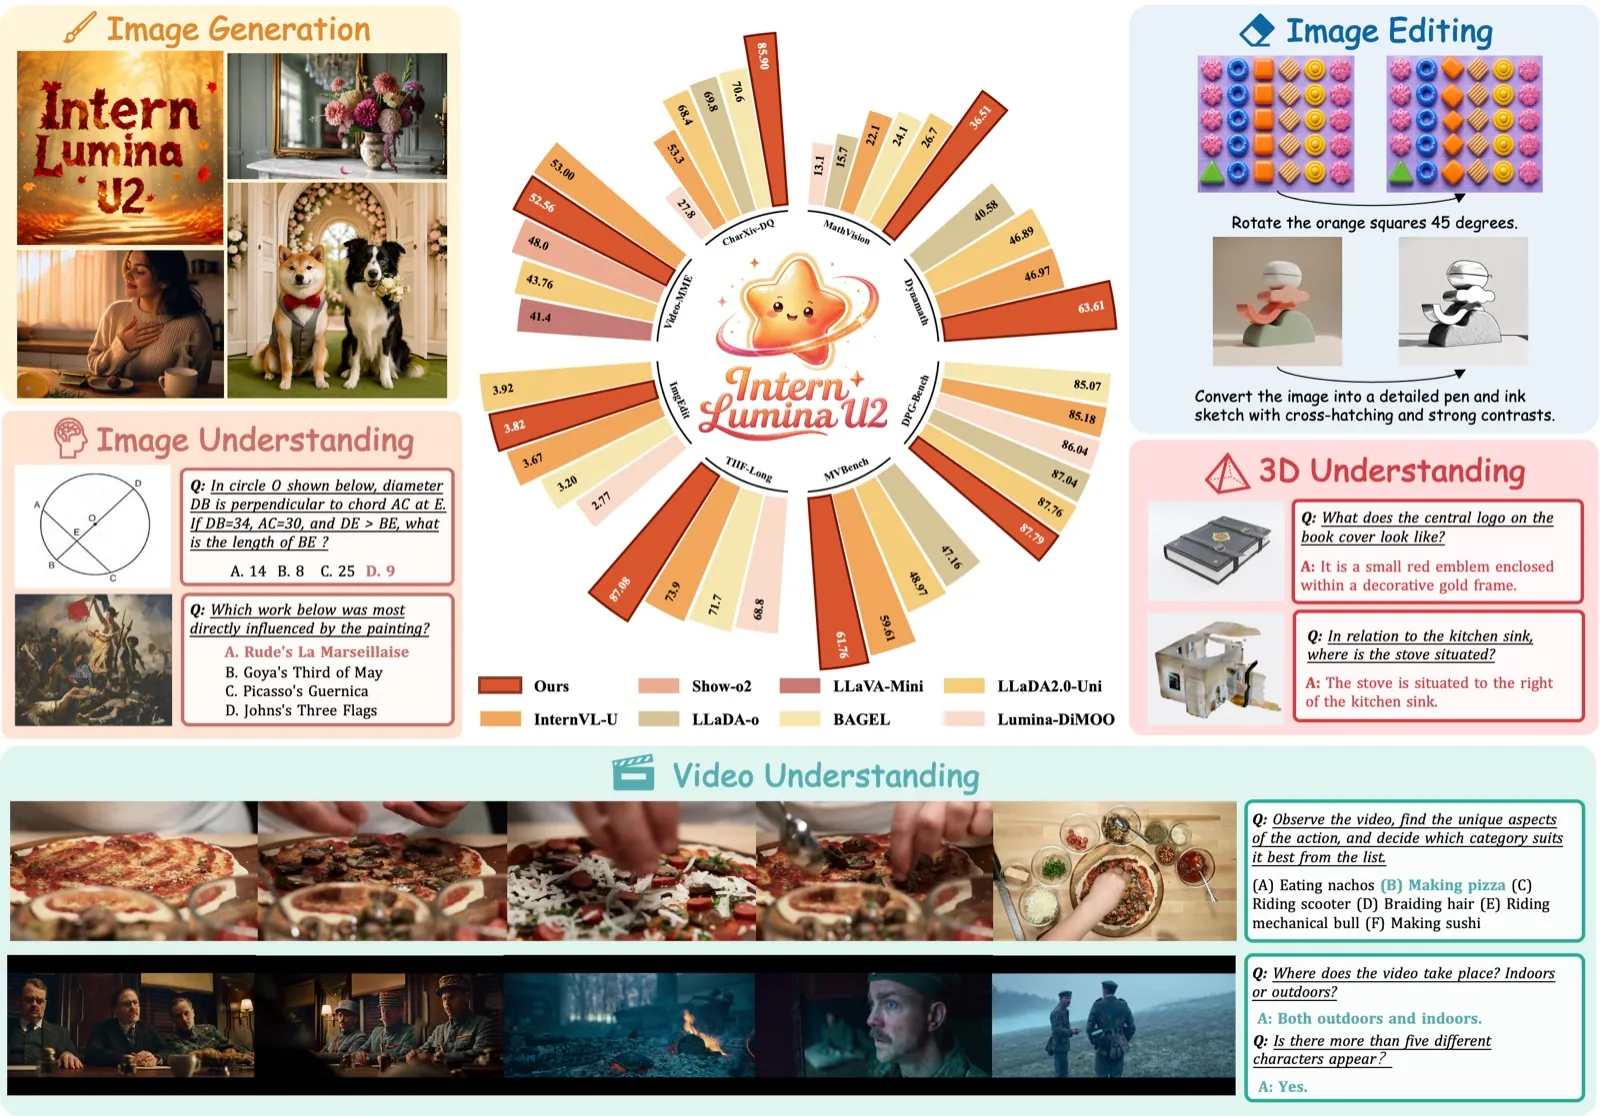
Översikt över vad Intern Lumina U2 kan göra [1]
Om Intern Lumina U2[1][2][3][4]
Intern Lumina U2 är en så kallad multi-codebook diffusion large language model. I stället för att skriva ett ord i taget, som vanliga språkmodeller, tar den fram svaret genom att stegvis fylla i det, som diffusionsmodeller gör med bilder. Modellen samlar text, bilder, video och 3D i ett och samma system: den kan svara på textfrågor, förstå och redigera bilder, skapa bilder och förstå video och 3D-modeller.
Arkitekturen består av en kodare och två utdatadelar som delar en gemensam MoE-baserad diffusionsspråkmodell. Varje position i en bild beskrivs med flera nivåer av diskreta koder (flera "kodböcker"). Alla positioner i bilden behandlas samtidigt, medan kodböckerna avkodas en i taget.
Projektsidan redovisar resultat för den släppta kontrollpunkten, som är tränad på Huaweis Ascend-kretsar. Enligt teamet leder den bland annat på CharXiv-DQ (85,9) och GenEval (89, delad förstaplats), medan andra modeller ligger före på till exempel ChartQA, RealWorldQA, MMMU, ImgEdit och Video-MME. Antalet parametrar anges inte.
Kod finns på GitHub och vikter på Hugging Face, båda under Apache 2.0. När AI Search skrev om modellen i september var den tekniska rapporten inte klar; den finns nu på arXiv (2610.20818).
Det viktigaste[1][2]
- En diffusionsspråkmodell som hanterar text, bilder, video och 3D i samma system.
- Kan svara på frågor, förstå, skapa och redigera bilder samt förstå video och 3D-modeller.
- Enligt teamet 85,9 på CharXiv-DQ (bästa jämförda modell 69,8) och 89 på GenEval.
- Andra modeller ligger enligt samma tabell före på bland annat ChartQA, MMMU, ImgEdit och Video-MME.
- Kontrollpunkten är tränad på Huaweis Ascend-kretsar; öppna vikter under Apache 2.0.
Källor
- [1] Intern Lumina U2 ↗Shanghai AI Laboratory Officiell sida internlm.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] Intern Lumina U2 (teknisk rapport) ↗arXiv Forskningsartikel arxiv.orgPublicerad okänt datum Läst 25 okt 2026
- [4] GPT 6 Astra, Claude Fable 5.1, Qwen 3.8 0902, Gemini 3.8 Flash, Muse Spark 1.3, Atlas: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 6 sep 2026 Läst 25 okt 2026
- [2] internlm/InternLumina-U2 ↗InternLM (Hugging Face) Modellkort huggingface.coPublicerad 1 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-06). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Shanghai AI Laboratory
- Atria Dawn 23 okt 2026
- Sage-A1.5 okt 2026
- Atria Dawn Preview sep 2026 · inaktuell