IQuest-Q1
En öppen språkmodell från IQuest byggd för AI-agenter som arbetar i terminalen: kod, verktyg och långa uppgifter, med 320 miljarder parametrar varav 15 miljarder aktiva.
- Språkmodell
- Kod
- Agenter
- Resonemang
 1 / 4
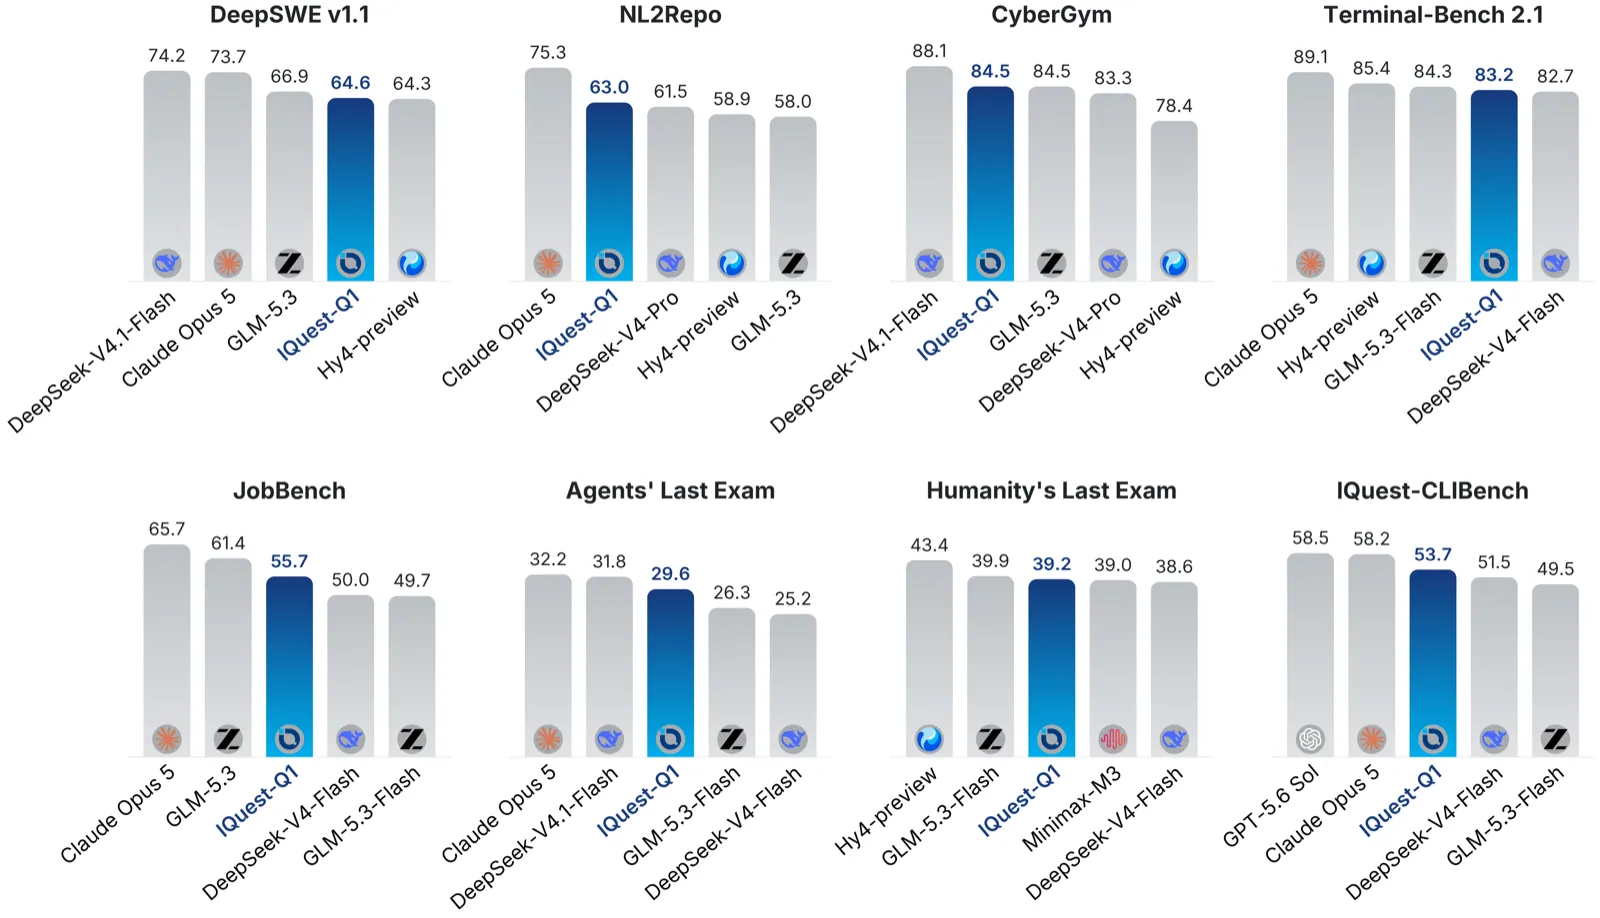
IQuests egna resultat jämfört med bland andra DeepSeek-V4 [2]
Om IQuest-Q1[1][2][3][4][5][6]
IQuest-Q1 är en öppen modell från IQuest Research, byggd för agenter som arbetar via kommandoraden. Den ska klara både programmering och allmänna uppgifter: skriva kod, använda verktyg, kontrollera resultat och rätta sig själv när något går fel under långa arbetspass. Enligt IQuest har modellen också deltagit i sin egen utveckling under mänsklig övervakning.
Det är en MoE-modell med cirka 320 miljarder parametrar totalt, varav ungefär 15 miljarder används per token (8 av 256 experter). Den kan läsa 524 288 tokens (512k) på en gång och hanterar bara text. Träningen skedde i tre steg: förträning där andelen koddata ökades i andra halvan, mellanträning med bredare data och längre kontext, och efterträning med finjustering och förstärkningsinlärning i flera olika agentmiljöer, där expertmodeller sedan slogs ihop.
IQuest jämför främst med DeepSeek-V4-Flash och DeepSeek-V4-Pro och rekommenderar att modellen körs i Claude Code eller Codex. Enligt IQuest får den 83,2 på Terminal-Bench 2.1, 64,6 på DeepSWE v1.1, 84,5 på CyberGym och 53,7 på deras egna test IQuest-CLIBench, där Claude Opus 5 får 58,2. Siffrorna är företagets egna.
Vikterna ligger på Hugging Face och ModelScope under en modifierad MIT-licens: den som använder modellen i en kommersiell produkt måste visa "IQuest-Q1" i gränssnittet. Den tekniska rapporten kom på arXiv den 22 oktober 2026.
Det viktigaste[1][2]
- Byggd för agenter som arbetar i terminalen med kod, verktyg och långa uppgifter.
- 320B parametrar totalt men bara cirka 15B aktiva per token, och 512k tokens kontext.
- Enligt IQuest 83,2 på Terminal-Bench 2.1 och 64,6 på DeepSWE v1.1.
- Enligt IQuest 53,7 på deras eget CLI-test, mot 51,5 för DeepSeek-V4-Flash och 58,2 för Claude Opus 5.
- Öppna vikter under modifierad MIT-licens.
Källor
- [1] IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems ↗IQuest Research Officiell sida iquestlab.github.ioPublicerad okänt datum Läst 25 okt 2026
- [2] IQuestLab/IQuest-Q1 ↗IQuest Research Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems ↗arXiv Forskningsartikel arxiv.orgPublicerad 22 okt 2026 Läst 25 okt 2026
- [6] Gemini 4 Argon, GPT 6.1 Sol, Dots, Claude Sonnet 5.5, Flux 3: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 4 okt 2026 Läst 25 okt 2026
- [5] Gemini 4, GPT 6.1, Plasma conjecture, Napoleon code solved, OpenAI Dots, Claude Sonnet 5.5: AI NEWS ↗AI Search Video youtube.comPublicerad 3 okt 2026 Läst 25 okt 2026
- [3] IQuestLab/IQuest-Q1 ↗IQuest Research (Hugging Face) Modellkort huggingface.coPublicerad 28 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-10-03, nyhetsbrev 2026-10-04). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.