Iris-3B
En öppen bildmodell med 3 miljarder parametrar från Speridlabs som skapar bilder direkt i pixlar, utan den separata komprimeringsmodell (VAE) som de flesta bildmodeller använder.
- Bildgenerering
- Bildredigering
- Kör lokalt
 1 / 7
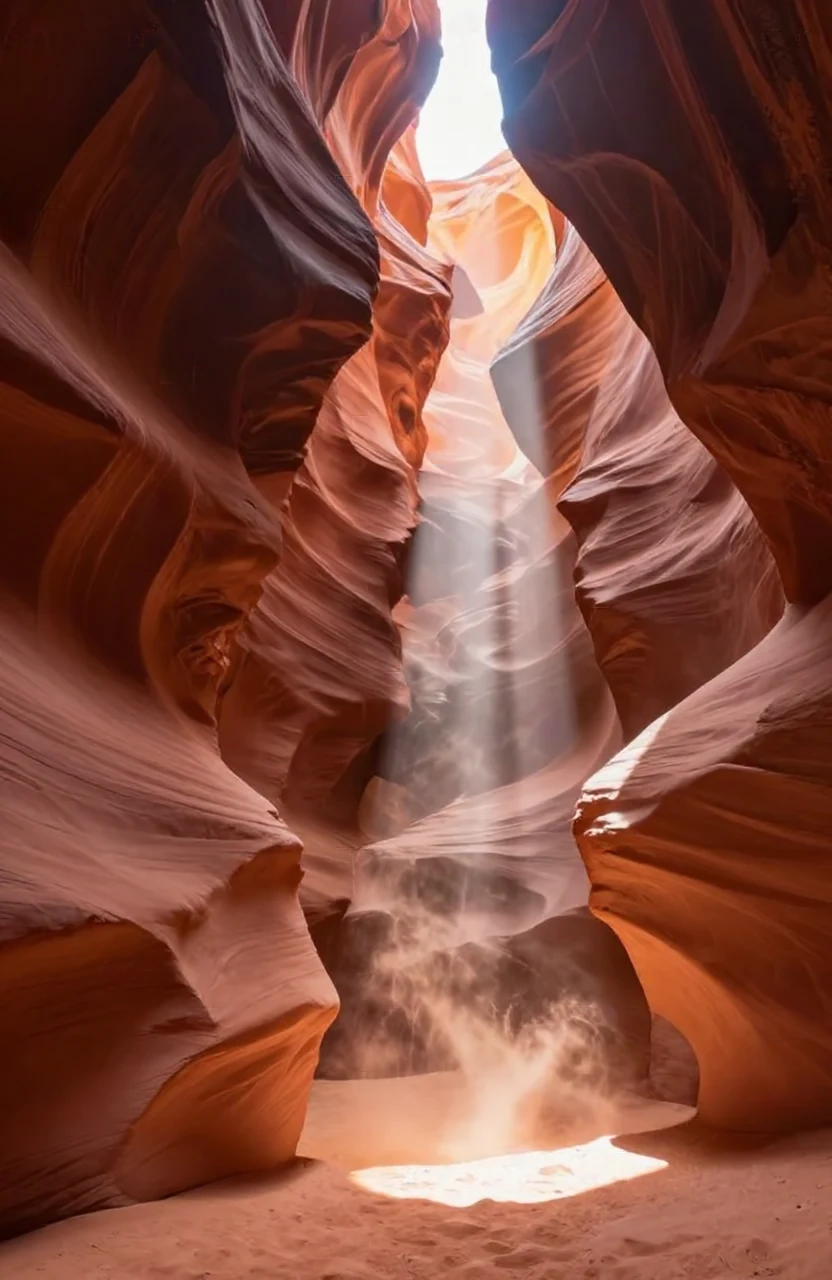
Exempelbild skapad med Iris-3B [1]
Om Iris-3B[1][2][4]
De flesta bildmodeller arbetar inte direkt med pixlar utan med en komprimerad version av bilden som en separat modell, en VAE, packar ihop och packar upp. Iris-3B skippar det steget och genererar bilden direkt i pixlar. Det är en transformer på 3 miljarder parametrar som tränas med flow matching. Bilden delas upp i rutor på 16 × 16 pixlar, och ett litet extra nätverk på slutet gör om varje ruta till färdiga pixlar. Texten tolkas av en fryst Qwen3-VL-4B, och modellen klarar alla bildformat upp till en megapixel.
Enligt Speridlabs är Iris-3B konkurrenskraftig mot ledande modeller som arbetar i komprimerad form. I deras egen tabell når den 0,798 på GenEval och 86,52 på DPG, före FLUX.1-dev (0,66 respektive 83,8), men efter betydligt större modeller som Qwen-Image 20B och Z-Image 6B på de flesta mått. Det finns också en snabb Turbo-variant som bara behöver fyra steg.
Forskarna menar att en bildgenerator också kan fungera som en allmän synmodell, i stället för till exempel DINOv2. De visar därför varianter av Iris-3B som är anpassade för att uppskatta djup i foton och för att skala upp och återställa bilder av dålig kvalitet. Vikterna ligger på Hugging Face under Apache 2.0, med kod på GitHub, demo på Hugging Face Spaces och en artikel på arXiv (2610.09450).
Det viktigaste[1]
- Skapar bilder direkt i pixlar, utan separat VAE.
- Enligt Speridlabs 0,798 på GenEval och 86,52 på DPG, före FLUX.1-dev men efter Qwen-Image 20B på de flesta mått.
- Turbo-varianten skapar bilder på fyra steg.
- Varianter finns för djupuppskattning och för uppskalning och återställning av bilder.
- Klarar alla bildformat upp till en megapixel; öppna vikter under Apache 2.0.
Källor
- [1]
- [3]
- [4] OpenAI math breakthroughs, AlphaProtein Novo, Botanic-1, Iris 3B, Kandinsky 6.0: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 11 okt 2026 Läst 25 okt 2026
- [5] New AI enzymes, 700+ math breakthroughs, AI for DNA mutations, room temp semiconductors: AI NEWS ↗AI Search Video youtube.comPublicerad 10 okt 2026 Läst 25 okt 2026
- [2] speridlabs/iris-3b ↗Speridlabs (Hugging Face) Modellkort huggingface.coPublicerad 5 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-10-10). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.