Kandinsky 6
En öppen modellfamilj från Kandinsky Lab som skapar korta videoklipp med ljud och tal i samma steg, från text eller en bild, under MIT-licens.
- Videogenerering
- Musik & ljud
- Multimodal
 1 / 4
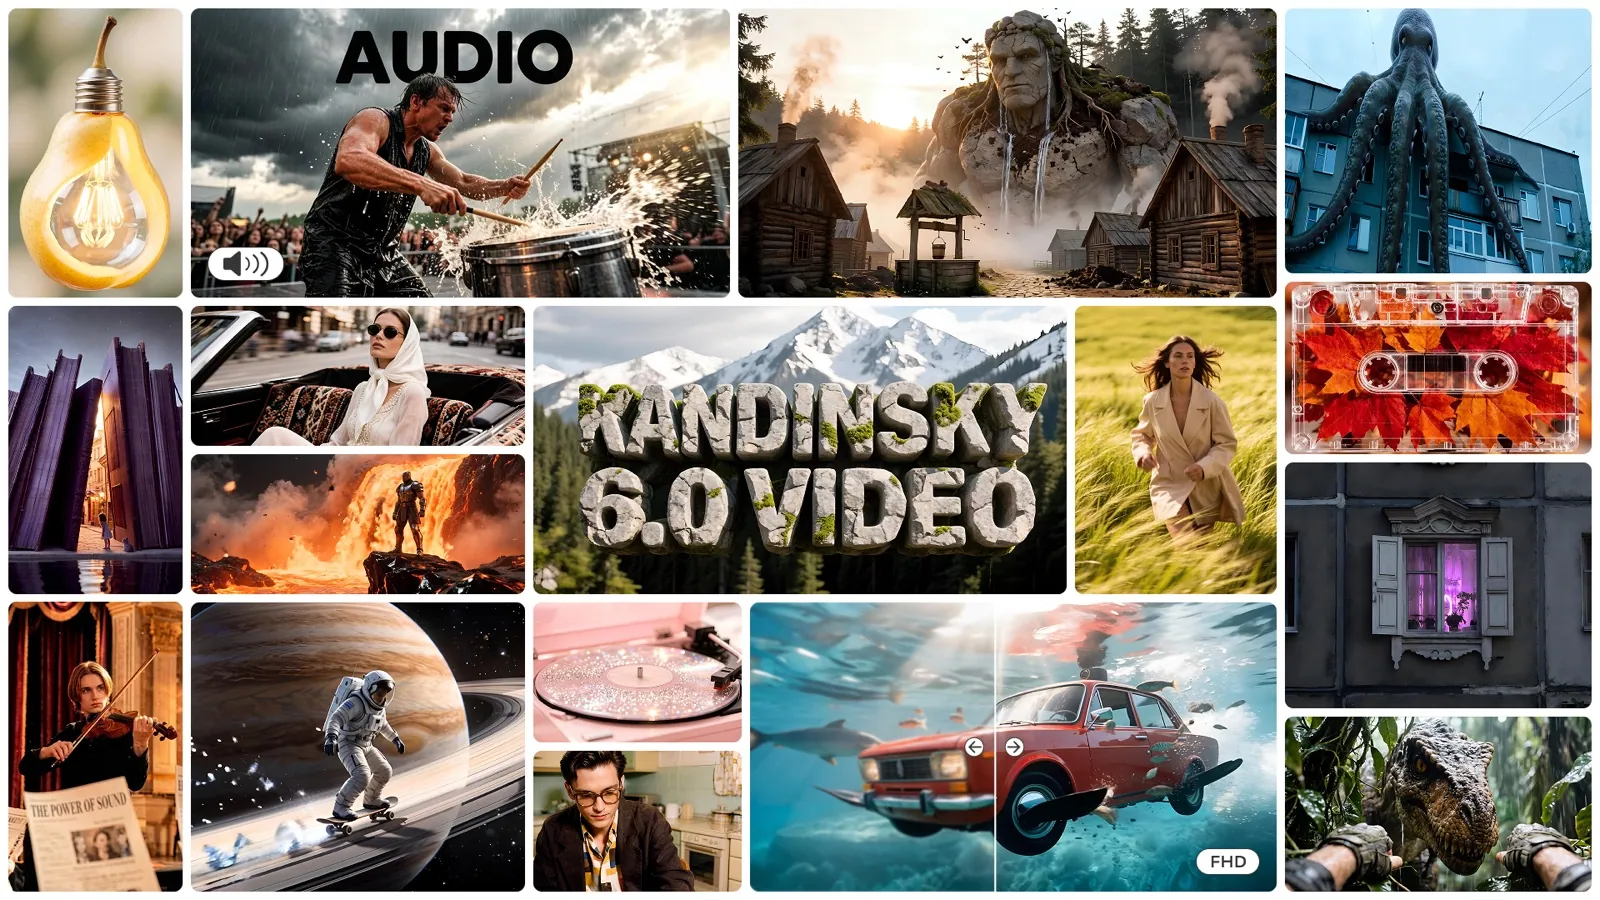
Bilder ur videoklipp skapade med Kandinsky 6.0 Video [2]
Om Kandinsky 6[1][2][3][4]
Kandinsky 6.0 Video är en familj av diffusionsmodeller som genererar video och ljud tillsammans, så att ljudet hör ihop med bilden. Man kan utgå från en text eller från en bild plus text. Klippen är fem sekunder långa med ljud i 44 kHz, och om någon pratar i klippet rör sig munnen i takt med talet. I prompten markerar man vad som ska sägas.
Familjen har två storlekar. Lite har 3 miljarder parametrar och är byggd för snabbhet, medan Pro har 29 miljarder och enligt Kandinsky Lab ger bättre rörelser och mer exakt styrning av kameran. Båda finns också i destillerade varianter som behöver 10 steg i stället för 50 och därför går flera gånger snabbare. Grundupplösningen är 480×864, och en separat uppskalningsmodell lyfter klippen till Full HD (1920×1080). Kandinsky Lab lyfter också fram att modellen förstår ryska och ryska kulturella begrepp.
Modellerna släpptes öppet den 6 oktober 2026 under MIT-licens och finns på Hugging Face och GitHub, med stöd i Diffusers, ComfyUI, vLLM-Omni, SGLang och FastVideo. Det krävs ett NVIDIA-grafikkort. Enligt Kandinsky Lab tar ett femsekundersklipp med ljud från Lite Distill cirka 31 sekunder på ett H100-kort och cirka 68 sekunder på ett RTX 4090, medan den största varianten, Pro i Full HD, tar runt 400 sekunder på H100. Det går också att prova Pro Distill i en demo på Hugging Face.
Det viktigaste[1][3]
- Skapar video och ljud tillsammans, med tal där munrörelserna följer orden.
- Två storlekar: Lite med 3 miljarder och Pro med 29 miljarder parametrar.
- Femsekundersklipp i 480×864 som kan skalas upp till Full HD med en separat modell.
- Enligt Kandinsky Lab tar ett klipp med Lite Distill cirka 31 sekunder på H100 och cirka 68 sekunder på RTX 4090.
- Öppna vikter under MIT-licens, med stöd i Diffusers, ComfyUI, vLLM-Omni, SGLang och FastVideo.
Källor
- [3] Kandinsky 6.0 Video ↗Kandinsky Lab Officiell sida kandinskylab.aiPublicerad okänt datum Läst 25 okt 2026
- [4] OpenAI math breakthroughs, AlphaProtein Novo, Botanic-1, Iris 3B, Kandinsky 6.0: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 11 okt 2026 Läst 25 okt 2026
- [5] New AI enzymes, 700+ math breakthroughs, AI for DNA mutations, room temp semiconductors: AI NEWS ↗AI Search Video youtube.comPublicerad 10 okt 2026 Läst 25 okt 2026
- [1] kandinskylab/kandinsky-6 ↗Kandinsky Lab Officiell sida github.comPublicerad 6 okt 2026 Läst 25 okt 2026
- [2] Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation ↗Kandinsky Lab (arXiv) Forskningsartikel arxiv.orgPublicerad 4 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-10-11). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.