LeapTalk
En metod som gör pratande ansikten från en bild och en ljudfil i realtid, med upp till 200 bilder per sekund på ett grafikkort och stabil identitet även i långa videor.
- Videogenerering
- Animation & rörelse
 1 / 5
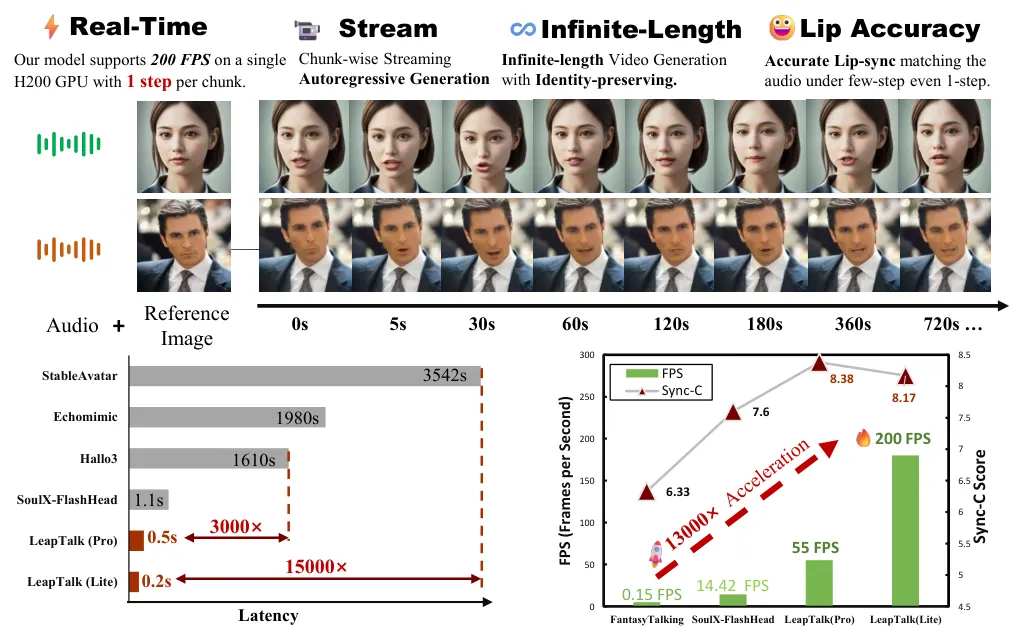
Översikt: från ljud och porträttbild till strömmad video med stabil identitet [2]
Om LeapTalk[1][2][3][5]
LeapTalk genererar så kallade talking heads: utifrån en porträttbild och ett tal-ljud skapas en video där personen i bilden pratar med läpparna i takt med ljudet. Videon strömmas bit för bit och kan i princip vara hur lång som helst.
Problemet forskarna angriper är en avvägning mellan fart och kvalitet. Diffusionsmodeller ger bra bild men kräver många beräkningssteg och klarar därför inte realtid, medan snabba metoder som bygger videon bit för bit ofta driver iväg, så att ansiktet sakta förändras och fel byggs på. LeapTalk använder en så kallad Brownsk brygga, där varje videobit utgår från den ursprungliga porträttbilden i stället för från brus. Det håller identiteten stabil över tid. En större lärarmodell destilleras sedan till en elevmodell som bara behöver ett enda beräkningssteg per videobit, och en ljudstyrd vägledning håller läpprörelserna i synk.
Enligt forskarna når metoden upp till 200 bilder per sekund på ett enda Nvidia H200-kort i sin lätta variant, med hög bildkvalitet och jämn video. Modellen bygger på SoulX-FlashHead-1.3B som basmodell; LeapTalk-vikterna (LoRA och tillhörande delar) finns på Hugging Face under Apache 2.0, och koden finns på GitHub.
Arbetet kommer från School of Artificial Intelligence vid Shanghai Jiao Tong University och Harbin Institute of Technology.
Det viktigaste[1][2][3]
- Pratande ansikte från en bild och ett ljud, strömmat i realtid.
- Enligt forskarna upp till 200 bilder per sekund på ett enda H200-kort, med ett beräkningssteg per videobit.
- Utgår hela tiden från porträttbilden, vilket håller ansiktet stabilt i långa videor.
- Ljudstyrd vägledning håller läpprörelserna i synk trots få beräkningssteg.
- Kod och vikter öppna under Apache 2.0.
Källor
- [1] LeapTalk: Breaking the Latency–Quality Trade-off in Talking Head Generation ↗Shanghai Jiao Tong University och Harbin Institute of Technology Officiell sida zhangrongxiang.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] LeapTalk: Breaking the Latency–Quality Trade-off in Talking Head Generation ↗GitHub (zhangrongxiang) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [5] WeatherNext, Xiaomi Robotics, Qwen 3.8, Wan Animate 2, SymphonyGen: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 9 aug 2026 Läst 25 okt 2026
- [2] LeapTalk: Breaking the Latency-Quality Trade-off in Talking Head Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 29 jul 2026 Läst 25 okt 2026
- [4] z-rx/leaptalk ↗Hugging Face (z-rx) Modellkort huggingface.coPublicerad 29 jul 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-09). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.