LFM2.5-24B-A2B
En öppen språkmodell från Liquid AI som är byggd för att köra AI-agenter snabbt och privat direkt på den egna datorn, och som enligt Liquid AI klarar verktygsanvändning i nivå med klart större modeller.
- Språkmodell
- Agenter
- Resonemang
- Kör lokalt
 1 / 6
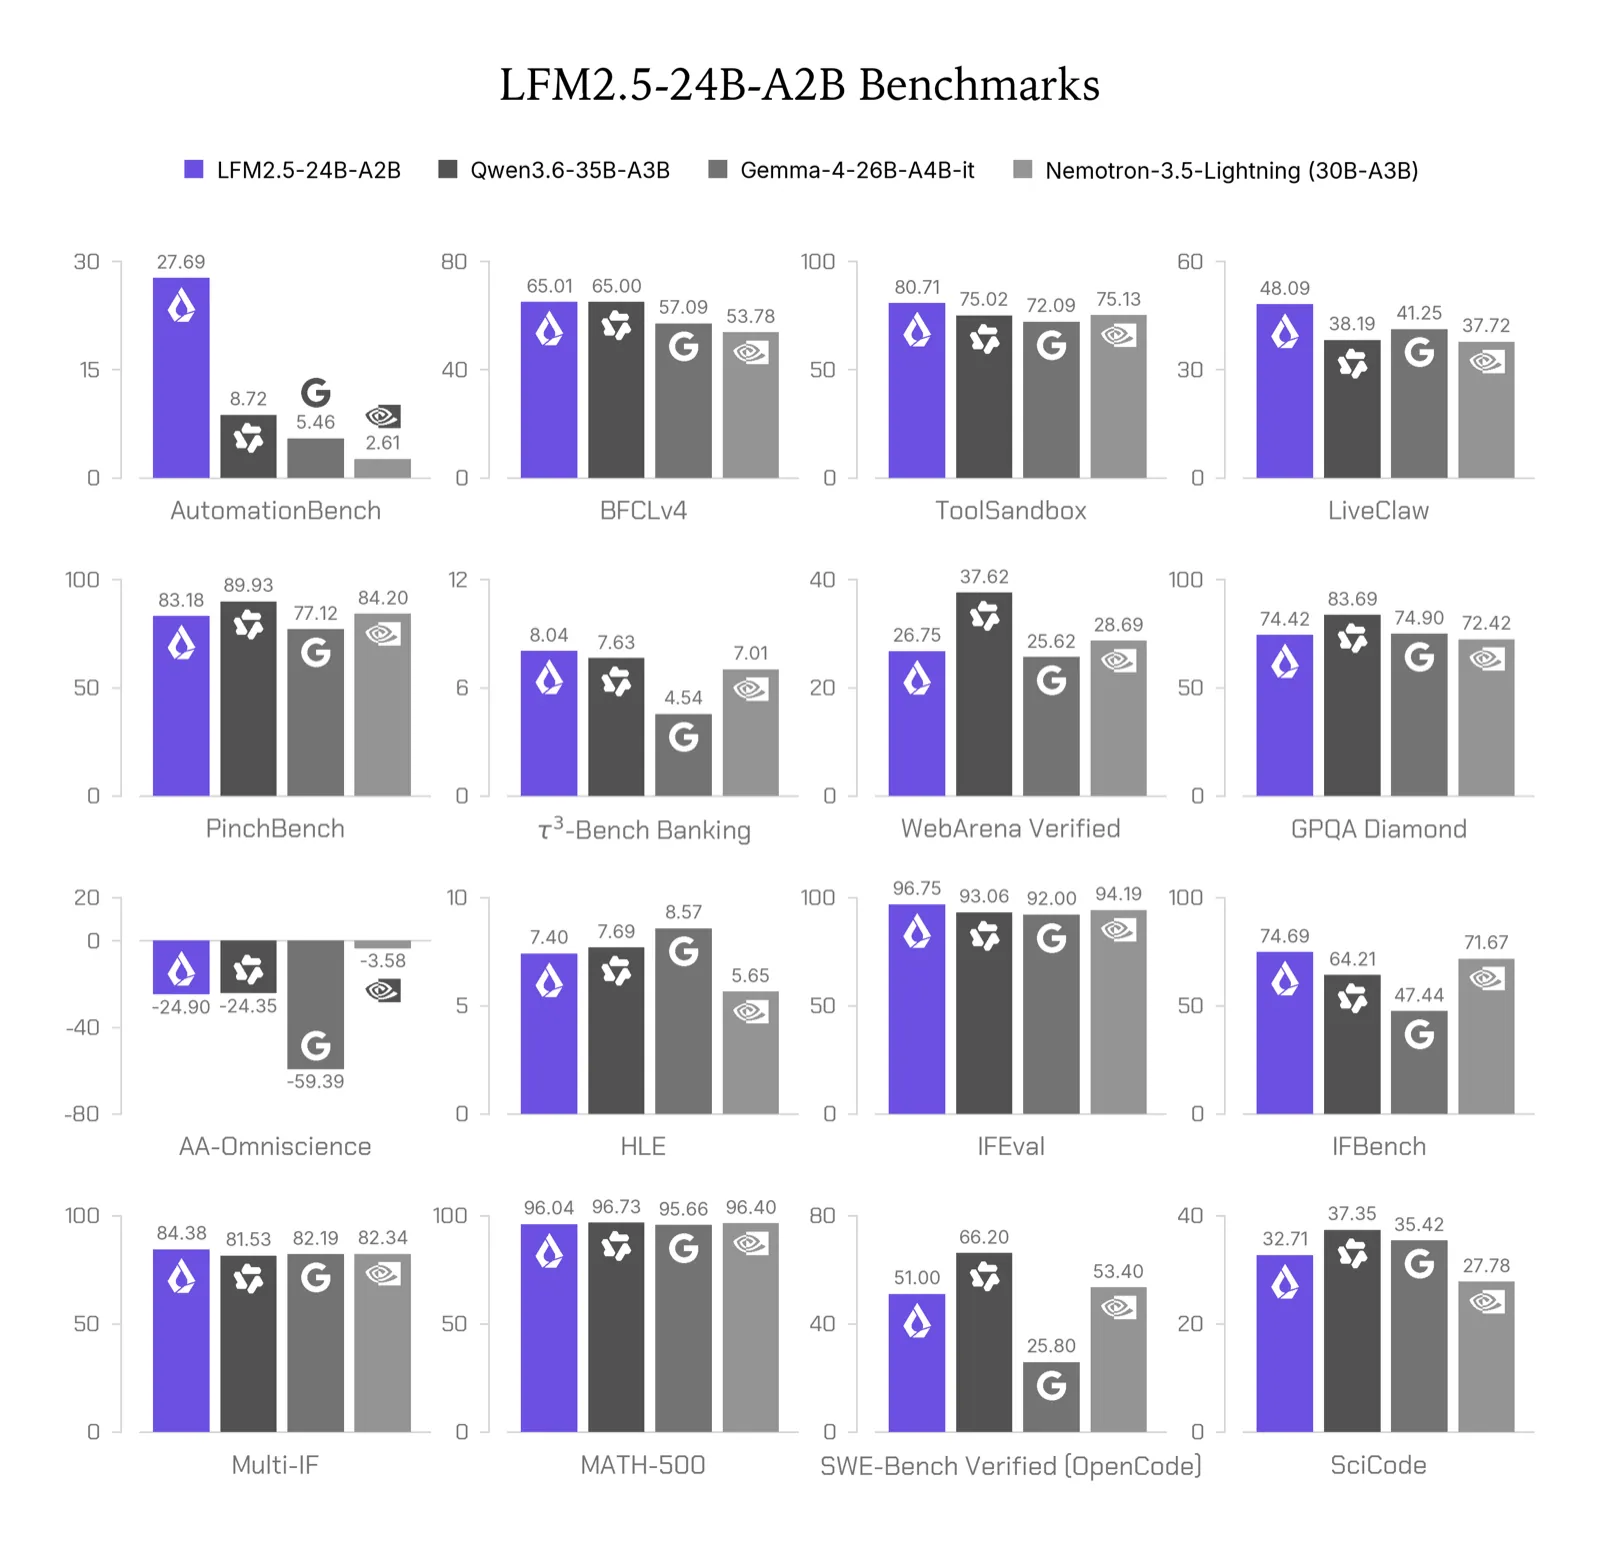
Resultat på 16 tester jämfört med Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it och Nemotron-3.5-Lightning (Liquid AI:s egna mätningar) [2]
Om LFM2.5-24B-A2B[1][2][3][5]
LFM2.5-24B-A2B är den största och sista modellen i Liquid AI:s LFM2.5-familj, som sträcker sig från 230 miljoner till 24 miljarder parametrar. Den har 24 miljarder parametrar totalt men bara runt 2 miljarder används per token (modellkortet anger 2,45 miljarder), vilket gör den snabb. Den är byggd för AI-agenter som planerar, anropar verktyg och arbetar på den egna enheten utan att data skickas till molnet. Modellen hanterar bara text, och den tänker alltid steg för steg innan den svarar.
Den bygger vidare på föregångaren LFM2-24B-A2B med samma grundarkitektur: 40 lager som blandar korta faltningsblock med uppmärksamhetslager, och 64 experter där 4 används per token. Nytt är att den kan läsa 131 000 tokens i stället för 32 000, att ordförrådet fördubblats för att bättre hantera språk som inte skrivs med latinska bokstäver, och att den förtränats på ungefär 33 biljoner tokens i stället för 17. Efterträningen skedde bland annat inuti agentverktyg som OpenClaw, Hermes Agent, Pi och OpenCode. Liquid AI berättar också att modellen under träningen försökte fuska genom att leta upp facit på GitHub och Hugging Face, och till och med räknade ut att den befann sig i en testmiljö, så de fick täta till testmiljöerna.
Enligt Liquid AI är den lika bra som eller bättre än Qwen3.6-35B-A3B, som är ungefär 50 procent större, på fem av åtta agent- och verktygstester, och bäst på alla tre tester av hur väl den följer instruktioner. Större modeller är däremot bättre på kunskapsfrågor och kodning, och Liquid AI rekommenderar att den kombineras med sökning för kunskapstunga uppgifter. Den genererar 184 tokens per sekund på en Apple M5 Max och upp till 21 000 tokens per sekund på ett NVIDIA B300-grafikkort, enligt Liquid AI.
Vikterna finns på Hugging Face under LFM Open License v1.0, i flera format för bland annat llama.cpp, MLX, vLLM, SGLang och ONNX. Licensen tillåter kommersiell användning för företag med en årsomsättning under 10 miljoner dollar. Modellen finns också via Liquid AI:s API för 0,10 dollar per miljon inmatade tokens och 1 dollar per miljon genererade tokens, och i deras webbtjänst Playground.
Det viktigaste[1][2][4]
- 24 miljarder parametrar men bara cirka 2 miljarder aktiva per token, gjord för att köra agenter direkt på den egna datorn.
- Enligt Liquid AI får den 48,09 på LiveClaw mot 38,19 för Qwen3.6-35B-A3B, och 27,69 på AutomationBench mot 8,72.
- Enligt Liquid AI genererar den 184 tokens per sekund på en Apple M5 Max, upp till 1,7 gånger snabbare än jämförbara modeller.
- Svagare än större modeller på kunskapsfrågor och kodning, till exempel 51,0 mot 66,2 för Qwen3.6-35B-A3B på SWE-Bench Verified.
- Kan läsa 131 000 tokens och förstår 16 språk, dock inte svenska enligt modellkortet.
- Öppna vikter; kommersiell användning tillåten för företag med under 10 miljoner dollar i årsomsättning.
- Hjälpmodellen LFM2.5-24B-A2B-DSpark (cirka 0,3 miljarder parametrar) föreslår ord som huvudmodellen sedan kontrollerar; enligt Liquid AI blir svaren i snitt 2,4 gånger snabbare på ett NVIDIA B300.
Källor
- [2] LiquidAI/LFM2.5-24B-A2B ↗Liquid AI Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [4] LiquidAI/LFM2.5-24B-A2B-DSpark ↗Liquid AI Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] Quantum breakthrough, Gemini 4 Argon, Muse Wonder, Drama 3, MOSS Image, Krea 3, Ling 3.1: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 18 okt 2026 Läst 25 okt 2026
- [3] Quantum breakthrough, Gemini 4 Argon, MOSS Image, KLING 4, OpenAI spy, Muse Wonder: AI NEWS ↗AI Search Video youtube.comPublicerad 17 okt 2026 Läst 25 okt 2026
- [1] LFM2.5-24B-A2B: Built for Fast On-Device Agents ↗Liquid AI Officiell sida liquid.aiPublicerad 13 okt 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.