LLM-as-a-Verifier
Ett ramverk som låter en språkmodell bedöma andra AI-agenters arbete med finkorniga poäng i stället för bara godkänt eller underkänt, för kod, robotar och medicin.
- Agenter
- Kod
- Robotik
- Medicin & hälsa
 1 / 5
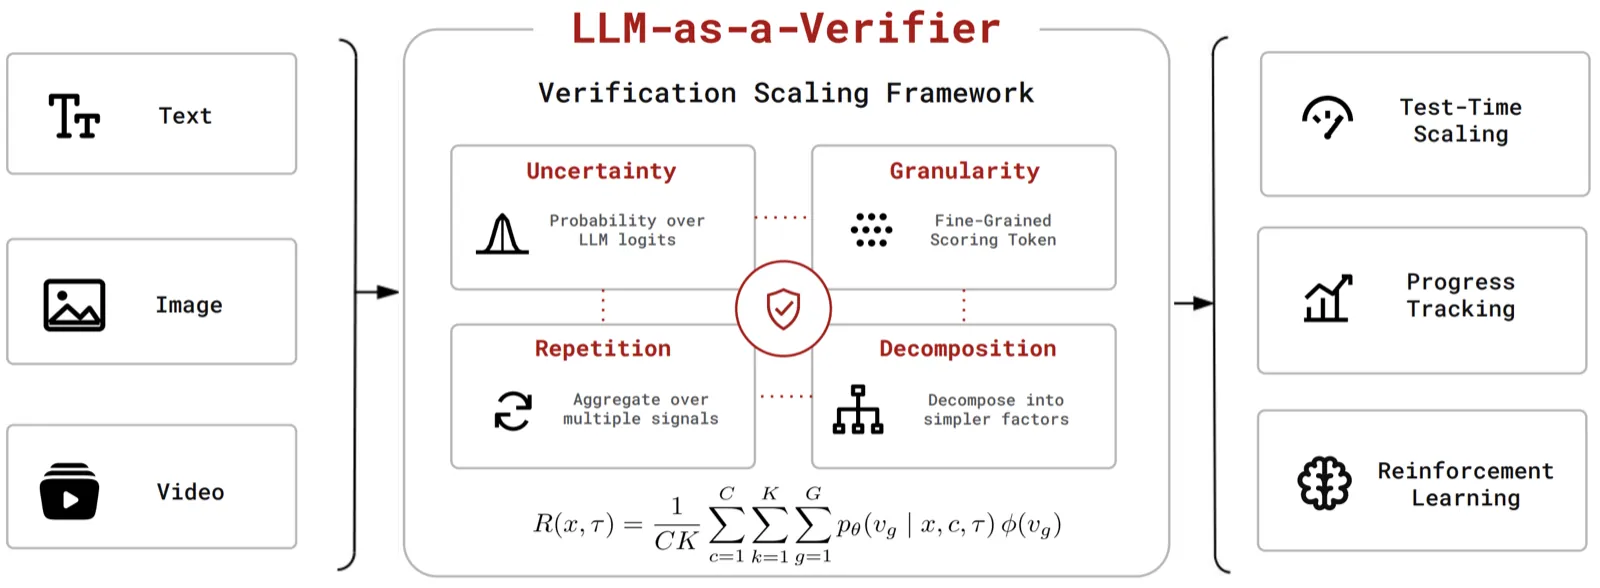
Översikt: LLM-as-a-Verifier ger finkorniga poäng för val av bästa svar, framstegsmätning och förstärkningsinlärning [1]
Om LLM-as-a-Verifier[1][2][3][4]
LLM-as-a-Verifier är ett ramverk för att kontrollera om en AI gör rätt, utan att någon modell behöver tränas. En språkmodell används som domare, men i stället för att bara svara "godkänt" eller "underkänt" ger den finkorniga poäng. Idén är enkel: använd en finare skala (till exempel 1–20 i stället för 1–5), räkna på hela sannolikhetsfördelningen över poängsiffrorna i stället för bara den mest sannolika, och skala upp genom att bedöma flera gånger och dela upp bedömningen i flera kriterier.
Poängen kan användas på tre sätt: för att välja det bästa av flera förslag (test-time scaling), för att följa hur långt en agent kommit under en uppgift (till exempel en robot som lägger en majskolv på en tallrik, eller en kodagent som installerar paket), och som belöningssignal vid förstärkningsinlärning. Forskarna beskriver verifiering som en ny axel att skala AI längs, vid sidan av förträning, efterträning och beräkning vid svarstillfället.
Enligt forskarna når metoden toppresultat inom kod, robotik och medicin: 86,5 procent på Terminal-Bench V2, 78,2 procent på SWE-Bench Verified, 87,4 procent på RoboRewardBench och 73,3 procent på MedAgentBench. Som belöningssignal gav den ungefär 1,8 gånger bättre dataeffektivitet vid finjustering av en robotpolicy på LIBERO och ungefär 1,1 gånger bättre vid matematikträning av Qwen3-8B.
Det finns ett Python-paket (pip install llm-verifier) med tre enkla funktioner: välja bästa kandidat, jämföra två kandidater och följa framsteg, samt ett tillägg för Claude Code. Koden är MIT-licensierad. Arbetet kommer från Stanford University, UC Berkeley och NVIDIA Research, med bland andra Chelsea Finn, Marco Pavone, Ion Stoica och Azalia Mirhoseini.
Det viktigaste[1][3]
- Finkorniga poäng i stället för godkänt/underkänt, utan extra träning och för alla sorters indata.
- Enligt forskarna 86,5 % på Terminal-Bench V2, 78,2 % på SWE-Bench Verified, 87,4 % på RoboRewardBench och 73,3 % på MedAgentBench.
- Kan följa en agents framsteg steg för steg, till exempel en robot eller en kodagent.
- Som belöning vid förstärkningsinlärning ungefär 1,8 gånger mer dataeffektiv på robotuppgifter, enligt forskarna.
- Python-paket med tre funktioner och ett tillägg för Claude Code, MIT-licens.
Källor
- [1] LLM-as-a-Verifier: A General-Purpose Verification Framework ↗Stanford University, UC Berkeley och NVIDIA Research Officiell sida llm-as-a-verifier.comPublicerad okänt datum Läst 25 okt 2026
- [3] llm-as-a-verifier ↗GitHub (llm-as-a-verifier) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] Deepseek Vision, Ornith 1.5, GEN 1.5, Happy Shrimp, SenseNova U1.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 23 aug 2026 Läst 25 okt 2026
- [2] LLM-as-a-Verifier: A General-Purpose Verification Framework ↗arXiv Forskningsartikel arxiv.orgPublicerad 6 jul 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-23). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Stanford University
- Contrastive Language Model (CLM-8B) sep 2026