LongCat-AudioDiT
Meituans öppna talsyntesmodell som gör tal av hög kvalitet från text och kan härma en röst från ett kort ljudklipp, under MIT-licens.
- Text till tal
- Röstkloning
 1 / 2
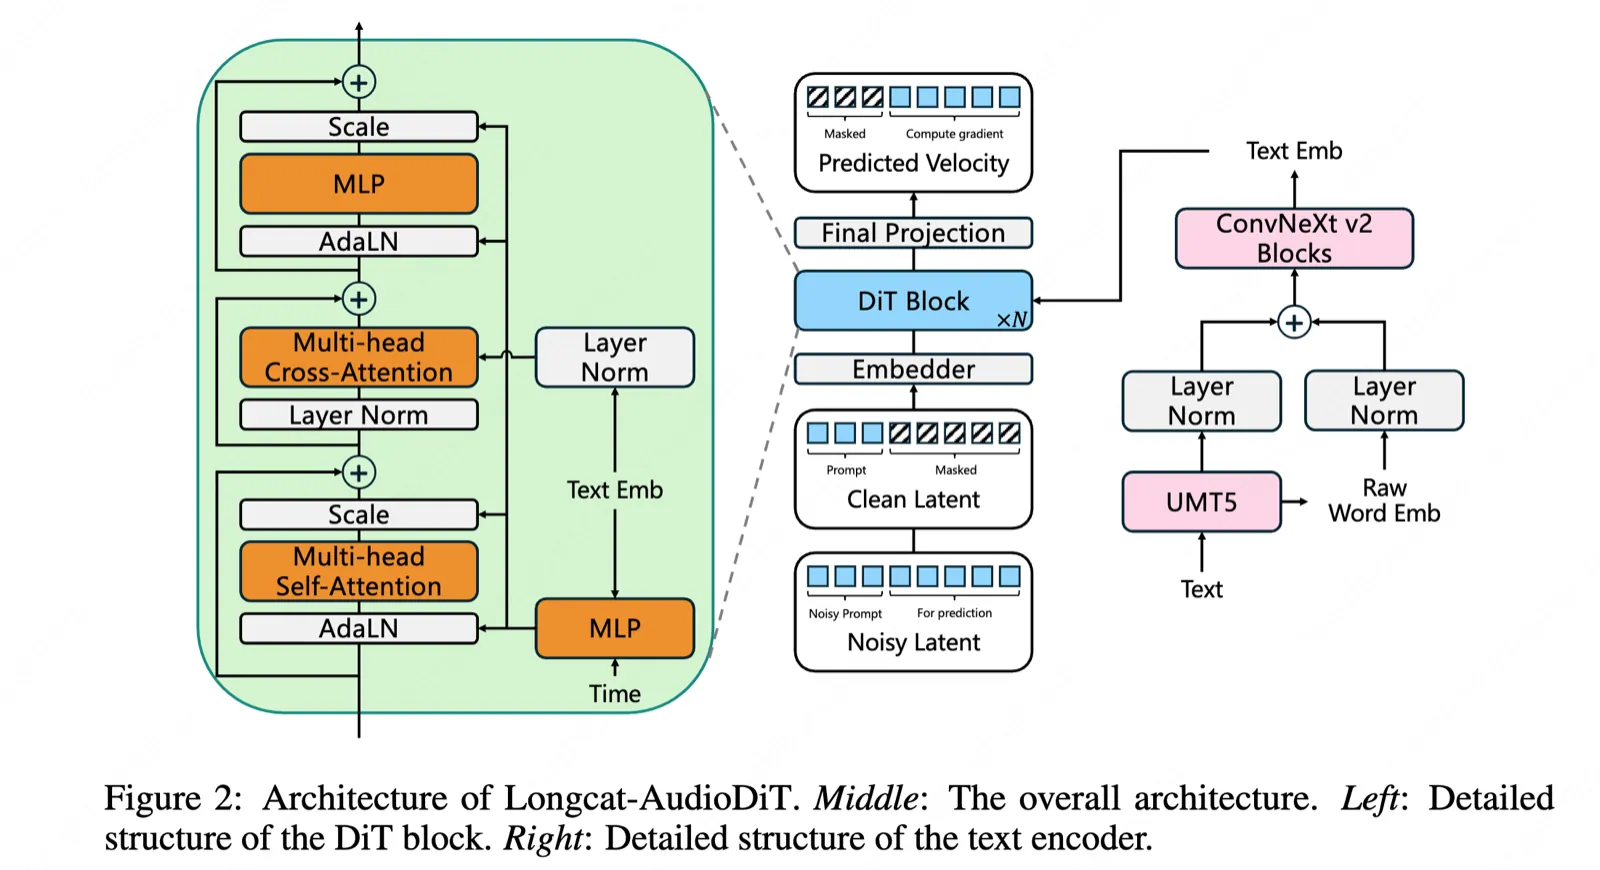
Arkitekturen bakom LongCat-AudioDiT [1]
Ljudexempel
- Exempel från demosidan: tal i en härmad röst [3]
Om LongCat-AudioDiT[1][2][5]
LongCat-AudioDiT är en modell för text till tal från LongCat-teamet hos det kinesiska företaget Meituan. Den finns i två storlekar, 1B och 3.5B, och kan både läsa upp text med en standardröst och härma en röst utifrån ett kort ljudklipp med tillhörande text, utan någon extra träning. Proven i forskningsartikeln gäller kinesiska och engelska.
Till skillnad från många andra talmodeller skapar den inte ljudet bit för bit i följd. Den använder en diffusionsmodell som arbetar direkt i en komprimerad version av själva ljudvågen, vilket enligt forskarna ger högre ljudkvalitet. Artikeln beskriver också en ny metod för att styra genereringen, kallad adaptive projection guidance.
Enligt Meituan når den största modellen toppresultat i röstlikhet på testsviten Seed: 0,818 på kinesiska och 0,797 på den svåra kinesiska delen. Andra modeller, som CosyVoice3.5, gör dock färre uttalsfel på vissa delar av testet. Vikterna och koden släpptes i slutet av mars 2026 under MIT-licens, och i oktober 2026 rättades ett fel i hur ljudvolymen normaliseras, vilket enligt teamet kan förbättra kvaliteten.
Det viktigaste[1][2]
- Härmar en röst från ett kort ljudklipp utan extra träning.
- Enligt Meituan röstlikhet 0,818 på Seed (kinesiska) och 0,797 på den svåra delen, med 3.5B-modellen.
- Andra modeller som CosyVoice3.5 gör färre uttalsfel på vissa delar av samma test.
- Finns i storlekarna 1B och 3.5B, med vikter och kod under MIT-licens.
Källor
- [1] meituan-longcat/LongCat-AudioDiT ↗Meituan LongCat Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [3] LongCat-AudioDiT demo ↗Meituan LongCat Officiell sida aria-k-alethia.github.ioPublicerad okänt datum Läst 25 okt 2026
- [5] Gemma 4, Claude Code leak, Qwen 3.6, Wan 2.7, OmniVoice, DreamLite, GLM-5V: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 5 apr 2026 Läst 25 okt 2026
- [2] LongCat-AudioDiT: High-Fidelity Diffusion Text-to-Speech in the Waveform Latent Space ↗arXiv Forskningsartikel arxiv.orgPublicerad 31 mar 2026 Läst 25 okt 2026
- [4] meituan-longcat/LongCat-AudioDiT-3.5B ↗Meituan LongCat Modellkort huggingface.coPublicerad 30 mar 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-05). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.