MiDashengLM-Gen
En öppen modell från Xiaomi som skapar hela ljudscener från en strukturerad textbeskrivning, där tal, musik, ljudeffekter och miljöljud blandas i samma klipp.
- Musik & ljud
- Text till tal
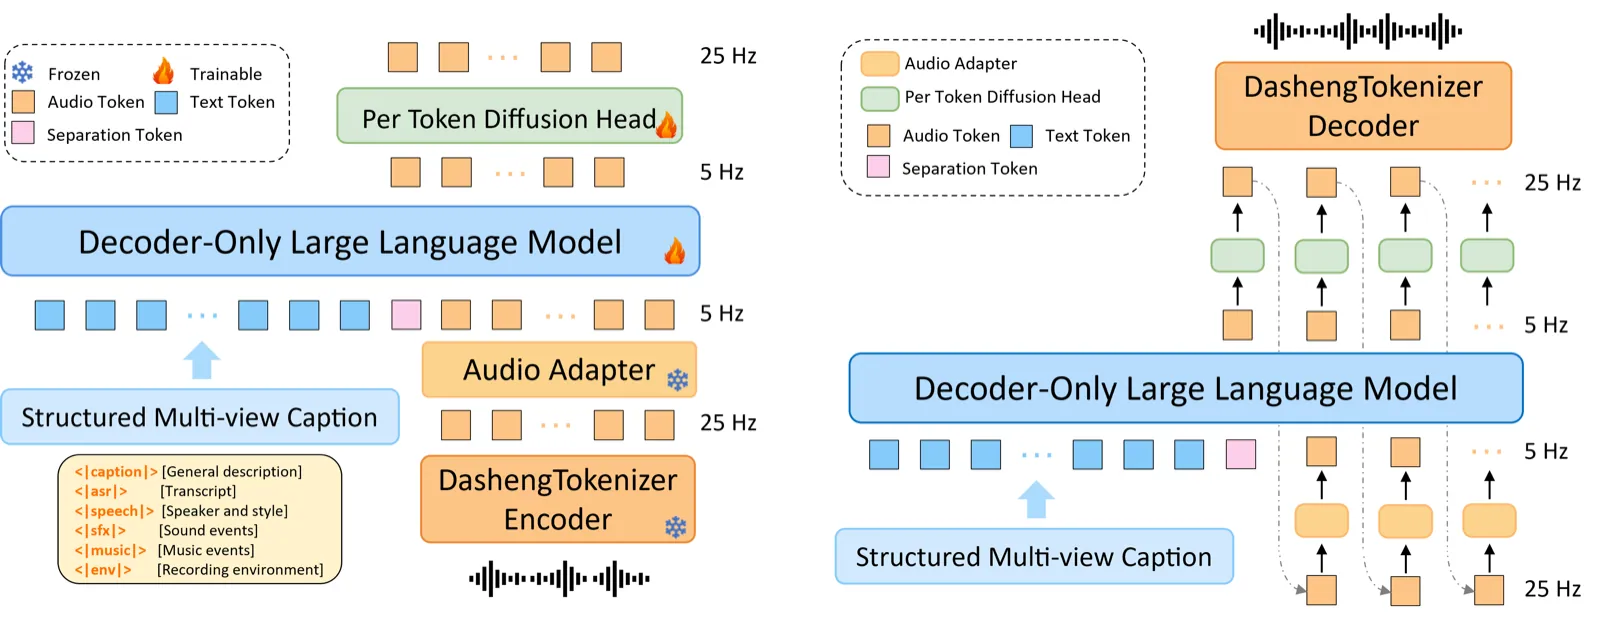
Så fungerar modellen: träning till vänster, generering bit för bit till höger [1]
Ljudexempel
Om MiDashengLM-Gen[1][2][3][4]
MiDashengLM-Gen kommer från Xiaomis ljudforskning (MiLM Plus) och skapar ljudklipp där flera sorters ljud hörs samtidigt: någon som pratar, musik, ljudeffekter och bakgrundsmiljö. Man beskriver scenen i olika fält, till exempel en övergripande beskrivning, exakt vad som ska sägas, hur rösten ska låta, vilka ljudeffekter och vilken musik som ska höras och vilken miljö det utspelar sig i. Ett exempel från Xiaomi är en komiker som levererar en poäng följt av publikskratt och en jazzorkester i en liten komediklubb.
Enligt forskarna är det första gången en och samma modell, tränad från början till slut, klarar allmän text-till-ljud på det här sättet. Tidigare lösningar har ofta kopplat ihop en separat textmodell med en separat ljudmodell, vilket gör att talet blir svårt att uppfatta. MiDashengLM-Gen bygger på språkmodellen Qwen3-1.7B och Xiaomis ljudkodare DashengTokenizer, och skapar ljudet bit för bit med en teknik som kallas flow matching. Modellen avgör själv när klippet ska ta slut. Ljudet blir 16 kHz mono.
Enligt Xiaomi sjunker andelen felaktigt uttalade ord på engelska (WER på Seed-TTS) från 12,15 procent för tidigare samlade modeller till 2,79 procent, nära renodlade talsyntesmodeller (1,24 procent). Modellen talar nio språk, engelska, kinesiska, spanska, portugisiska, ryska, franska, japanska, koreanska och tyska, och känslan i rösten går att styra.
Kod och vikter är öppna under Apache 2.0-licens, med vissa användningsbegränsningar (bland annat förbud mot militär användning och mot att kränka andras rättigheter).
Det viktigaste[1][3]
- Blandar tal, musik, ljudeffekter och miljöljud i samma klipp utifrån en strukturerad textbeskrivning.
- Enligt Xiaomi sjunker felaktigt uttalade ord på engelska från 12,15 till 2,79 procent jämfört med tidigare samlade modeller, nära renodlad talsyntes.
- Talar nio språk och känslan i rösten går att styra.
- Bestämmer själv hur långt ljudklippet ska bli.
- Öppna vikter och kod under Apache 2.0, med vissa användningsbegränsningar.
Källor
- [1] MiDashengLM-Gen: Unified Audio Scene Generation ↗MiLM Plus, Xiaomi Officiell sida xingws.github.ioPublicerad okänt datum Läst 25 okt 2026
- [4] Deepseek v4 0813, Qwen 3.8 27B, GLM 5.3, Grok 4.6, LTX 2.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 16 aug 2026 Läst 25 okt 2026
- [2] mispeech/midashenglm-gen ↗Xiaomi (mispeech) Modellkort huggingface.coPublicerad 12 aug 2026 Läst 25 okt 2026
- [3] MiDashengLM-Gen: Unified Audio Scene Generation via LLM-Driven Autoregressive Flow Matching ↗arXiv Forskningsartikel arxiv.orgPublicerad 12 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-16). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Xiaomi
- MiMo-V2.6 Pro / Flash 22 sep 2026
- Xiaomi-Robotics-1 3 aug 2026
- MiMo-V2.5-Pro 27 apr 2026 · inaktuell
- OmniVoice 1 apr 2026