MiniCPM5-2B
En liten öppen språkmodell på 2,5 miljarder parametrar för att köras lokalt, som enligt OpenBMB är bäst i sin storleksklass på kod, matte, långa texter, verktygsanvändning och agentuppgifter.
- Språkmodell
- Resonemang
- Kod
- Agenter
- Kör lokalt
 1 / 2
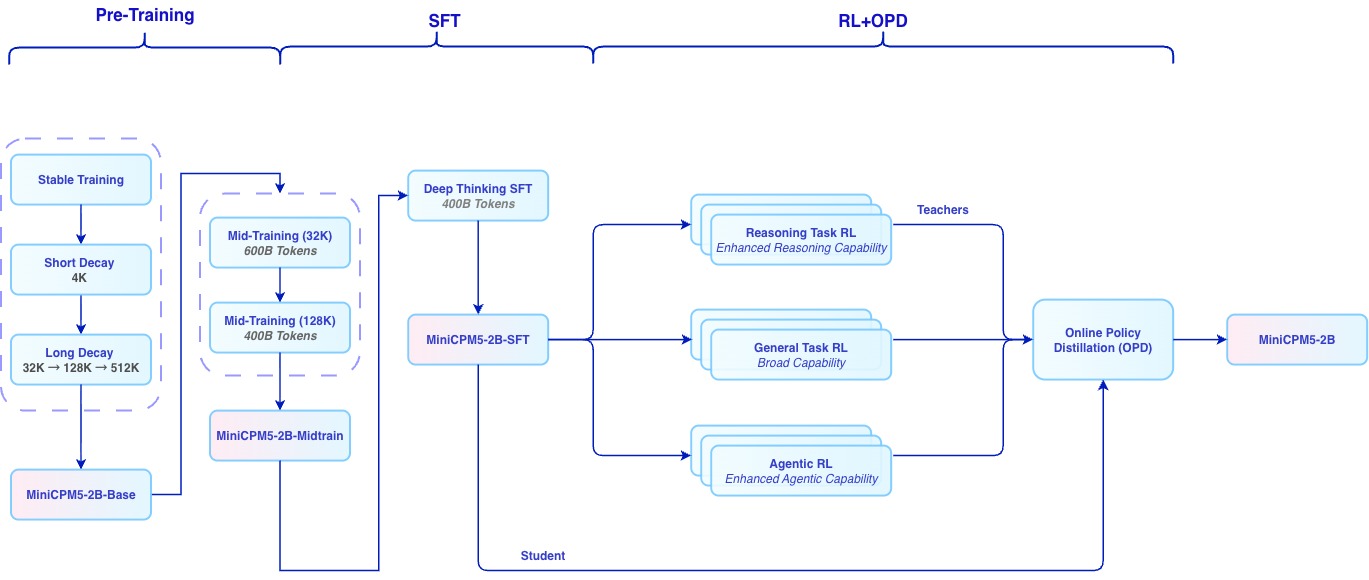
Så tränades MiniCPM5-2B: förträning, mellanträning och efterträning i flera steg [1]
Om MiniCPM5-2B[1][3]
MiniCPM5-2B är den andra modellen i OpenBMB:s MiniCPM5-serie, efter MiniCPM5-1B. Den är byggd för att köras lokalt på enheter och i miljöer med begränsade resurser, till exempel som lokal assistent, kodagent eller för arbetsflöden där modellen anropar verktyg. Den kan läsa upp till 131 072 tokens på en gång.
Modellen är en vanlig tät transformer med Llama-arkitektur och 2,5 miljarder parametrar, varav knappt 2 miljarder utanför inbäddningslagret. Efterträningen gjordes i tre steg: först 400 miljarder tokens övervakad träning för djupt resonerande, sedan förstärkningsinlärning och till sist en destillering (OPD) där förmågorna från 16 expertmodeller, varav 5 för agentuppgifter, slogs ihop.
Enligt OpenBMB får den i snitt 53,9 i deras jämförelse, före andra modeller i 2B-klassen som LFM2.5-2.6B (33,2) och även före större modeller som Qwen3.5-4B (51,1). Fördelarna syns mest inom kod, matte, långa texter, verktygsanvändning och agentuppgifter, till exempel 46,4 på SWE-bench Verified och 86,5 på AIME 2026. På allmänkunskap och instruktionsföljning ligger den däremot efter flera av jämförelsemodellerna.
Vikterna är öppna under Apache 2.0, och det finns färdiga versioner för llama.cpp, Ollama, LM Studio och Apples MLX. OpenBMB släpper också träningsdatan bakom modellen som en del av UltraData, bland annat en webbdatamängd för förträning, koddata, 500 000 exempel för agentträning och över 80 000 exempel för förstärkningsinlärning.
Det viktigaste[1]
- Enligt OpenBMB i snitt 53,9 i deras jämförelse, före alla 2B-modeller och även före större modeller som Qwen3.5-4B (51,1).
- Enligt OpenBMB 46,4 på SWE-bench Verified och 86,5 på AIME 2026.
- Läser upp till 131 072 tokens och är byggd för att köras lokalt.
- Svagare på allmänkunskap och instruktionsföljning än flera av jämförelsemodellerna.
- Öppna vikter under Apache 2.0; träningsdatan släpps också som en del av UltraData.
Källor
- [2] OpenBMB/MiniCPM ↗OpenBMB (GitHub) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [3] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
- [1] openbmb/MiniCPM5-2B ↗OpenBMB (Hugging Face) Modellkort huggingface.coPublicerad 6 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). [3]
Placeringar i topplistor
- #90 · 12
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från OpenBMB
- Self-Replay Fine-Tuning 12 okt 2026
- MiniCPM-V 4.7 okt 2026