MosaiChunk
Ett minnessystem för AI som gör långa videor, så att föremål och platser ser likadana ut när de dyker upp igen efter att ha varit ur bild en stund.
- Videogenerering
- Minne
 1 / 7
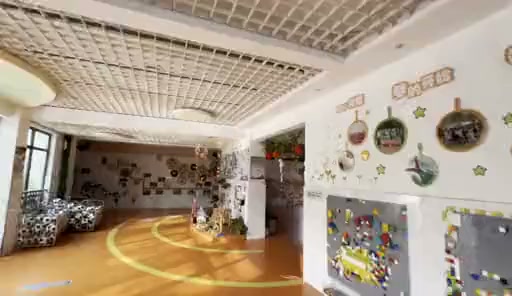
Lekrummet när kameran lämnar startpunkten [1]
Om MosaiChunk[1][2][3][5][6]
MosaiChunk (Compositing Spatio-Temporal Memory for Autoregressive Video Generation) är ett forskningsprojekt om ett välkänt problem hos AI-modeller som skapar långa videor bit för bit: de kan bara hålla en begränsad mängd av det de redan skapat i minnet. När ett föremål eller en plats försvinner ur bild och sedan kommer tillbaka har modellen ofta glömt detaljerna, så att exempelvis innehållet i en låda ser annorlunda ut när lådan öppnas igen.
Forskarnas idé är att i stället för att spara hela tidigare videoavsnitt plocka ut just de små bitar av minnet som hör till det som behövs, från olika platser i bilden och olika tidpunkter, och lägga ihop dem till en mosaik. Själva videomodellen ändras inte alls. Det enda som tränas är en liten "router" som väljer vilka minnesbitar som ska tas med inom en fast minnesbudget. Den tränas genom att efterlikna samma videomodell när den får tillgång till mer minne, så det behövs inga färdiga facitvideor.
Metoden har testats på två befintliga videomodeller: en version av MiniMax-H3 för text till video och LingBot-World-Infinity för bild till video. Forskarna har också byggt ett nytt test, RememBench, där föremål visas, göms i fem sekunder och sedan visas igen, eller där kameran vänder och återvänder till startpunkten. Enligt forskarna ger MosaiChunk genomgående bättre överensstämmelse vid återbesök än både enkel glidande minnesbuffert och hämtning av hela tidigare avsnitt, med samma minnesbudget.
Arbetet kommer från Cornell University, UC Berkeley, Harvard University och företaget Impossible, Inc. Förstaförfattaren Yiwen Zhang är från Cornell och gjorde en del av arbetet under en praktik på Impossible. Kod, routervikter och testdata finns öppet.
Det viktigaste[7][1][2][4]
- Obs: när den används tillsammans med MiniMax H3 gäller H3-licensen, som inte gäller i EU, Storbritannien, Sydkorea eller USA utan en separat licens från MiniMax.
- Hjälper videomodeller att komma ihåg hur föremål och platser såg ut efter att de varit ur bild.
- Själva videomodellen ändras inte, bara en liten router som väljer vilka minnesbitar som ska användas tränas.
- Enligt forskarna ger MosaiChunk med en videobits minne högre likhet vid återbesök än jämförelsemetoden MoC med två (CLIP 0,899 mot 0,841 för text till video).
- Nytt test, RememBench, med 100 text-till-video-exempel och 150 scener för bild till video.
- Fungerar med MiniMax-H3 (text till video) och LingBot-World-Infinity (bild till video).
- Vikterna är öppna men följer videomodellernas licenser, som delvis är icke-kommersiella.
Källor
- [1] MosaiChunk: Compositing Spatio-Temporal Memory for Autoregressive Video Generation ↗Cornell University, UC Berkeley, Harvard University och Impossible, Inc. Officiell sida mosaichunk.github.ioPublicerad okänt datum Läst 25 okt 2026
- [7] MiniMax H3 Community License Agreement ↗MiniMax Officiell sida huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [6] Quantum breakthrough, Gemini 4 Argon, Muse Wonder, Drama 3, MOSS Image, Krea 3, Ling 3.1: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 18 okt 2026 Läst 25 okt 2026
- [5] Quantum breakthrough, Gemini 4 Argon, MOSS Image, KLING 4, OpenAI spy, Muse Wonder: AI NEWS ↗AI Search Video youtube.comPublicerad 17 okt 2026 Läst 25 okt 2026
- [2] MosaiChunk: Compositing Spatio-Temporal Memory for Autoregressive Video Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 1 okt 2026 Läst 25 okt 2026
- [3] MosaiChunk: Compositing Spatio-Temporal Memory for Autoregressive Video Generation ↗GitHub (mosaichunk) Officiell sida github.comPublicerad 1 okt 2026 Läst 25 okt 2026
- [4] MosaiChunk ↗Hugging Face (mosaichunk) Modellkort huggingface.coPublicerad 1 okt 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.