MOSS-Image
Öppen kinesisk bildgenereringsmodell på 5 miljarder parametrar som är stark på text i bilder och låter dig bestämma exakt var saker och text ska hamna i bilden.
- Bildgenerering
- Vektorgrafik & design
- Kör lokalt
 1 / 6
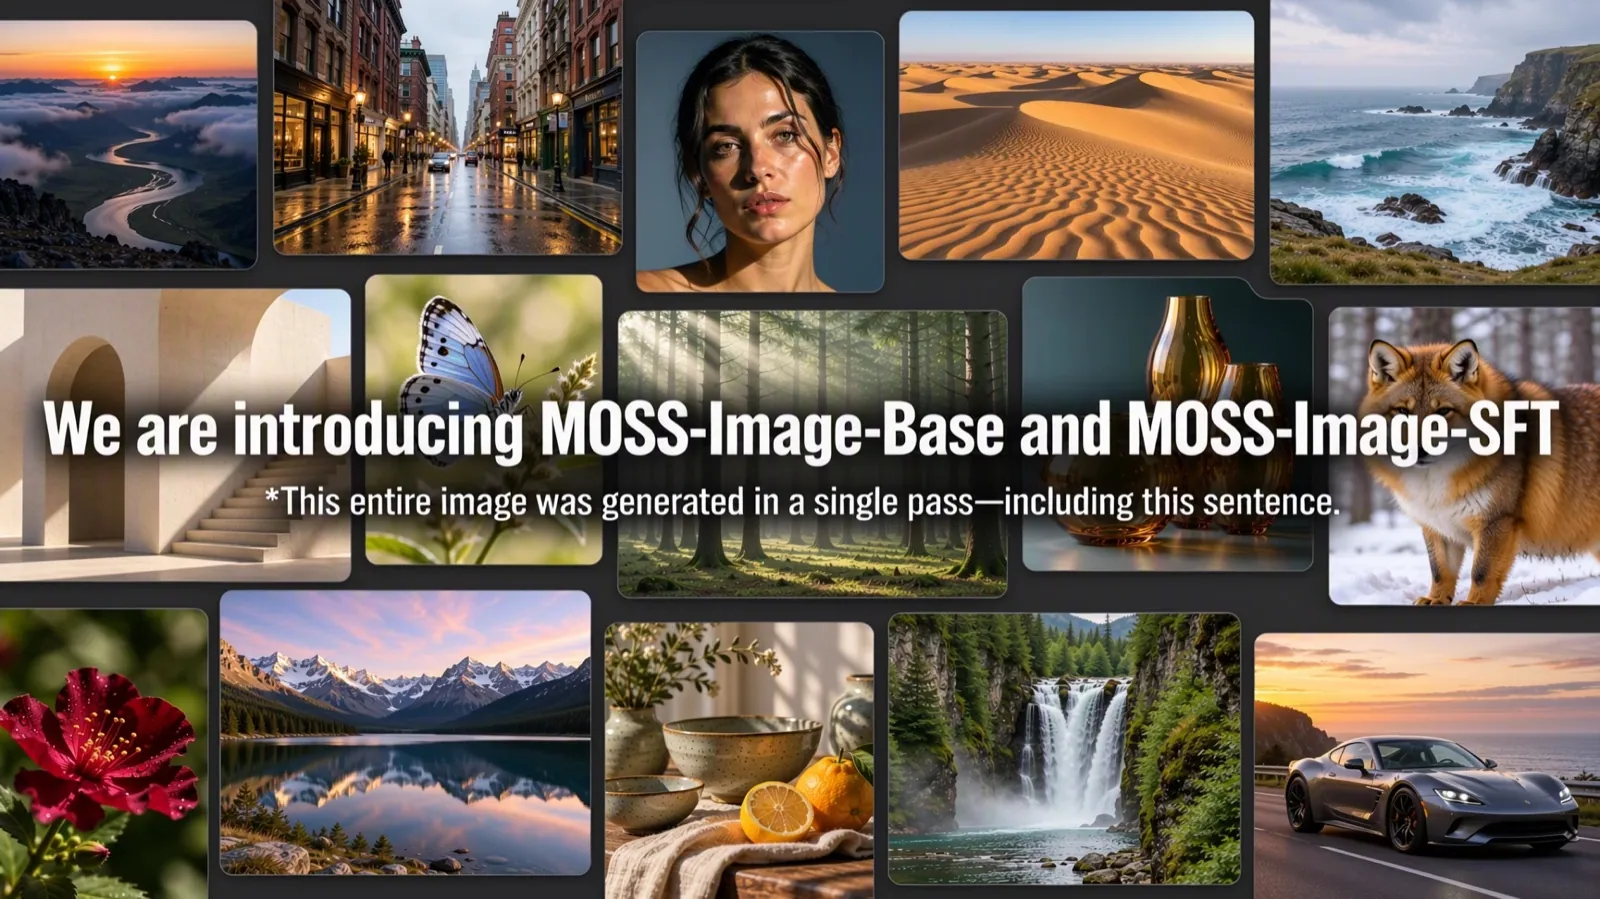
Lanseringsbilden, som enligt skaparna är genererad i ett enda steg, texten inräknad [2]
Om MOSS-Image[1][2][3][5][6][7]
MOSS-Image är en familj bildgenereringsmodeller från OpenMOSS, ett forskningsteam med rötter i Fudan-universitetet, Shanghai Innovation Institute och företaget MOSI Intelligence. Den tekniska rapporten står på MOSI.AI. Familjen består av två varianter: MOSS-Image-Base, grundmodellen, och MOSS-Image-SFT, som är finjusterad på noga utvald data och enligt skaparna ger tydligare och mer välordnad text.
Modellen är en diffusionsmodell på 5 miljarder parametrar som tränats från grunden. Det som skiljer den från många andra öppna bildmodeller är layoutstyrningen: i stället för bara en vanlig beskrivning kan man skicka in en strukturerad beskrivning (JSON) där varje objekt och textrad har en egen ruta som anger exakt var i bilden det ska placeras. Den klarar också långa beskrivningar på upp till 4 000 tokens, återger lång text på både engelska och kinesiska och kan göra både animerad stil och fotorealistiska bilder.
Till modellen hör ett verktyg som gör om en enkel bildidé till en detaljerad beskrivning eller layout. Enligt den tekniska rapporten når MOSS-Image bäst resultat bland modeller med öppna vikter på teamets eget test för lång text i bilder (LongLongTextBench), med 96,3 % i genomsnittlig täckning, och hamnar tvåa i deras test för hela bildsystem med layout (RealLayoutArena).
Vikterna är öppna under Apache 2.0-licensen och finns på Hugging Face och ModelScope. Modellen fungerar direkt i ComfyUI, SGLang och vLLM-Omni, och sedan 20 oktober finns den även via MOSI:s API. Den är gjord för att vara lätt att finjustera, och med ett verktyg från communityn räcker enligt skaparna 6 GB grafikminne för att träna en LoRA.
Det viktigaste[1][2][3]
- Layoutstyrning: man kan ange exakt var varje objekt och textrad ska placeras i bilden med rutor i en JSON-beskrivning.
- Enligt skaparna bäst bland öppna modeller på lång text i bilder (96,3 % täckning på LongLongTextBench), på både engelska och kinesiska.
- Liten för sin klass: 5 miljarder parametrar, och beskrivningar på upp till 4 000 tokens.
- Öppna vikter under Apache 2.0, med två varianter: Base och den finjusterade SFT.
- Fungerar i ComfyUI, SGLang och vLLM-Omni, och finns även via MOSI:s API sedan 20 oktober.
Källor
- [2] OpenMOSS/MOSS-Image ↗OpenMOSS (GitHub) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] OpenMOSS-Team/MOSS-Image-Base ↗OpenMOSS (Hugging Face) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] OpenMOSS · 开源大模型与通用人工智能研究 ↗OpenMOSS Officiell sida openmoss.aiPublicerad okänt datum Läst 25 okt 2026
- [7] Quantum breakthrough, Gemini 4 Argon, Muse Wonder, Drama 3, MOSS Image, Krea 3, Ling 3.1: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 18 okt 2026 Läst 25 okt 2026
- [6] Quantum breakthrough, Gemini 4 Argon, MOSS Image, KLING 4, OpenAI spy, Muse Wonder: AI NEWS ↗AI Search Video youtube.comPublicerad 17 okt 2026 Läst 25 okt 2026
- [1] MOSS-Image: Text-to-Image Generation with Native Layout Control ↗OpenMOSS Officiell sida openmoss.aiPublicerad 16 okt 2026 Läst 25 okt 2026
- [3] MOSS-Image Technical Report ↗MOSI.AI (arXiv) Forskningsartikel arxiv.orgPublicerad 16 okt 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.