MotionSpaceFlow (MSFlow)
En modell som skapar mänskliga rörelser från text och låter en styra enskilda leder och bildrutor direkt, utan extra träning för styrningen.
- Animation & rörelse
- 3D
 1 / 5
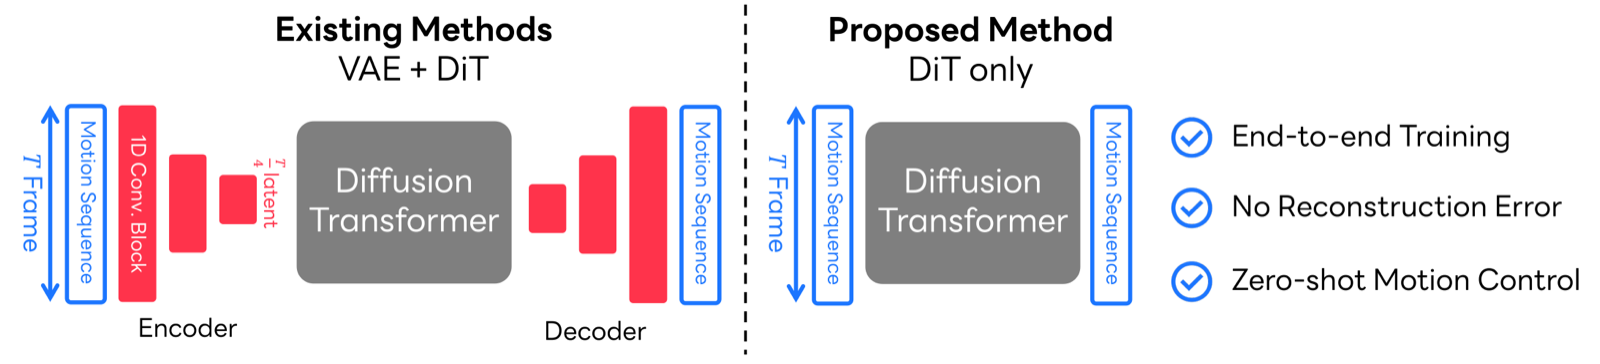
Översikt: MSFlow skapar rörelser direkt i full upplösning och kan styras led för led [1]
Om MotionSpaceFlow (MSFlow)[1][2][3][4][5][6]
MotionSpaceFlow (MSFlow) genererar 3D-rörelser för en människokropp från en textbeskrivning, till exempel "en person gör hjulning" eller "en person går framåt och lyfter högerarmen". De flesta liknande modeller arbetar i ett komprimerat, nedskalat utrymme som en separat kodare har lärt sig, vilket kan begränsa kvaliteten och gör det svårt att peka på en viss led i en viss bildruta. MSFlow skapar i stället rörelsen direkt i full upplösning, utan någon inlärd kodare eller avkodare.
Metoden bygger på flow matching och en transformer (RA-MMDiT) som behandlar text och rörelse tillsammans. Den anpassar sig efter hur rörelsen är beskriven: rörelser som byggs upp av förändringar mellan bildrutor behandlas framåt i tiden, medan rörelser beskrivna som absoluta ledpositioner (XYZ-koordinater) behandlas åt båda hållen.
Varianten med XYZ-koordinater kan dessutom tvinga valfria leder till valda positioner i valfria bildrutor medan rörelsen skapas, utan att ha tränats för det. Enligt forskarna ger det ledande rörelsekvalitet och exakt uppfyllda villkor, och MSFlow når toppresultat för text-till-rörelse på flera dataset och rörelseformat. Det kan göra animation lättare att styra.
Arbetet kommer från LY Corporation i Tokyo (företaget bakom LINE och Yahoo! JAPAN). Koden finns på GitHub under CC0 1.0 och förtränade exempelvikter på Hugging Face under Apache 2.0, tränade på datasetet HumanML3D vars villkor också gäller. Företaget skriver att kodförrådet bara är tillfälligt öppet och kan göras privat när som helst.
Det viktigaste[1][3][4]
- Skapar mänskliga rörelser från text direkt i full upplösning, utan inlärd kodare eller avkodare.
- Kan styra valfri led i valfri bildruta medan rörelsen skapas, utan extra träning för styrningen.
- Enligt forskarna toppresultat för text-till-rörelse på flera dataset.
- Kod under CC0 1.0 och vikter under Apache 2.0, men kodförrådet är enligt LY Corporation bara tillfälligt öppet.
Källor
- [1] MotionSpaceFlow: Representation-Aware Flow Matching in Direct Motion Space ↗LY Corporation Officiell sida yu1ut.comPublicerad okänt datum Läst 25 okt 2026
- [3]
- [5] OpenAI math breakthroughs, AlphaProtein Novo, Botanic-1, Iris 3B, Kandinsky 6.0: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 11 okt 2026 Läst 25 okt 2026
- [6] New AI enzymes, 700+ math breakthroughs, AI for DNA mutations, room temp semiconductors: AI NEWS ↗AI Search Video youtube.comPublicerad 10 okt 2026 Läst 25 okt 2026
- [4] MotionSpaceFlow: Representation-Aware Flow Matching in Direct Motion Space ↗Hugging Face (LY Corporation) Modellkort huggingface.coPublicerad 6 okt 2026 Läst 25 okt 2026
- [2] MotionSpaceFlow: Representation-Aware Flow Matching in Direct Motion Space ↗arXiv Forskningsartikel arxiv.orgPublicerad 28 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-10-10). [6]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.