Next-Concept Modeling
Ett nytt sätt att låta AI skriva text från Stanford: i stället för ett ord i taget skissar modellen först det stora upplägget och fyller sedan på med detaljer i några få parallella steg, vilket enligt forskarna går 10–31 gånger snabbare än jämförbara metoder.
- Språkmodell
- Forskning & vetenskap
 1 / 6
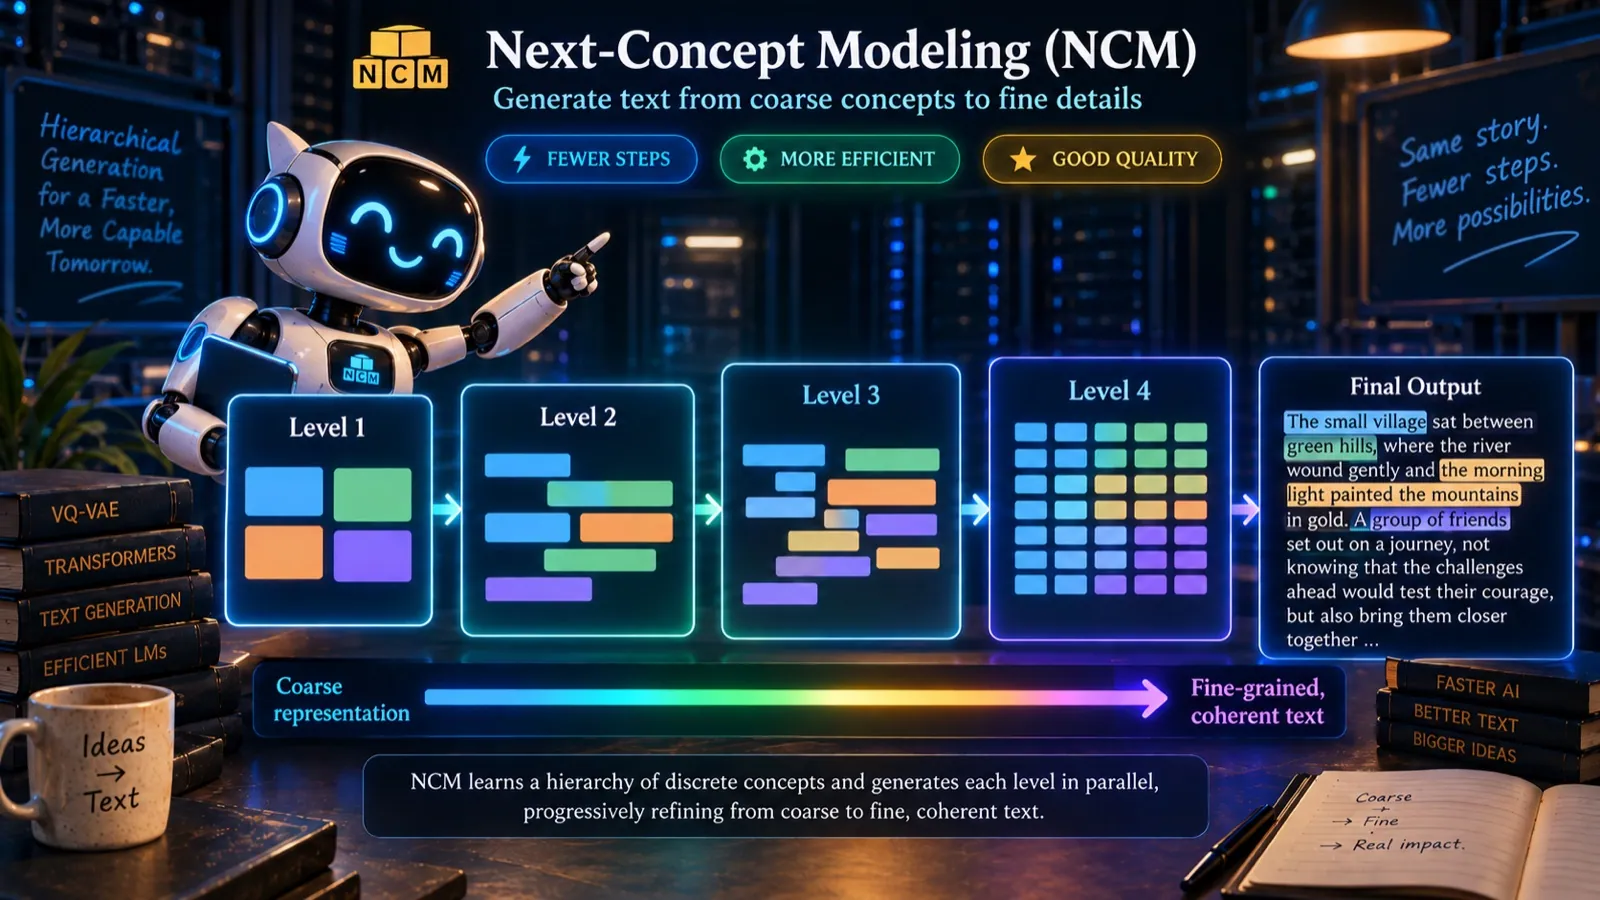
Illustration av idén: texten byggs upp nivå för nivå, från grova koncept till färdig text [1]
Om Next-Concept Modeling[1][2][3][5][6]
Next-Concept Modeling (NCM) är ett forskningsprojekt från Hazy Research vid Stanford som prövar ett nytt sätt att generera text. Vanliga språkmodeller skriver ett ord (token) i taget, och så kallade diffusionsmodeller förfinar hela texten om och om igen i många steg. NCM gör i stället som en tecknare som först skissar grova former och sedan lägger till detaljer: texten beskrivs som en hierarki av koder, där de första nivåerna är korta och fångar det övergripande innehållet och de senare nivåerna lägger till allt finare detaljer. Modellen skapar en nivå i taget, men allt inom en nivå på en gång.
Metoden har två delar. Först tränas en särskild tokenizer som lär sig översätta text till en sådan hierarki av koder och tillbaka. Idén är lånad från bildmodellen VAR, som genererar bilder från grov till fin upplösning. Sedan tränas en transformer att förutsäga varje nivå utifrån de tidigare. När texten genereras behövs bara ett steg per nivå.
Forskarna har testat NCM på fri textgenerering, översättning från tyska till engelska, korta sammanfattningar av nyhetsartiklar och sudoku. Enligt dem blir kvaliteten lika bra eller bättre än de starkaste diffusionsmodellerna, samtidigt som texten genereras 10–31 gånger snabbare och träningen kräver 4–5 gånger mindre data. (Projektets GitHub-sida anger 9–31 gånger snabbare.) På sudoku, där helheten måste stämma, löser NCM flest pussel av de metoder som jämförs, även på de svåraste. Forskarna tror att det beror på att modellen bestämmer helheten innan detaljerna.
Det här är tidig forskning med små modeller tränade för specifika testuppgifter, inte en färdig chattmodell. Forskarna vill härnäst undersöka hur metoden fungerar när den skalas upp. Kod och modellvikter är öppna under MIT-licens på GitHub och Hugging Face. Forskningsartikeln publicerades på arXiv den 9 oktober 2026.
Det viktigaste[1][3]
- Skriver text från grovt till fint i några få parallella steg, i stället för ett ord i taget.
- Enligt forskarna 10–31 gånger snabbare än de starkaste diffusionsmodellerna för text, med lika bra eller bättre kvalitet.
- Enligt forskarna kräver träningen 4–5 gånger mindre data än jämförbara diffusionsmodeller.
- Löser 86,1 procent av de svåraste sudokuna i testet, mot 81,3 för den bästa jämförda metoden och 1,0 för en vanlig ord-för-ord-modell.
- Tidig forskning med små modeller för specifika uppgifter; kod och vikter är öppna under MIT-licens.
Källor
- [3]
- [4] hazyresearch/ncm-checkpoints ↗Hazy Research Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [6] Quantum breakthrough, Gemini 4 Argon, Muse Wonder, Drama 3, MOSS Image, Krea 3, Ling 3.1: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 18 okt 2026 Läst 25 okt 2026
- [5] Quantum breakthrough, Gemini 4 Argon, MOSS Image, KLING 4, OpenAI spy, Muse Wonder: AI NEWS ↗AI Search Video youtube.comPublicerad 17 okt 2026 Läst 25 okt 2026
- [1] Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation ↗Hazy Research Officiell sida hazyresearch.stanford.eduPublicerad 12 okt 2026 Läst 25 okt 2026
- [2] Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation ↗arXiv Forskningsartikel arxiv.orgPublicerad 9 okt 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.