NUMINA
En metod som får AI-videogeneratorer att visa rätt antal saker, till exempel exakt tre katter när man ber om tre, genom att rätta modellens uppmärksamhet under genereringen utan någon ny träning.
- Videogenerering
 1 / 6
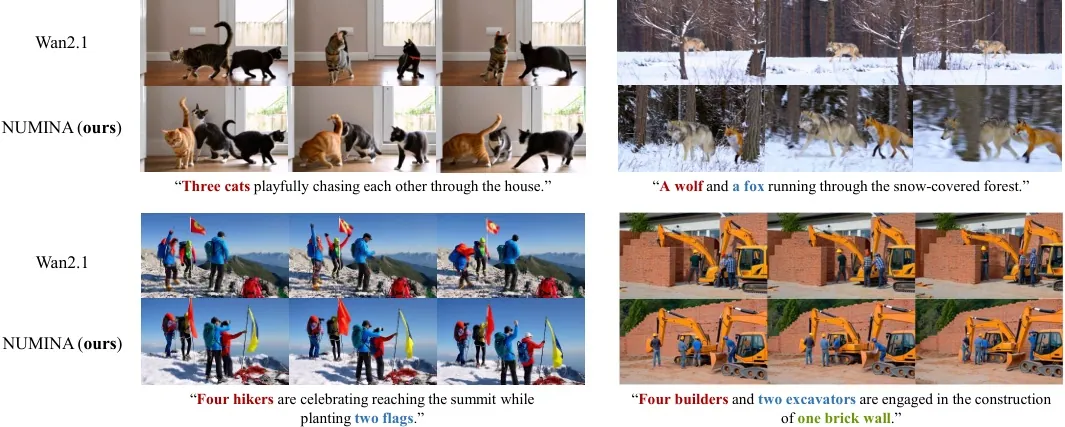
NUMINA rättar antalet objekt i genererade videor jämfört med grundmodellen [2]
Om NUMINA[1][2][3][4]
NUMINA är ett forskningsprojekt som angriper ett vanligt fel hos text-till-video-modeller: de får ofta fel antal objekt i bilden. Ber man om tre katter kan man få två eller fyra. Projektet heter i artikeln "When Numbers Speak: Aligning Textual Numerals and Visual Instances in Text-to-Video Diffusion Models" och har antagits till CVPR 2026.
I stället för att prova många slumpfrön eller skriva om prompten med en språkmodell tittar NUMINA in i själva videomodellen. Metoden analyserar modellens uppmärksamhetskartor (cross-attention och self-attention) i utvalda lager för att se var och varför antalet blir fel. Utifrån det bygger den en räknebar layout över var objekten ska finnas och styr sedan modellens uppmärksamhet efter den layouten när videon genereras om. Ingen omträning eller finjustering behövs.
Forskarna har också tagit fram ett eget test, CountBench. Enligt dem förbättrar NUMINA andelen videor med rätt antal med upp till 7,4 procentenheter på Wan2.1-1.3B, och metoden fungerar även på Wan2.1-14B och Wan2.2-5B. Projektsidan jämför också med kommersiella modeller som Veo 3.1 och Grok Imagine, som enligt forskarna ofta missar exakta antal. Metoden går att kombinera med snabbare generering via EasyCache.
Arbetet kommer från Huazhong University of Science and Technology tillsammans med Zhejiang University och Afari Intelligent Drive. Koden är öppen under MIT-licens och läggs ovanpå Wan2.1.
Det viktigaste[1][2]
- Får videomodeller att generera rätt antal personer, djur eller saker enligt prompten.
- Kräver ingen omträning: metoden styr modellens uppmärksamhet medan videon genereras.
- Enligt forskarna upp till 7,4 procentenheter bättre räkneträffsäkerhet på Wan2.1-1.3B i deras test CountBench.
- Fungerar även på Wan2.1-14B och Wan2.2-5B, och går att kombinera med snabbare generering via EasyCache.
- Antagen till CVPR 2026.
Källor
- [1] When Numbers Speak: Aligning Textual Numerals and Visual Instances in Text-to-Video Diffusion Models ↗Huazhong University of Science and Technology m.fl. Officiell sida h-embodvis.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] NUMINA ↗H-EmbodVis (Huazhong University of Science and Technology) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] Mythos, Deepseek Expert, HappyHorse, Muse Spark, AceStep XL, GLM-5.1, Waypoint 1.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 12 apr 2026 Läst 25 okt 2026
- [2] When Numbers Speak: Aligning Textual Numerals and Visual Instances in Text-to-Video Diffusion Models ↗arXiv Forskningsartikel arxiv.orgPublicerad 9 apr 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-12). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.