Ovis-VL-Embedding-9B
En öppen inbäddningsmodell som gör om text, bilder, dokument och video till jämförbara talvektorer, så att ett och samma sökssystem kan hitta rätt innehåll oavsett medietyp.
- Sök & kunskap
- Bildförståelse
- Dokument & OCR
- Multimodal
 1 / 3
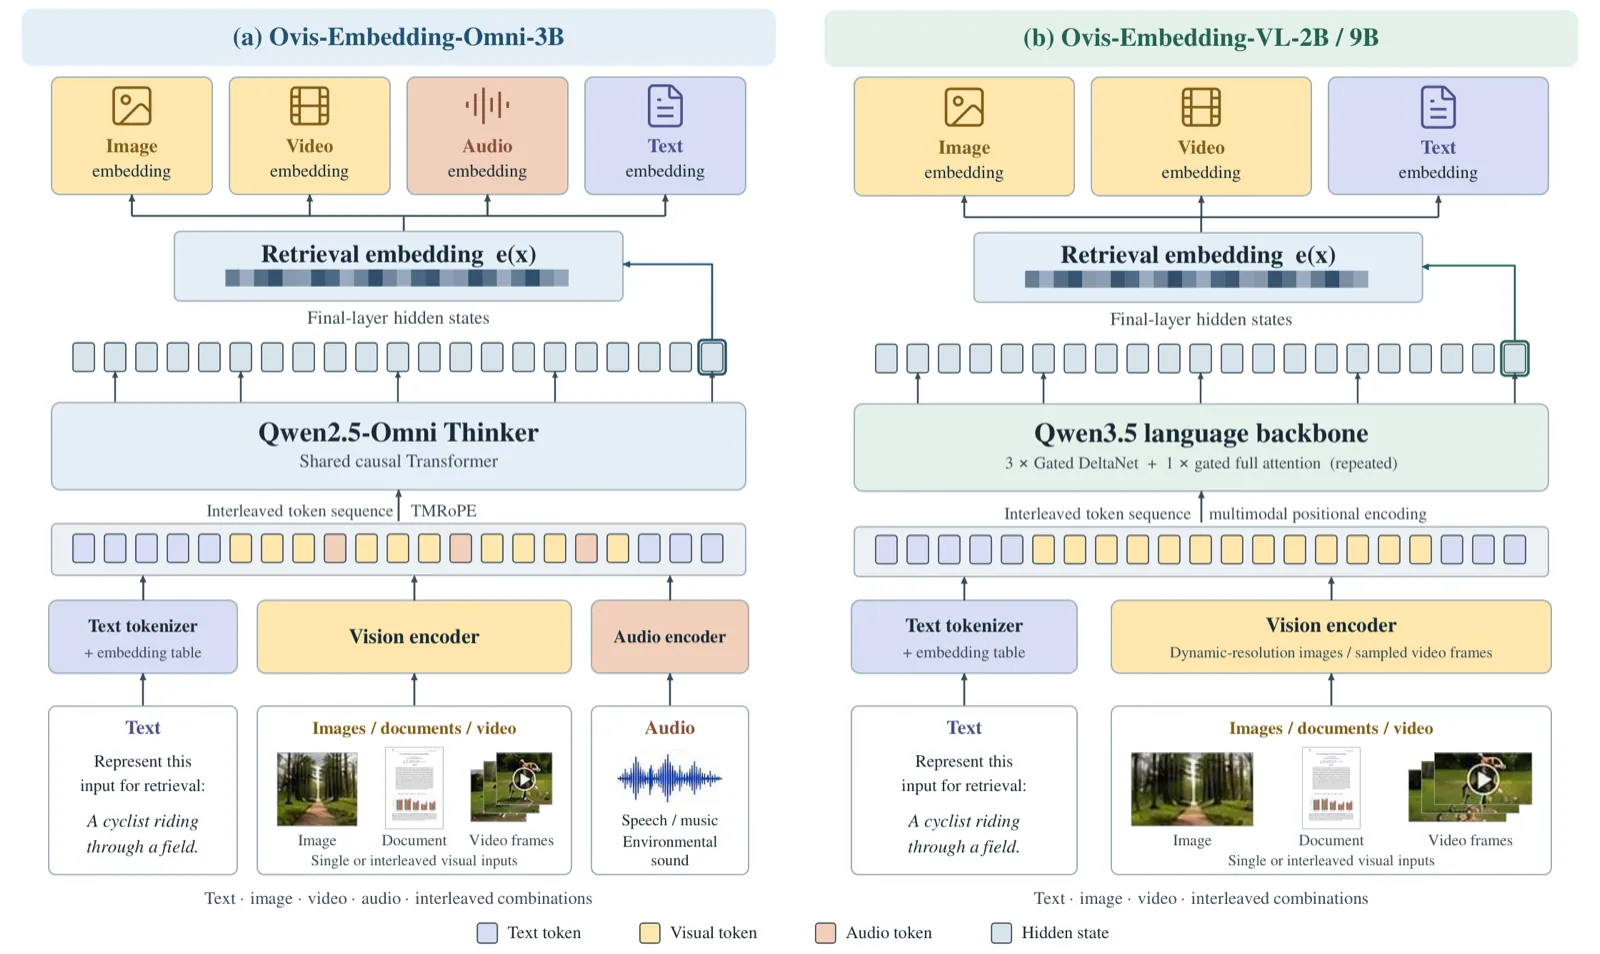
Uppbyggnaden av Ovis-Embedding-modellerna: Omni-3B med ljud till vänster och VL-2B/9B till höger [1]
Om Ovis-VL-Embedding-9B[1][2][3][4]
Ovis-VL-Embedding-9B är en inbäddningsmodell, alltså en modell som inte skriver text utan gör om innehåll till en lång rad tal (en vektor). Innehåll som betyder ungefär samma sak hamnar nära varandra, så att man kan söka efter bilder med text, hitta rätt sida i ett dokument eller rätt videoklipp. Modellen hanterar text, bilder, visuella dokument som skannade sidor, video och blandningar av dem, men inte ljud. För ljud hänvisar teamet till en systermodell, Ovis-Embedding-Omni-3B.
Modellen bygger på Qwen3.5-9B, där text- och bildkodare behålls men delen som genererar text tas bort. Vektorn tas direkt från modellens sista lager och har 4 096 tal. Den hör till Ovis-Embedding-familjen, som beskrivs i en teknisk rapport från september 2026 där modellerna tränats med kontrastiv inlärning på en bred multimodal datamängd, med särskild vikt vid svåra exempel.
Enligt teamet får modellen 81,13 på testsviten MMEB-v2 (78 datamängder), drygt en poäng före den bästa jämförda modellen. Den är starkast på bilder (83,96) och visuella dokument (83,06) men ligger efter på video (72,90 mot 75,95). Den finns på Hugging Face under Apache 2.0-licensen.
Det viktigaste[1]
- Gör om text, bilder, dokument och video till vektorer i samma rum, för sökning mellan medietyper.
- Enligt teamet 81,13 på MMEB-v2, drygt en poäng före den bästa jämförda modellen.
- Starkast på bilder och dokument; enligt teamets egna siffror sämre än konkurrenten på video.
- Bygger på Qwen3.5-9B och släpps under Apache 2.0.
Källor
- [3] GPT 6 Sol, Gemini 3.8 TTS, Grok 4.7, Opus 5.5, Mimo 2.6, WorldCrafter: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 27 sep 2026 Läst 25 okt 2026
- [4] Waifus incoming, GPT 6 Sol, Grok 4.7, Opus 5.5, Mimo 2.6, Step 5, OpenMuse: AI NEWS ↗AI Search Video youtube.comPublicerad 26 sep 2026 Läst 25 okt 2026
- [1] ATH-MaaS/Ovis-VL-Embedding-9B ↗ATH-MaaS (Hugging Face) Modellkort huggingface.coPublicerad 21 sep 2026 Läst 25 okt 2026
- [2] Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings ↗arXiv Forskningsartikel arxiv.orgPublicerad 21 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-09-26). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.