PlayTrain
Ett ramverk som gör AI-skrivna JavaScript-spel till snabba träningsmiljöer för AI-agenter, där människor kan spela exakt samma spel i webbläsaren.
- Agenter
- Kod
- Forskning & vetenskap
 1 / 4
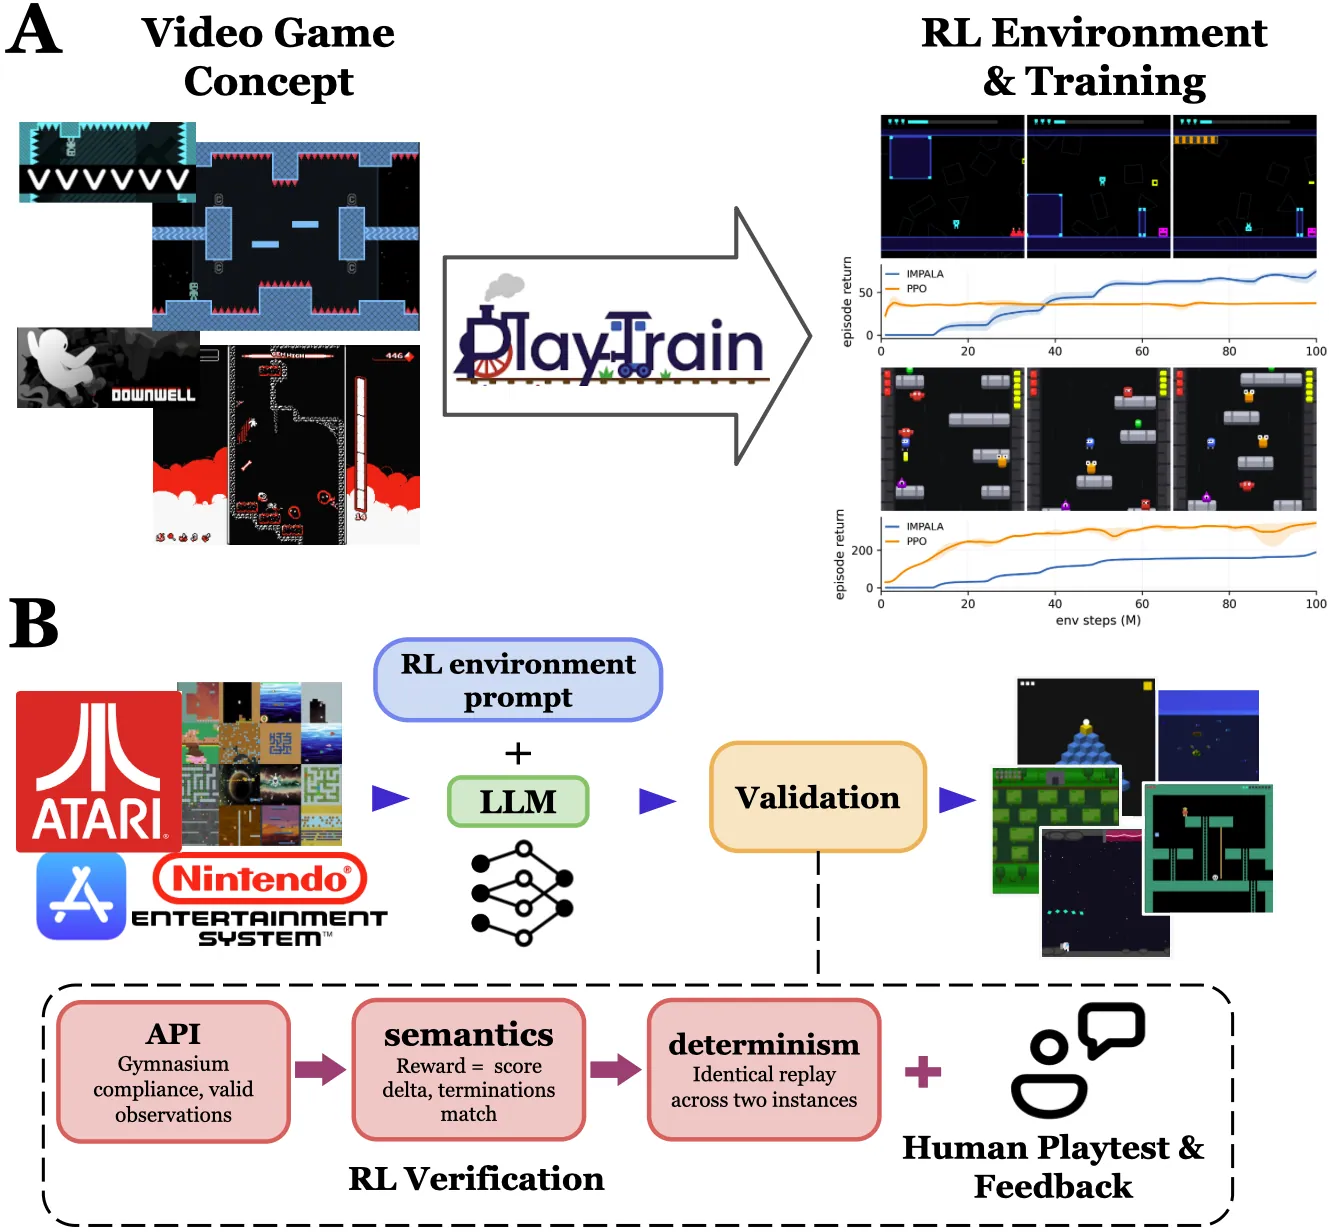
Idén bakom PlayTrain: språkmodellen skriver spelet i JavaScript, som sedan blir en träningsmiljö [2]
Om PlayTrain[1][2][3][4]
PlayTrain är ett forskningsramverk för förstärkningsinlärning (RL) där träningsmiljöerna är datorspel som en språkmodell har skrivit. Att bygga eller ändra spelmiljöer för AI-forskning har traditionellt krävt mycket handkodning. Med PlayTrain räcker en enda JavaScript-fil som en språkmodell skriver från en kort beskrivning, och samma fil kan både spelas av en människa i webbläsaren och köras som en vanlig Gymnasium-miljö för att träna agenter.
Ramverket har tre delar: en körmiljö som kör p5.js- och Matter.js-spel utan webbläsare (med inbäddad QuickJS och egen rasterisering), en del som låter en språkmodell skriva och ändra spel med en kontroll i fem steg innan ett spel godkänns, och ett separat paket med tränare (IMPALA och PPO). Enligt forskarna kan agenter som lär sig direkt från pixlar tränas med över en miljon beslut per sekund på en enda GPU-nod, mätt på en svit av 24 spel som är kloner av ProcGen- och Atarispel.
Eftersom spelen är vanlig kod går det enkelt att be språkmodellen ändra regler, nivågenerering eller spelmekanik och sedan se hur agenterna anpassar sig. Katalogen har 51 spel, bland annat kloner av Atari- och ProcGen-spel, egna spel och varianter, och projektet har även portat Craftax-Classic och 23 DeepMind Lab-banor. Alla går att spela på playtrain.org. I en studie jämfördes 20 människors resultat med agenternas på åtta av spelen.
Arbetet kommer från Harvard University, MIT, Kempner Institute och Yale University, och koden är öppen under MIT-licens.
Det viktigaste[1][2][3]
- Varje träningsmiljö är en enda JavaScript-fil som en språkmodell har skrivit.
- Samma spel kan spelas av människor i webbläsaren och användas för att träna AI-agenter.
- Enligt forskarna över en miljon agentbeslut per sekund på en enda GPU-nod.
- Katalog med 51 spel, plus portar av Craftax-Classic och 23 DeepMind Lab-banor.
- Regler och spelmekanik ändras genom att be språkmodellen skriva om spelet.
- Öppen källkod under MIT-licens, med en Colab-anteckningsbok för att komma igång.
Källor
- [1] PlayTrain: An Efficient Reinforcement Learning Framework for LLM-Generated Adaptable JavaScript Games ↗Harvard University, MIT, Kempner Institute och Yale University Officiell sida playtrain.orgPublicerad okänt datum Läst 25 okt 2026
- [3]
- [4] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
- [2] PlayTrain: An Efficient Reinforcement Learning Framework for LLM-Generated Adaptable JavaScript Games ↗arXiv Forskningsartikel arxiv.orgPublicerad 8 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Harvard University
- SceneAgent sep 2026