PURE
En metod som efterhandstränar befintliga 3D-modeller på vanliga, omärkta videor så att de blir bättre på att återskapa scener i 3D där saker rör sig.
- 3D
- Bildförståelse
 1 / 7
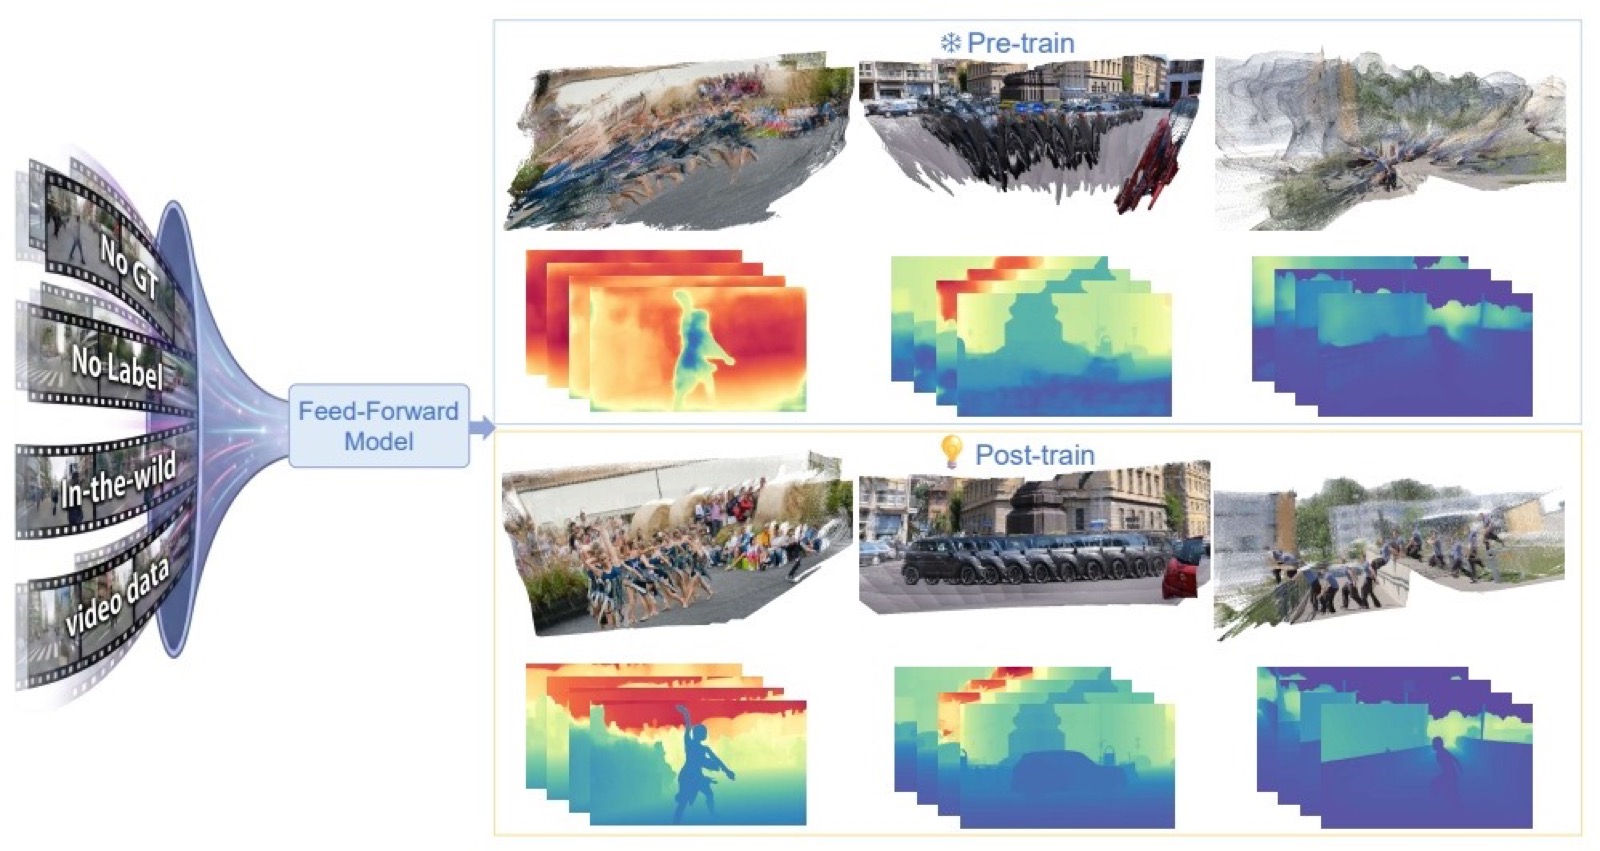
Före och efter: samma modell före (överst) och efter (nederst) efterhandsträning på omärkta videor [1]
Om PURE[1][2][3][5]
PURE (Refining Feed-forward 3D Reconstruction with Unlabeled Post-training) är ett forskningsprojekt som förbättrar AI-modeller som gör om video eller bildserier till 3D: punktmoln, djupkartor och kamerans position i varje bildruta. Sådana modeller fungerar bra på stillastående scener men har svårt med vardagsvideor där människor, djur och fordon rör sig, där ljuset växlar och där saker skymmer varandra.
Tanken är att slippa dyra facit i form av uppmätta djup och kamerapositioner. I stället efterhandstränas befintliga modeller på omärkta videor. Som träningssignal används djupuppskattningar från en lärarmodell, masker för rörliga objekt och matchningar av punkter mellan bildrutor, som lär modellen rätt djupordning, lokal geometri och att stillastående delar ska hänga ihop mellan bildrutorna.
Forskarna har tillämpat metoden på tre befintliga modeller: Pi3 v2, Depth Anything 3 (DA3 Giant) och VGGT. Enligt artikeln ger PURE genomgående förbättringar för alla tre på både syntetiska och verkliga tester med rörliga scener. De förbättrade vikterna finns på Hugging Face, och det finns en webbdemo, PURE Studio, där man kan ladda upp en egen video och få tillbaka ett 3D-punktmoln.
Arbetet kommer från Peking University (Shenzhen Graduate School), Hong Kong University of Science and Technology och Pengcheng Laboratory, och har antagits till konferensen ACM Multimedia 2026. Koden ligger hos Intelligent Graphics Lab vid HKUST.
Det viktigaste[1][2][3]
- Förbättrar 3D-rekonstruktion av rörliga scener utan att behöva uppmätta djup eller kamerapositioner, bara omärkta videor.
- Fungerar på tre olika befintliga modeller: Pi3 v2, DA3 Giant och VGGT.
- Enligt forskarna ger metoden genomgående förbättringar på både syntetiska och verkliga tester med rörliga scener.
- Från en video får man djupkartor, kamerapositioner och ett färgat 3D-punktmoln.
- Det finns en webbdemo, PURE Studio, där man kan prova med egna videor.
- Antagen till ACM Multimedia 2026.
Källor
- [1] PURE: Refining Feed-forward 3D Reconstruction with Unlabeled Post-training ↗Peking University, HKUST och Pengcheng Laboratory Officiell sida funnyguy525.github.ioPublicerad okänt datum Läst 25 okt 2026
- [5] Cybersecurity chaos, AI for DNA, Kimi K3.1, Claude Duet, Dessa, Fibo 2, Minimax 3.1: AI NEWS ↗AI Search Video youtube.comPublicerad 24 okt 2026 Läst 25 okt 2026
- [4] PURE: Refining Feed-forward 3D Reconstruction with Unlabeled Post-training ↗Hugging Face (cyun9286) Modellkort huggingface.coPublicerad 15 okt 2026 Läst 25 okt 2026
- [2] PURE: Refining Feed-forward 3D Reconstruction with Unlabeled Post-training ↗arXiv Forskningsartikel arxiv.orgPublicerad 10 okt 2026 Läst 25 okt 2026
- [3] PURE: Refining Feed-forward 3D Reconstruction with Unlabeled Post-training ↗Intelligent Graphics Lab, HKUST Officiell sida github.comPublicerad 10 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search-videon. [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.