R2T2
En öppen taligenkänningsmodell från NetEase Youdao som skriver ut tal som text i realtid, utan att ändra ord den redan skrivit.
- Tal till text
- Kör lokalt
 1 / 4
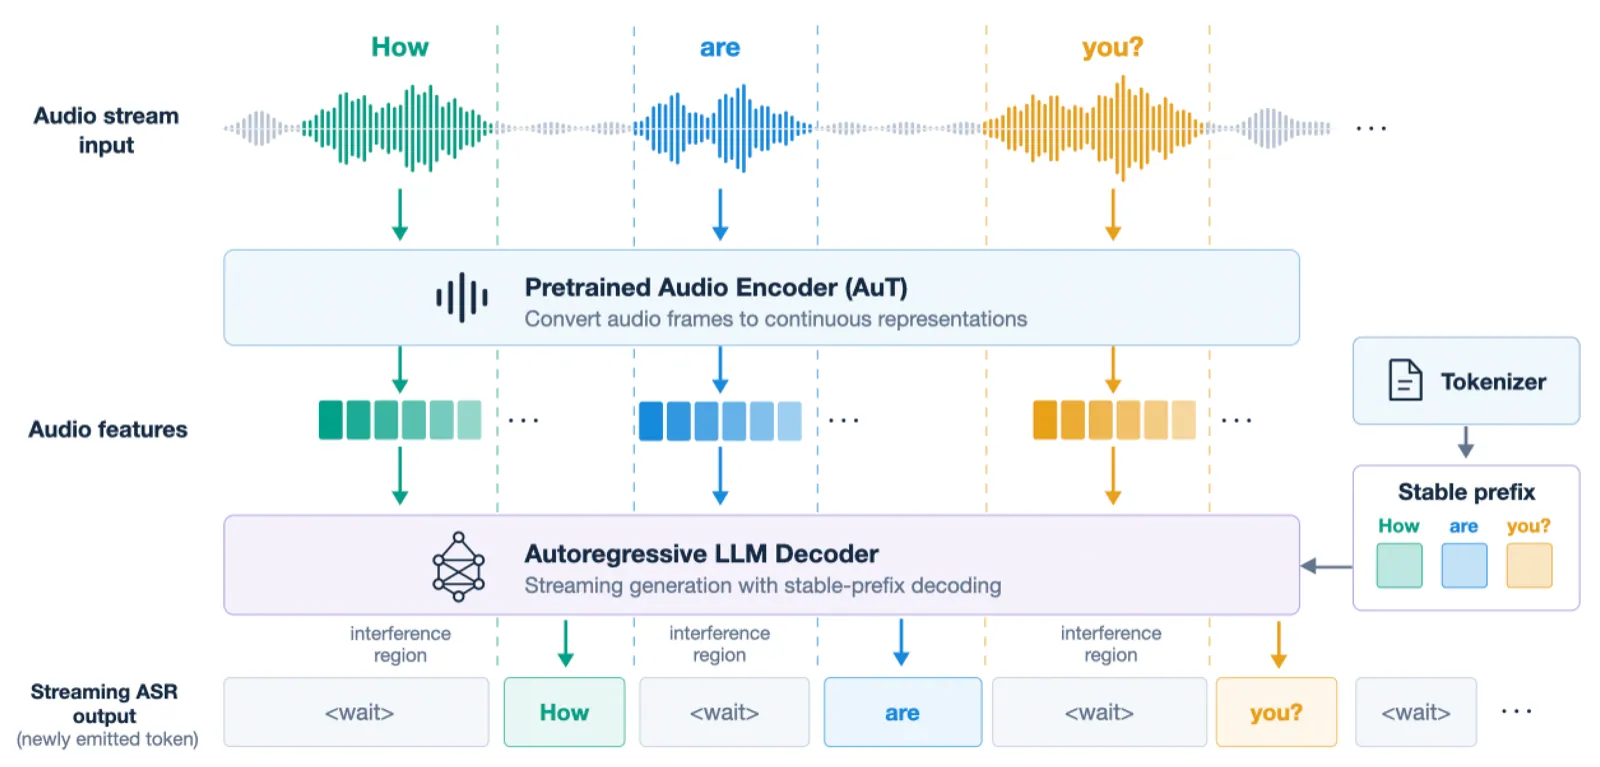
Så är R2T2 uppbyggd [2]
Ljudexempel
- Exempelljud: ett samtal på en bank (engelska) som R2T2 transkriberar på webbplatsen [1]
Om R2T2[1][2][3][5]
R2T2 (Real Real-Time Transcription), med fullständigt namn Confucius4-R2T2, är en öppen modell för taligenkänning i realtid från det kinesiska bolaget NetEase Youdao. Den gör om tal till text medan någon pratar, med en genomsnittlig fördröjning på 200 till 600 millisekunder enligt Youdao.
Det speciella är att texten bara fylls på. Många realtidssystem visar en preliminär text som sedan skrivs om när mer ljud kommit in, vilket gör att orden hoppar och flimrar. R2T2 skriver bara ut ord den är säker på och ändrar dem aldrig i efterhand. Det passar till exempel direktsänd textning, simultantolkning och AI-agenter som ska agera på det som sägs direkt. Man kan själv välja hur stora ljudbitar modellen arbetar med, från 80 millisekunder till 2 sekunder, beroende på om fördröjning eller träffsäkerhet är viktigast.
Modellen bygger på Qwen3-ASR-1.7B och har cirka 2 miljarder parametrar. Den är bäst på kinesiska och engelska men klarar även bland annat franska, tyska, japanska, koreanska och spanska. Enligt Youdao är den bäst bland öppna modeller på både fördröjning och träffsäkerhet och kan mäta sig med ledande slutna system, och utan att förlora träffsäkerhet vid vanlig transkribering av färdiga inspelningar. Koden är Apache 2.0, medan vikterna har NetEase egen licens som kräver separat tillstånd för stora företag. En teknisk rapport ska släppas senare.
Det viktigaste[1][2][4]
- Äkta strömmande taligenkänning: utskriven text ändras aldrig i efterhand.
- Enligt Youdao 200–600 millisekunders genomsnittlig fördröjning, med valbar bitstorlek från 80 ms till 2 s.
- Optimerad för kinesiska och engelska, men klarar även många andra språk.
- Enligt Youdao bäst bland öppna modeller på fördröjning och träffsäkerhet; jämförs sida vid sida med GPT-Live-Transcribe.
- Kan köras med vLLM, Hugging Face transformers eller llama.cpp (GGUF), och har stöd för kontext och nyckelord.
- Företag med över 100 miljoner aktiva användare per månad eller över 1 miljard yuan i omsättning måste be om en separat licens.
Källor
- [1] R2T2 — Open-source streaming ASR model ↗NetEase Youdao Officiell sida r2t2.aiPublicerad okänt datum Läst 25 okt 2026
- [2]
- [4] NetEase Model Use License Agreement ↗NetEase Youdao Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [5] OpenAI hacked, Jev, Dream RSI, Qwen 3.8 Omni, Gemini 3.8 Live, Bonsai 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 20 sep 2026 Läst 25 okt 2026
- [3] netease-youdao/Confucius4-R2T2 ↗Hugging Face (netease-youdao) Modellkort huggingface.coPublicerad 10 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-20). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.