Real-SWE
En testsvit från Specific som mäter hur bra AI-kodagenter klarar riktiga uppgifter i privata kodbaser från verkliga företag, där Claude Opus 5.5 och GPT 6 Astra ligger i topp.
- Kod
- Agenter
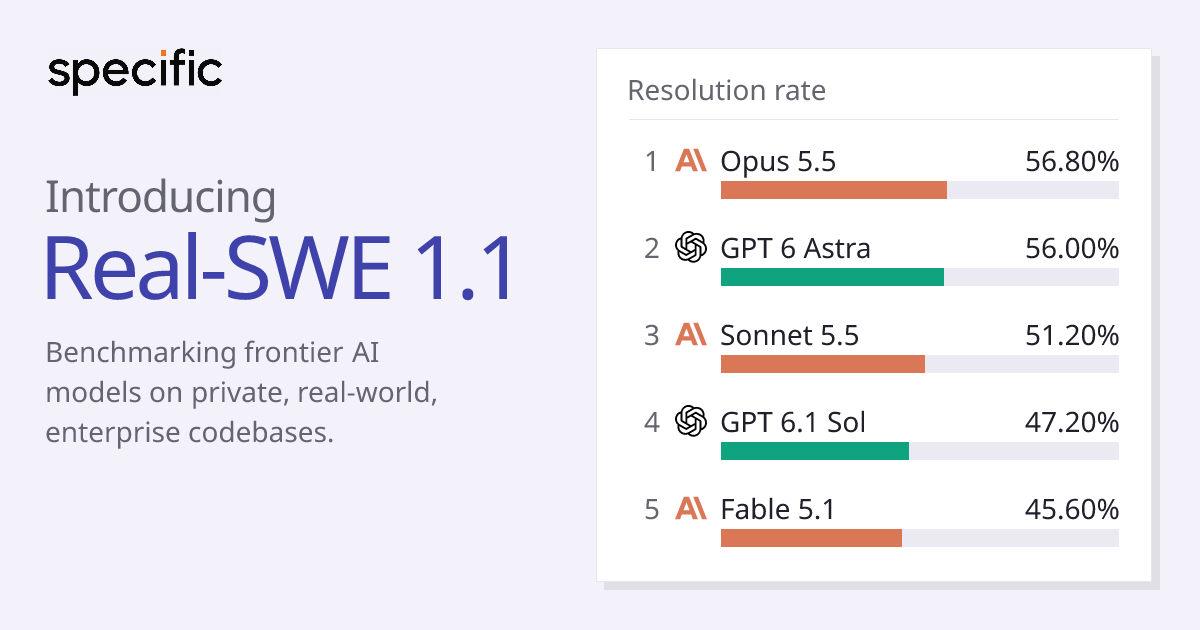
De fem främsta modellerna i Real-SWE 1.1 enligt Specific [1]
Om Real-SWE[1][2][3]
Real-SWE är ett benchmark, alltså ett standardiserat test, för AI-modeller som skriver kod. Till skillnad från de flesta kodtester bygger det inte på öppen kod från GitHub, som modellerna kan ha sett under träningen. Varje uppgift kommer i stället från en privat kodbas i drift som Specific licensierar från ett riktigt företag, till exempel en konkurrent till Luma och Partiful med över 200 000 användare, en fintech-tjänst som hanterat över 100 000 kontoutdrag och säljplattformar för företag. Uppgifterna innehåller företagens egna regler och kopplingar till andra tjänster.
I version 1.1 (oktober 2026) finns 25 uppgifter i TypeScript, Go, Python, Ruby och Java, och 17 modeller jämförs. Instruktionerna är korta och lite ofullständiga, som i verkligt arbete, och referenslösningarna ändrar i snitt 10,2 filer. Varje modell körs med sitt eget verktyg (till exempel Claude Code eller Codex CLI) på högsta ansträngningsnivå, fem gånger per uppgift.
Enligt Specific leder Claude Opus 5.5 med 56,8 % lösta uppgifter, följd av GPT 6 Astra (56,0 %) och Claude Sonnet 5.5 (51,2 %). GPT 6.1 Sol når 47,2 % till en uppskattad kostnad av bara 0,79 dollar per körning. Det vanligaste felet hos alla modeller är att de bygger på antaganden de inte kontrollerat (32,9 % av misslyckandena), följt av missade krav (29,7 %). Uppgifterna är inte öppna, men exempeluppgifter kan begäras från Specific.
Det viktigaste[1]
- Uppgifterna kommer från privata kodbaser som Specific licensierar från riktiga företag, så modellerna kan inte ha sett dem under träningen.
- Version 1.1: 25 uppgifter i fem programspråk och 17 jämförda modeller.
- Enligt Specific: Claude Opus 5.5 56,8 %, GPT 6 Astra 56,0 %, Claude Sonnet 5.5 51,2 %, GPT 6.1 Sol 47,2 % och Fable 5.1 45,6 %.
- Uppskattad kostnad per körning varierar från 0,08 dollar (GPT 6 Luna) till 14,24 dollar (Fable 5.1).
- Vanligaste felet: modellen bygger på antaganden den inte har kontrollerat (32,9 % av misslyckandena).
Källor
- [1] Real-SWE 1.1 ↗Specific Officiell sida realswe.withspecific.comPublicerad okänt datum Läst 25 okt 2026
- [2]
- [3] Deepseek v4.1 Flash, AlphaGenome Atlas, AuK, YuE2, Navier Stokes, Lingbot World 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 13 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-13). Uppgifterna gäller version 1.1 från oktober 2026. [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.