RotorQuant
En metod för att komprimera språkmodellers arbetsminne (KV-cachen) så att de använder mycket mindre minne och går snabbare, presenterad som ett alternativ till Googles TurboQuant.
- Språkmodell
- Kör lokalt
 1 / 2
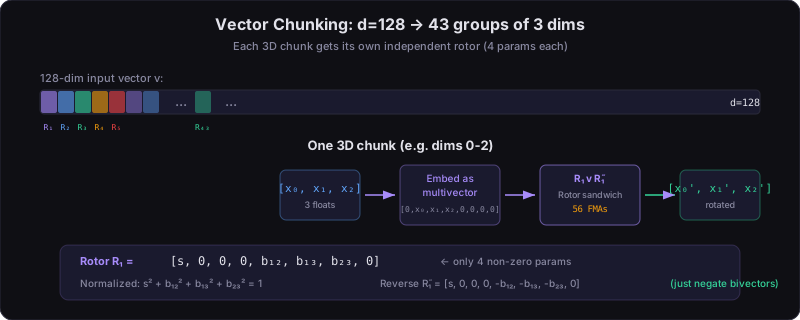
Vektorn delas upp i små bitar som roteras var för sig [2]
Om RotorQuant[1][2][3]
RotorQuant är en öppen metod för att komprimera det som en språkmodell håller i minnet under en konversation, den så kallade KV-cachen. Den växer med samtalets längd och tar mycket grafikminne, så att komprimera den gör att modeller kan köras med längre samtal på samma hårdvara.
Idén är att först vrida (rotera) värdena så att de blir lättare att avrunda till några få bitar, och sedan vrida tillbaka. Googles TurboQuant gör det med en stor rotation över alla 128 dimensioner. RotorQuant använder i stället många små, oberoende rotationer över två eller fyra dimensioner i taget, vilket kräver betydligt färre parametrar och går snabbare att räkna. Den ursprungliga versionen byggde på så kallade Clifford-rotorer, men har ersatts av de enklare varianterna PlanarQuant och IsoQuant.
Enligt upphovsmannen ger RotorQuant något bättre kvalitet än TurboQuant (perplexitet 6,91 mot 7,07 på Llama 3.1 8B), 28 procent snabbare textgenerering, 5,3 gånger snabbare inläsning av prompten och 44 gånger färre parametrar, vid ungefär tio gångers komprimering. Siffrorna kommer från ett grafikkort och en modell, och jämförelserna blandar två varianter av metoden.
Metoden finns som tillägg till llama.cpp och fungerar på Nvidia-kort och Apple Silicon. Koden är öppen under MIT-licens, och bakom arbetet står John D. Pope via plattformen Scrya.
Det viktigaste[1][2]
- Komprimerar språkmodellers KV-cache ungefär tio gånger, vid 3 bitar.
- Många små rotationer i stället för en stor, med 44 gånger färre parametrar än TurboQuant.
- Enligt upphovsmannen 28 procent snabbare generering och 5,3 gånger snabbare promptinläsning än TurboQuant på ett RTX 5090.
- Finns som tillägg till llama.cpp för Nvidia och Apple Silicon.
- Öppen kod under MIT-licens.
Källor
- [3] Mythos, Deepseek Expert, HappyHorse, Muse Spark, AceStep XL, GLM-5.1, Waypoint 1.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 12 apr 2026 Läst 25 okt 2026
- [1]
- [2]
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-12). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.