RSI-Exam
Ett test som mäter om AI-agenter kan förbättra en fungerande metod på egen hand under många timmar, och om förbättringarna håller på data som agenten aldrig sett.
- Agenter
- Forskning & vetenskap
 1 / 4
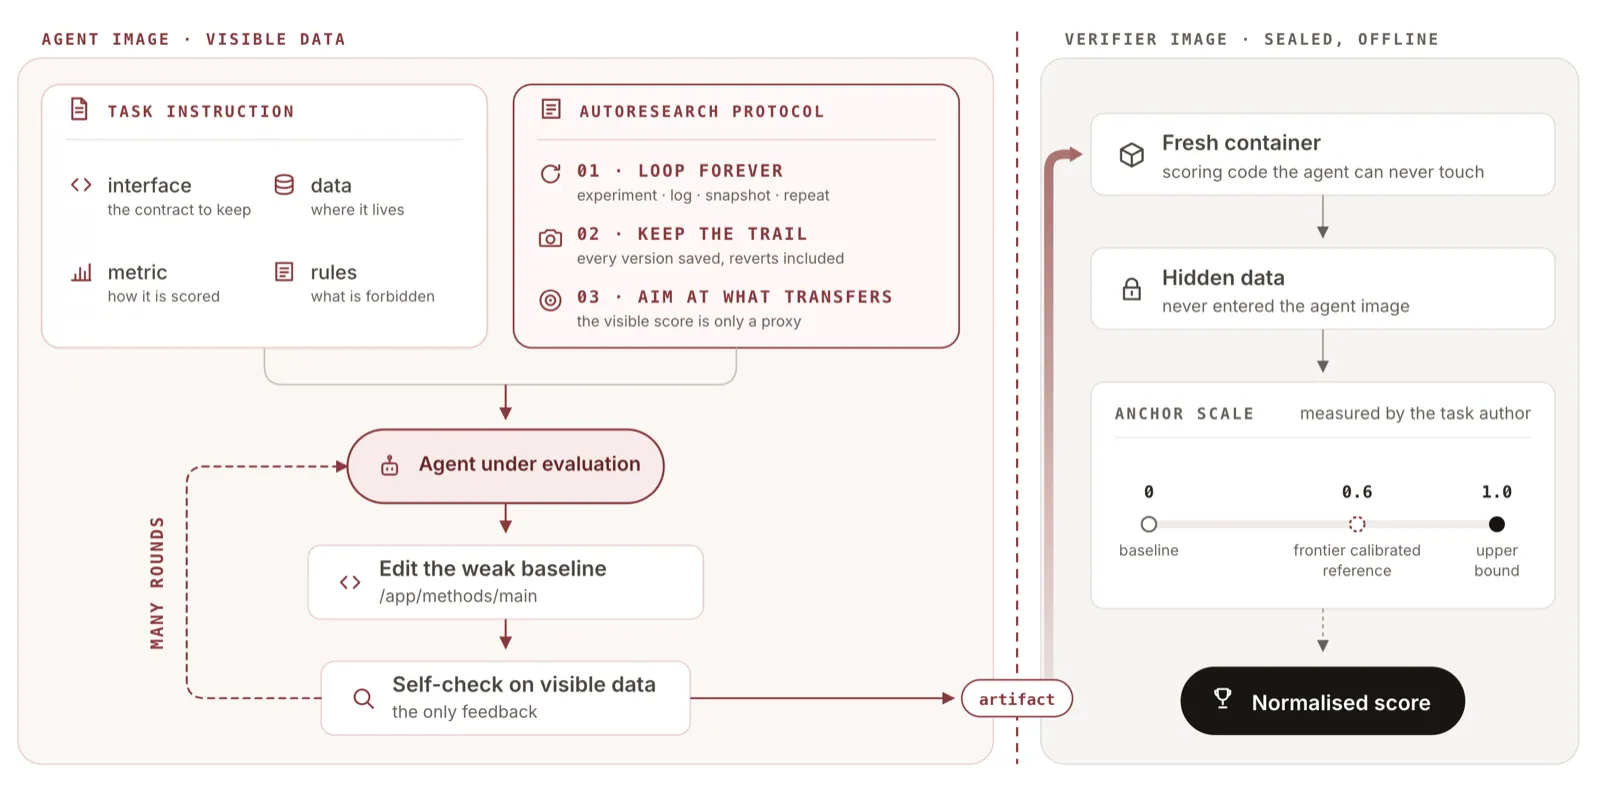
Så går ett prov till: agenten förbättrar en metod som sedan körs om på dolda data [3]
Om RSI-Exam[1][2][3][5]
RSI-Exam är ett test (benchmark) för så kallad rekursiv självförbättring: förmågan hos en AI-agent att stegvis göra sitt eget arbete bättre. Här betyder det inte att modellen ändrar sina egna vikter, utan att agenten får en fungerande men svag metod, till exempel ett program som löser ett problem, och sedan i upp till 12 timmar experimenterar fram förbättringar, sparar versioner och slänger idéer som inte fungerar.
Till slut lämnar agenten in körbar kod, inte ett svar. Koden körs då en gång, oförändrad, på ett dolt dataset som agenten aldrig fått se. Bara förbättringar som håller även där ger poäng. Första versionen, RSI-Exam 0.1, har 88 uppgifter (35 offentliga och 53 hemliga) inom sex områden: AI-modeller och agenter, system och hårdvara, fysik och teknik, optimering, biovetenskap och medicin, samt finans, juridik och affärer. Varje uppgift behåller sitt eget fackmått, som sedan räknas om till en gemensam skala där startmetoden är 0. Alla experiment och förkastade idéer sparas och kan granskas.
På topplistan i oktober 2026 leder Claude Opus 5.5 (i Claude Code) med 0,54, följd av GPT-6-astra och Claude Fable 5.1. Benchmarken drivs av AIMING Lab vid University of North Carolina at Chapel Hill, med medverkan från flera andra universitet, bland annat Stanford, Berkeley och Carnegie Mellon. Koden är MIT-licensierad och de offentliga uppgifterna finns på Hugging Face.
Det viktigaste[1][2][3]
- Agenten får en fungerande men svag metod och upp till 12 timmar att förbättra den.
- Resultatet räknas bara på ett dolt dataset, så förbättringar som inte håller ger inga poäng.
- 88 uppgifter i sex områden, från TPU-kärnor och kretsdesign till cellbiologi och aktieprognoser.
- Topplistan i oktober 2026: Opus 5.5 0,54, GPT-6-astra 0,51, Fable 5.1 0,48, Opus 5 0,46.
- Experiment, sparade versioner och förkastade idéer finns sparade och kan granskas.
- Mäter förbättring av metoder, inte att modeller ändrar sina egna vikter.
Källor
- [1] RSI-Exam: Benchmarking Recursive Self-Improvement through Executable Research ↗RSI-Exam Team Officiell sida rsi-exam.aiPublicerad okänt datum Läst 25 okt 2026
- [2] RSI-Exam · Benchmarking Recursive Self-Improvement through Executable Research ↗RSI-Exam Team Officiell sida rsi-exam.aiPublicerad okänt datum Läst 25 okt 2026
- [4] RSI-Exam/RSI-Exam ↗Hugging Face (RSI-Exam) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [3] RSI-Exam ↗AIMING Lab, UNC Chapel Hill Officiell sida github.comPublicerad 28 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.