See-through
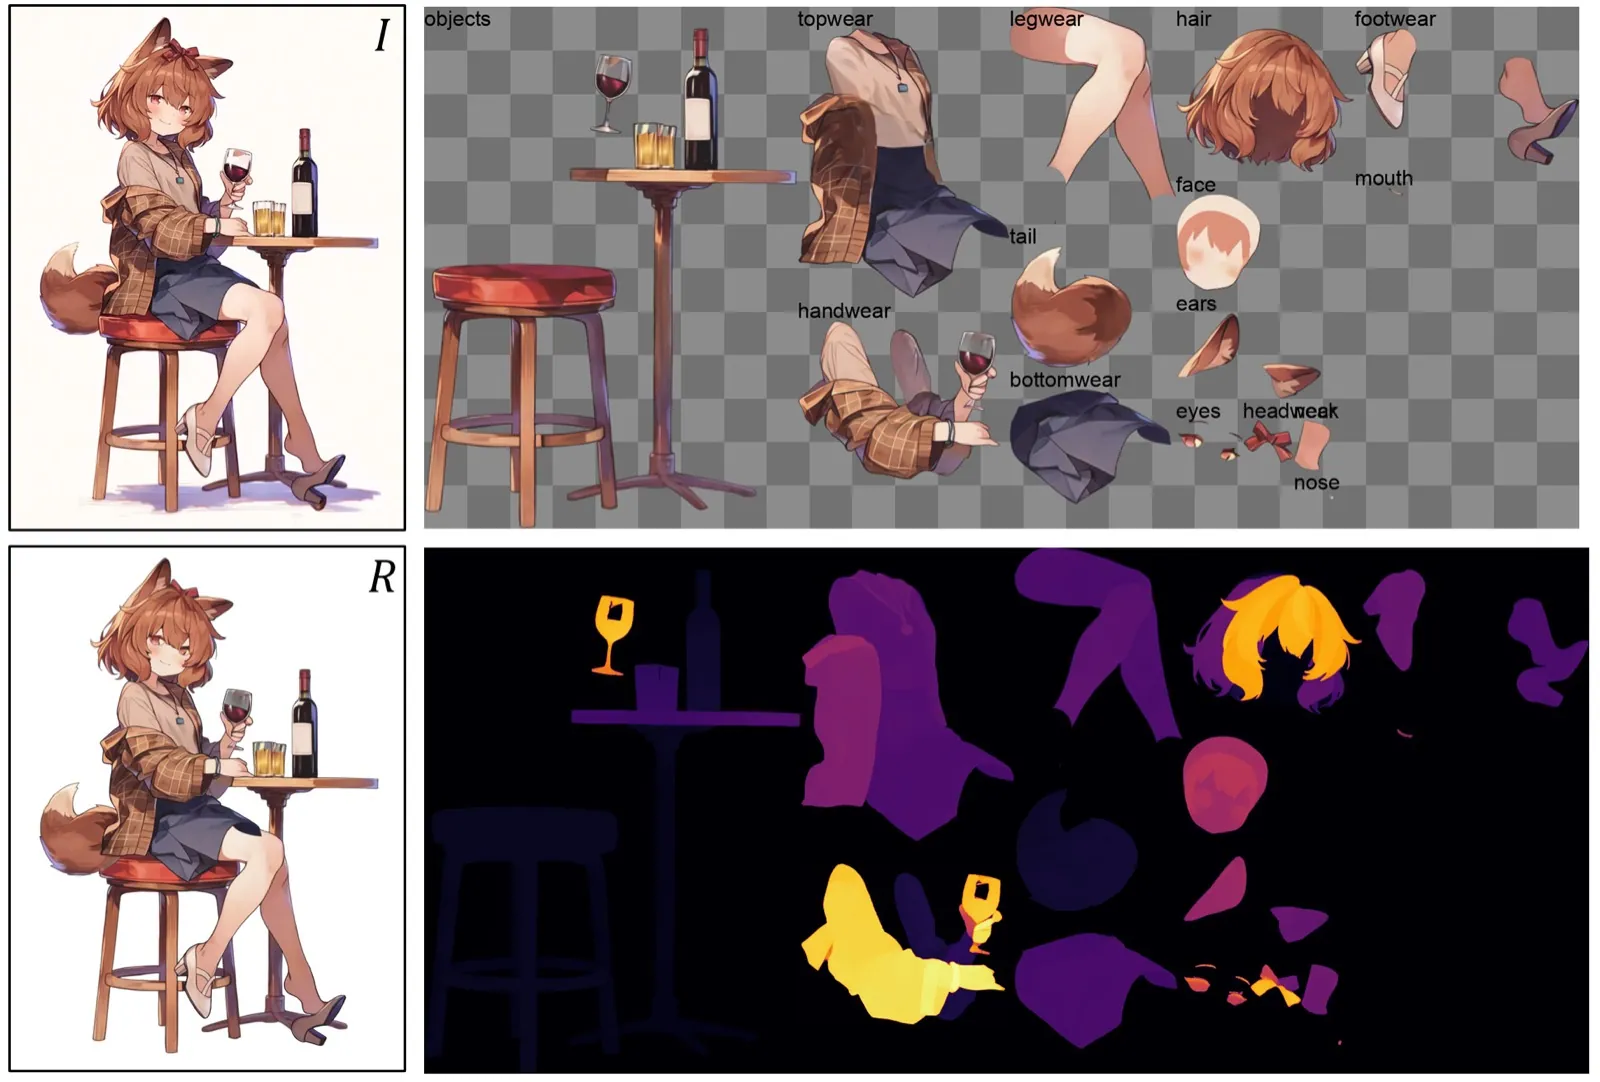
Delar upp en enda bild av en animefigur i upp till 23 färdigmålade lager, som hår, ansikte, ögon och kläder, så att den kan animeras som en 2,5D-modell.
- Bildredigering
- Animation & rörelse
 1 / 2
En animefigur uppdelad i lager med See-through [1]
Om See-through[1][2][3][4]
See-through är ett forskningsprojekt som gör om en vanlig, platt bild av en animefigur till en 2,5D-modell som går att röra. Modellen delar upp bilden i upp till 23 lager, till exempel hår, ansikte, ögon, kläder och accessoarer, räknar ut i vilken ordning lagren ligger och målar själv i de delar som var dolda bakom något annat. Resultatet sparas som en PSD-fil med lager, redo att användas i animeringsprogram.
I dag görs det här för hand: man klipper isär figuren och ritar till det som skyms. För att få träningsdata använde forskarna kommersiella Live2D-modeller, där varje del redan finns som ett eget lager. Metoden kombinerar en diffusionsmodell som håller ihop kroppsdelarna med en uppskattning av djup för varje pixel, vilket bland annat löser hur hårslingor ligger framför och bakom ansiktet.
Arbetet kommer främst från Saint Francis University i Hongkong, med medverkan från University of Pennsylvania, Spellbrush och Shitagaki Lab, där koden ligger. Det har publicerats på SIGGRAPH 2026. Koden är Apache 2.0, vikterna finns på Hugging Face (lagermodellen under OpenRAIL++), och det finns gratisdemor på Hugging Face och ModelScope. Forskarna varnar för webbplatser som tar betalt för tjänsten, eftersom de inte driver någon betaltjänst.
Det viktigaste[1][2]
- Delar en enda animebild i upp till 23 lager, med dolda delar ifyllda och rätt ordning mellan lagren.
- Resultatet blir en PSD-fil med lager som kan användas för animering i realtid.
- Tränad med hjälp av kommersiella Live2D-modeller där delarna redan finns som separata lager.
- Publicerad på SIGGRAPH 2026.
- Gratisdemor på Hugging Face (1–2 körningar per dag) och ModelScope.
Källor
- [1] See-through: Single-image Layer Decomposition for Anime Characters ↗Shitagaki Lab Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] Gemma 4, Claude Code leak, Qwen 3.6, Wan 2.7, OmniVoice, DreamLite, GLM-5V: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 5 apr 2026 Läst 25 okt 2026
- [3] layerdifforg/seethroughv0.0.2_layerdiff3d ↗Hugging Face (layerdifforg) Modellkort huggingface.coPublicerad 9 mar 2026 Läst 25 okt 2026
- [2] See-through: Single-image Layer Decomposition for Anime Characters ↗arXiv Forskningsartikel arxiv.orgPublicerad 3 feb 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-05). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.