SenseNova U1.5 8B MoT
SenseTimes öppna multimodala modell som både förstår och skapar bilder i en och samma arkitektur, med inbyggd 4K-bildgenerering, bättre text i bilder och mer exakt bildredigering.
- Bildgenerering
- Bildredigering
- Bildförståelse
- Multimodal
 1 / 4
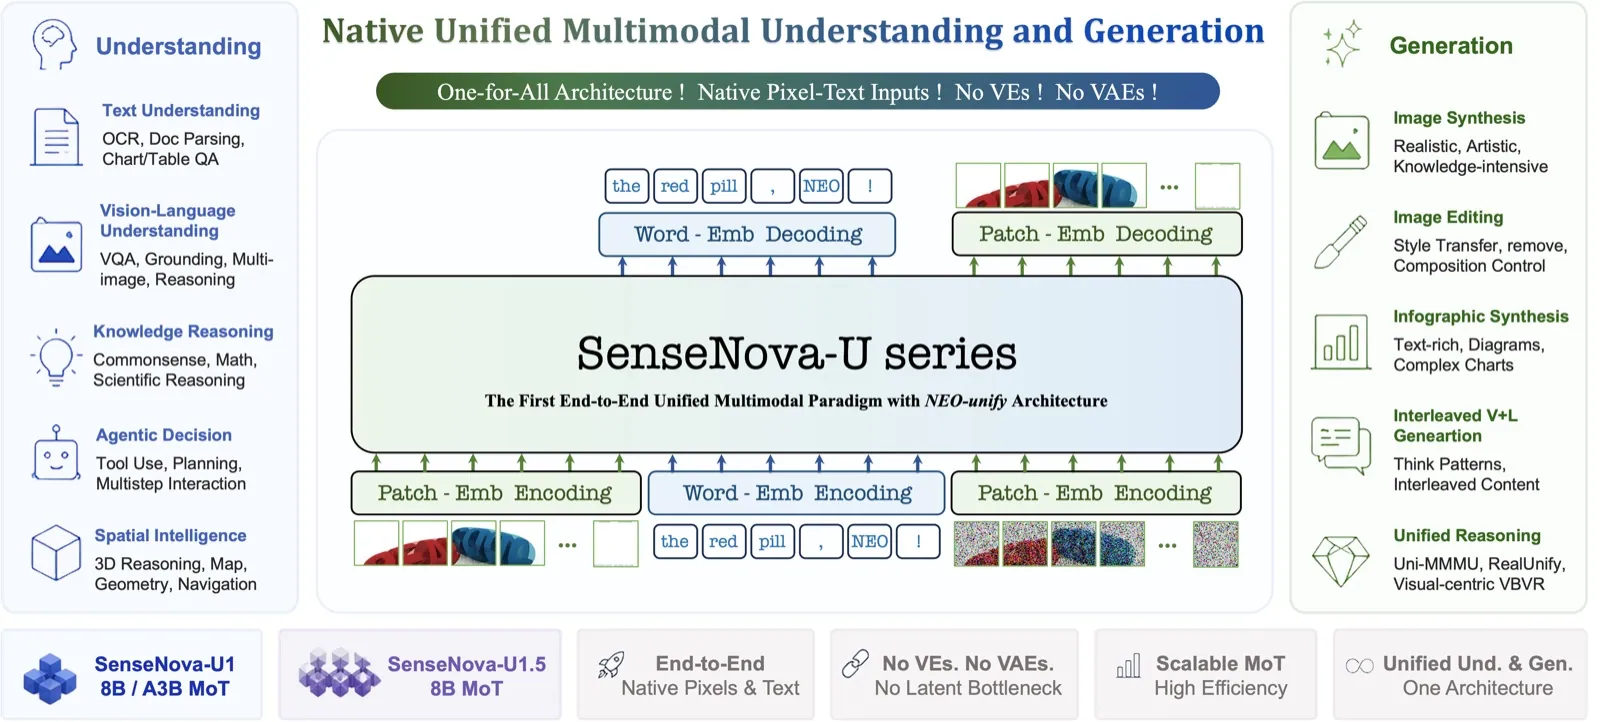
Översikt över SenseNova-U-serien: förståelse och generering i en arkitektur [1]
Om SenseNova U1.5 8B MoT[1][2][4]
SenseNova-U1.5-8B-MoT är den senaste versionen i SenseTimes SenseNova-U-serie av så kallade enhetliga multimodala modeller: samma modell läser text och bilder och kan också skapa och redigera bilder. Den bygger på arkitekturen NEO-unify, som arbetar direkt med pixlar och text utan separat bildkodare (VE) och utan VAE, alltså utan den komprimerade mellanform som de flesta bildmodeller använder.
"8B-MoT" betyder enligt GitHub-sidan ungefär 8 miljarder parametrar för förståelse plus ungefär 8 miljarder för generering. Hugging Face räknar totalt cirka 17,5 miljarder parametrar i filerna. Förkortningen MoT förklaras inte på de officiella sidorna.
Jämfört med SenseNova-U1 har SenseTime förbättrat bildkvaliteten (komposition, färg, material, ljus och detaljer), text i bilder som affischer och infografik på både kinesiska och engelska, och att modellen kan skapa bilder direkt i 4K. Vid redigering ska den bättre bevara personers utseende och det som inte ska ändras, och den kan styras med rutor, markeringar och en eller flera referensbilder. Modellkortet listar också kända svagheter: övermättade bilder, fel i tät text, ostadiga händer och ansikten och att komplexa redigeringar kan glida iväg.
En förhandsversion släpptes 31 juli 2026 och den officiella versionen 20 augusti 2026, tillsammans med en variant som bara behöver 8 steg. Vikterna ligger under Apache 2.0 på Hugging Face och ModelScope, och den tekniska rapporten (arXiv 2609.11929) kom i september.
Det viktigaste[1][2]
- Förstår och skapar bilder i samma modell, utan separat bildkodare och utan VAE (arkitekturen NEO-unify).
- Kan enligt SenseTime skapa bilder direkt i 4K och skriver bättre text på kinesiska och engelska i affischer och infografik.
- Redigering kan styras med rutor, markeringar och flera referensbilder.
- Enligt GitHub-sidan cirka 9 sekunder för en bild i 2048 × 2048 pixlar på H100/H200-kort.
- Öppna vikter under Apache 2.0, plus en snabbare variant som klarar sig med 8 steg.
Källor
- [2]
- [3]
- [4] Deepseek Vision, Ornith 1.5, GEN 1.5, Happy Shrimp, SenseNova U1.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 23 aug 2026 Läst 25 okt 2026
- [1] sensenova/SenseNova-U1.5-8B-MoT ↗SenseNova (Hugging Face) Modellkort huggingface.coPublicerad 19 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-23). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.