Supra2-IMG
En mycket liten öppen bildmodell på cirka 104 miljoner parametrar som skapar bilder på 256 × 256 pixlar från text, tänkt för experiment och lärande.
- Bildgenerering
- Kör lokalt
 1 / 3
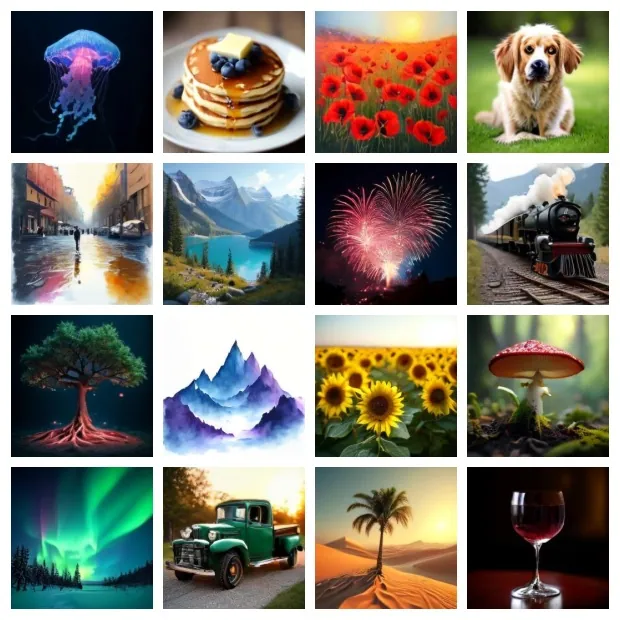
Exempelbilder skapade med Supra2-IMG [1]
Om Supra2-IMG[1][2]
Supra2-IMG är en liten text-till-bild-modell från SupraLabs, tränad från grunden. Själva bildnätverket är en diffusionstransformer (DiT) med cirka 104 miljoner parametrar, vilket är mycket litet jämfört med vanliga bildmodeller som ofta har flera miljarder. Texten tolkas av en fryst Flan-T5-Base, och bilderna packas ihop och upp med Stable Diffusions VAE. Bilderna blir 256 × 256 pixlar.
Modellen tränades i tio omgångar på hela datasetet FLUX-Reason-6M, cirka 5,6 miljoner syntetiska bilder, på ett enda Nvidia H100-kort i ungefär nio timmar inklusive förberedelser. Enligt SupraLabs når den FID 27,9 och CLIP-poäng 29,4. Modellkortet kallar kvaliteten "SOTA", men jämför inte med andra modeller.
Vikterna är öppna under Apache 2.0 på Hugging Face. Det finns ingen färdig molntjänst; man kör modellen själv med ett skript.
Det viktigaste[1]
- Bara cirka 104 miljoner parametrar i bildnätverket; skapar bilder på 256 × 256 pixlar.
- Tränad från grunden på 5,6 miljoner syntetiska bilder på ett enda H100-kort i cirka nio timmar.
- Enligt SupraLabs FID 27,9 och CLIP-poäng 29,4.
- Öppna vikter under Apache 2.0, lämplig för att experimentera och lära sig.
Källor
- [2] GPT 6 Sol, Gemini 3.8 TTS, Grok 4.7, Opus 5.5, Mimo 2.6, WorldCrafter: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 27 sep 2026 Läst 25 okt 2026
- [3] Waifus incoming, GPT 6 Sol, Grok 4.7, Opus 5.5, Mimo 2.6, Step 5, OpenMuse: AI NEWS ↗AI Search Video youtube.comPublicerad 26 sep 2026 Läst 25 okt 2026
- [1] SupraLabs/Supra2-IMG ↗SupraLabs (Hugging Face) Modellkort huggingface.coPublicerad 21 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-09-26). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.