Unpaired Rosetta
En metod som kopplar ihop separat tränade bild- och textmodeller utan ett enda matchat exempel, genom att utnyttja att de ordnar information på liknande sätt.
- Multimodal
- Bildgenerering
- Forskning & vetenskap
 1 / 2
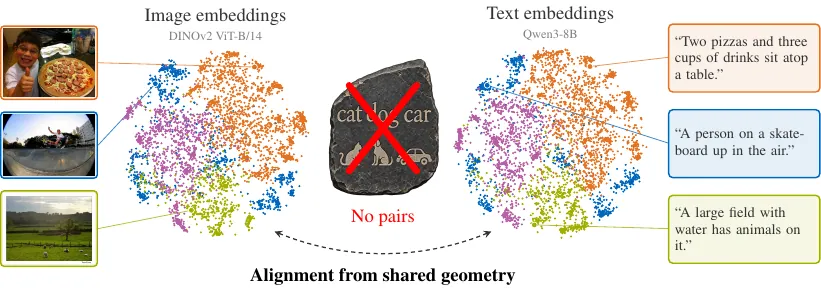
Bilder och bildtexter från separata modeller placeras i samma rum utan matchade par [1]
Om Unpaired Rosetta[1][2][3][4]
Unpaired Rosetta, i artikeln kallad Shared Geometry as a Rosetta Stone, visar att man kan koppla ihop en bildmodell och en språkmodell som tränats helt var för sig, utan att ha några par av bilder och bildtexter. Normalt kräver sådan koppling stora mängder matchade exempel, som i CLIP.
Idén bygger på den så kallade platonska representationshypotesen: modeller som tränats på olika slags data tenderar att ordna sin kunskap på liknande sätt. Metoden grupperar först bilderna och texterna var för sig och matchar grupperna så att avstånden mellan dem stämmer så bra som möjligt. Därefter förfinas en enda rotation, en så kallad Wasserstein Procrustes-avbildning, som flyttar bildernas representationer till textens rum.
Enligt forskarna ger metoden en grov men användbar koppling mellan flera olika bild- och språkmodeller, även när bilderna och texterna kommer från olika datamängder. När bara ett fåtal par finns (högst omkring tusen) slår den tidigare metoder med bred marginal. De visar också att kopplingen räcker för att generera bilder från text utan matchade träningsexempel, och att metoden fungerar för andra kombinationer, bland annat vetenskapliga och medicinska data.
Arbetet kommer från TU Munich och MCML tillsammans med Ulm University, ETH Zurich och MIT. Koden är öppen under MIT-licens och det finns en anteckningsbok som går att köra i Google Colab.
Det viktigaste[1][2][3]
- Kopplar ihop separat tränade bild- och textmodeller utan några matchade exempel.
- Använder att modellerna ordnar information på liknande sätt, och lär sig en enda rotation mellan dem.
- Enligt forskarna klart bättre än tidigare metoder när bara ett fåtal matchade par finns.
- Visar att kopplingen räcker för text-till-bild-generering utan matchade träningsexempel.
- Öppen kod under MIT-licens, med en färdig Colab-anteckningsbok.
Källor
- [1] Shared Geometry as a Rosetta Stone: Cross-Modal Alignment Without Paired Data ↗GitHub (dominik-schnaus) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [3] Shared Geometry as a Rosetta Stone ↗TU Munich, MCML, Ulm University, ETH Zurich och MIT Officiell sida dominik-schnaus.github.ioPublicerad okänt datum Läst 25 okt 2026
- [4] OpenAI math breakthroughs, AlphaProtein Novo, Botanic-1, Iris 3B, Kandinsky 6.0: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 11 okt 2026 Läst 25 okt 2026
- [2] Shared Geometry as a Rosetta Stone: Cross-Modal Alignment Without Paired Data ↗arXiv Forskningsartikel arxiv.orgPublicerad 7 okt 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-10-11). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.