Viggle-Animate
Viggles öppna modell som byter ut en figur i en video mot den figur man målat in i en av videons bildrutor, med samma rörelser, kamera och tajming.
- Videogenerering
- Animation & rörelse
- Bildredigering
 1 / 6
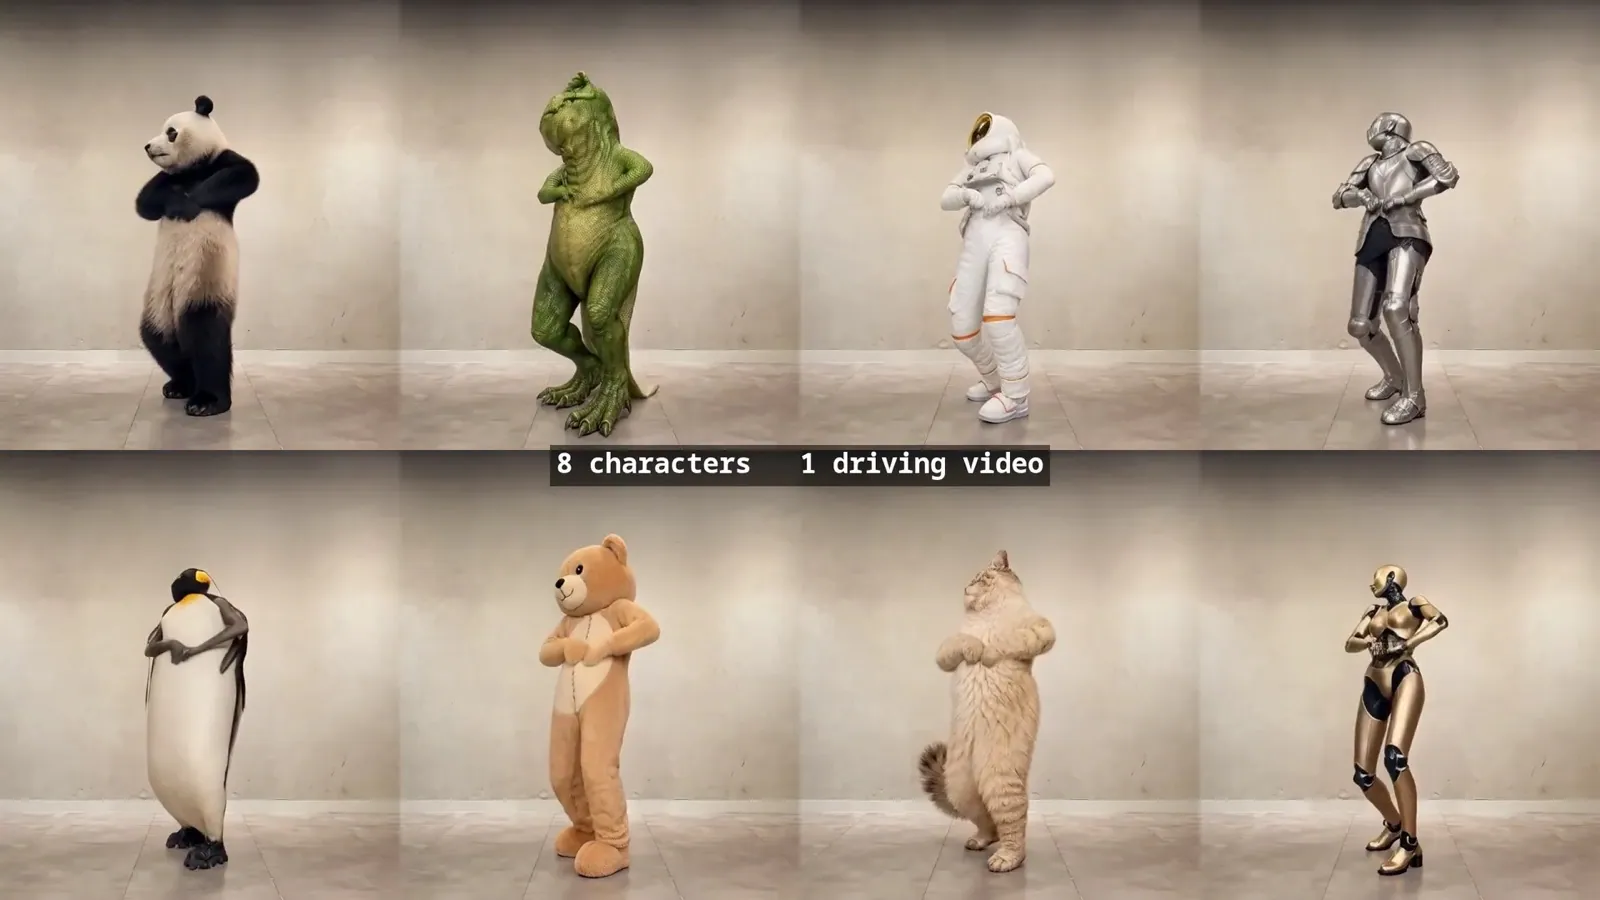
Åtta olika figurer som alla följer samma video [2]
Om Viggle-Animate[1][2][3]
Viggle-Animate byter ut en karaktär i en video. Man tar en bildruta ur videon, målar om figuren i den med valfritt bildverktyg (till exempel en bildgenerator) så att den blir en panda, en robot eller en tecknad figur, och modellen gör sedan om hela videon så att den nya figuren rör sig exakt som originalet. Kamerarörelser och tajming behålls.
Till skillnad från många liknande verktyg behövs ingen skelettanalys av poser, inga masker, ingen ansiktsspårning och ingen textprompt i videosteget. Modellen har 33,1 miljarder parametrar och är en fullständig finjustering av Minimax videomodell MiniMax-H3. Enligt Viggle tar ett klipp på 124 bilder (cirka 5 sekunder i 480 × 832) ungefär 26 sekunder på ett NVIDIA B200, ungefär sex gånger snabbare än Wan2.2-Animate-14B. Den kräver mycket grafikminne: ett kort med 80 GB räcker inte, Viggle rekommenderar 96 GB eller mer, men det finns ett långsammare läge som klarar sig med omkring 12 GB.
Viggle skriver öppet om begränsningarna: resultatet blir aldrig bättre än den ommålade bilden, läppsynken var svag i den släppta inställningen (men blir bättre om man skickar med ljudspåret), och scener med flera figurer, nära samspel eller klipp blir sämre. Enligt modellkortet tränas en bättre modell redan.
Vikterna ligger på Hugging Face under MiniMax H3 Community License, medan koden är under Apache 2.0. Det finns en demo på Hugging Face och ComfyUI-noder från communityn.
Det viktigaste[4][1][2]
- Obs: bygger på MiniMax H3, vars licens inte gäller i EU, Storbritannien, Sydkorea eller USA. För användning i Sverige krävs en separat licens från MiniMax, som de enligt licensen kan bevilja efter förfrågan.
- Byter figur i en video utifrån en enda ommålad bildruta ur samma video.
- Behöver ingen posanalys, mask, ansiktsspårning eller textprompt.
- Enligt Viggle tar 124 bilder ungefär 26 sekunder på ett B200, cirka sex gånger snabbare än Wan2.2-Animate-14B.
- 33,1B parametrar, en finjustering av MiniMax-H3, med öppna vikter.
- Läppsynk och scener med många figurer är fortfarande svåra, enligt Viggle.
Källor
- [4] MiniMax H3 Community License Agreement ↗MiniMax Officiell sida huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [3] GPT 6 Astra, Claude Fable 5.1, Qwen 3.8 0902, Gemini 3.8 Flash, Muse Spark 1.3, Atlas: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 6 sep 2026 Läst 25 okt 2026
- [2] Viggle-Animate: character replacement from a repainted frame ↗Viggle Research Officiell sida viggle.aiPublicerad 4 sep 2026 Läst 25 okt 2026
- [1] Viggle/Viggle-Animate ↗Viggle (Hugging Face) Modellkort huggingface.coPublicerad 31 aug 2026 Läst 25 okt 2026