VocalRender
En öppen sångsyntesmodell som gör om ett vanligt notblad med text, tonhöjder, notvärden och tempo direkt till uttrycksfull sång.
- Musik & ljud
- Text till tal
 1 / 2
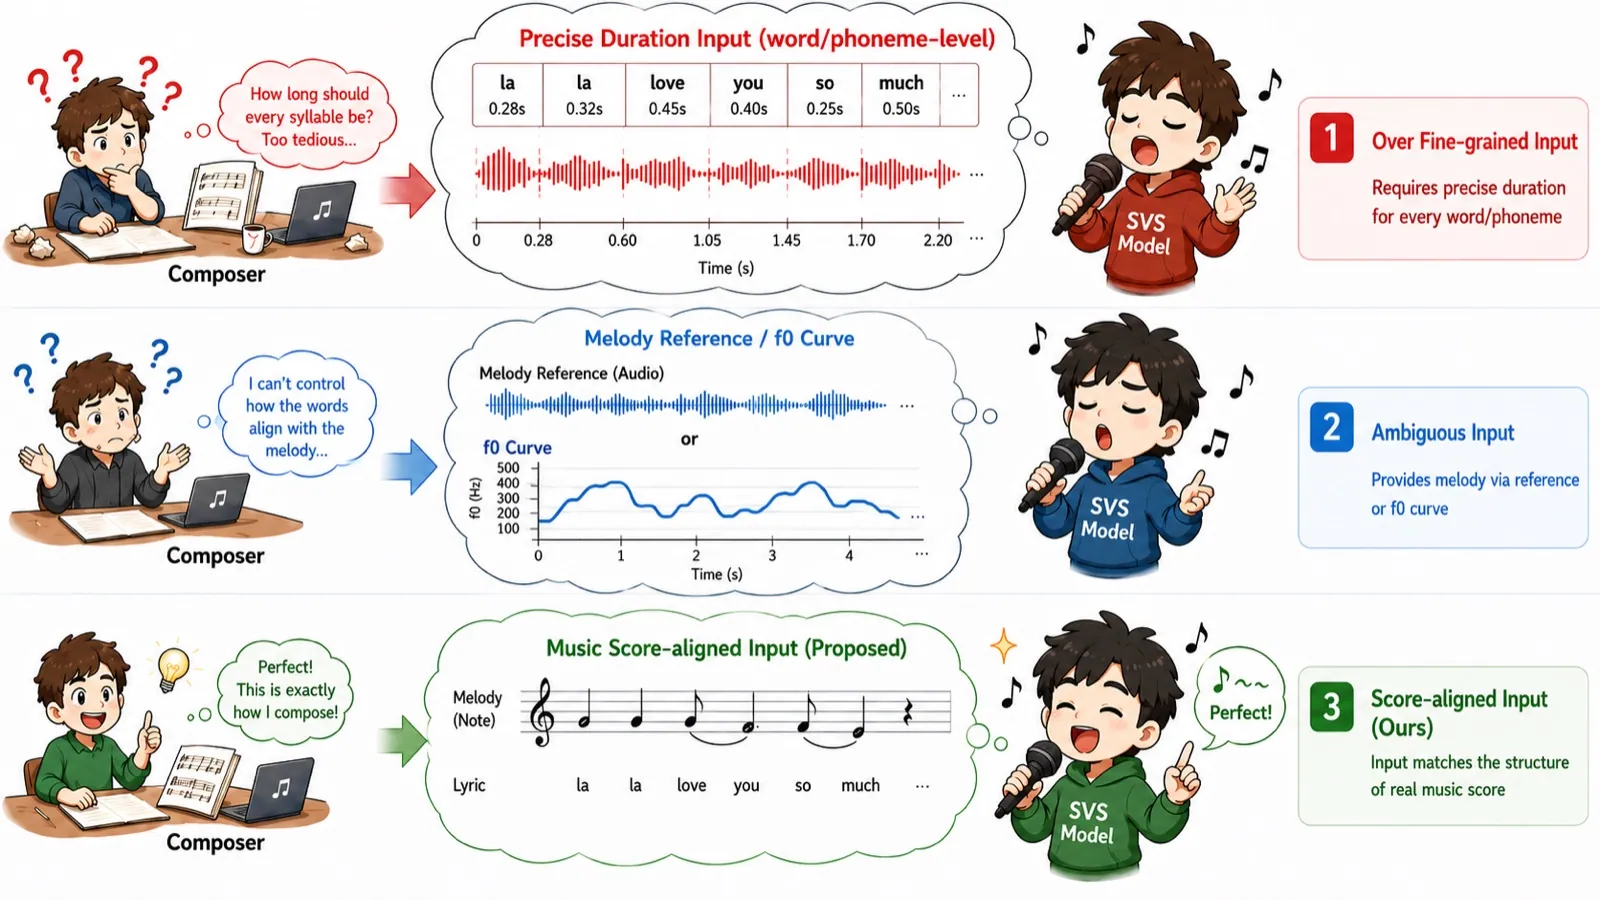
Tre sätt att styra sångsyntes: med längder per ljud, med ljudreferens, eller direkt från noter som i VocalRender [3]
Om VocalRender[1][2][3][4][5]
VocalRender gör sång av samma information som en kompositör skriver ner: sångtext, MIDI-tonhöjder, notvärden och tempo. Många andra sångsyntessystem kräver att man anger exakt hur länge varje ljud eller stavelse ska vara, eller att man har en tidsanpassad ljudreferens eller tonhöjdskurva. VocalRender klarar sig utan det och bestämmer själv timing och uttryck medan den följer noterna.
Modellen läser ett notformat där varje stavelse följs av sina tonhöjder och notlängder, vilket bevarar kopplingen mellan text och noter även när en stavelse sträcks över flera toner. Sången byggs upp steg för steg av en transformer som skissar frasering och längd, medan en mindre diffusionsmodell fyller i detaljer som tonhöjd, klangfärg och artikulation. Resultatet blir ljud i 48 kHz. Ett kort ljudklipp med en sångröst, 2–8 sekunder, styr vilken röst som används.
Modellen är tränad på omkring 2 300 timmar sång och bygger på talmodellen VoxCPM2. Enligt forskarna slår den den starkaste jämförelsemodellen med 0,42 poäng i ett lyssningstest av naturlighet. Två versioner finns: VocalRender och VocalRender-Pro, som har samma storlek men tränats längre på mer riktig sång. Vikterna, cirka 9,5 GB per version, och koden är öppna under Apache 2.0, och det finns en webbdemo med pianorulle där man kan skriva in noter.
Arbetet kommer från Xi'an Jiaotong University tillsammans med Nanyang Technological University, Ant Group och Zhejiang University.
Det viktigaste[2][3]
- Gör sång direkt från sångtext, tonhöjder, notvärden och tempo, utan att man anger längden på varje ljud.
- Ett kort röstklipp på 2–8 sekunder bestämmer vilken röst som sjunger.
- Enligt forskarna 0,42 poäng bättre i naturlighet än den starkaste jämförelsemodellen.
- Två öppna versioner, VocalRender och VocalRender-Pro, under Apache 2.0.
- Webbdemo med pianorulle och import av ABC- och MusicXML-noter.
Källor
- [1] VocalRender — Audio Demo ↗VocalRender (Xi'an Jiaotong University m.fl.) Officiell sida pymaster17.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] pymaster17/VocalRender ↗GitHub (pymaster17) Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [5] WeatherNext, Xiaomi Robotics, Qwen 3.8, Wan Animate 2, SymphonyGen: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 9 aug 2026 Läst 25 okt 2026
- [2] VocalRender: Score-Native Singing Voice Synthesis for Real-World Composition ↗arXiv Forskningsartikel arxiv.orgPublicerad 30 jul 2026 Läst 25 okt 2026
- [4] pymaster/VocalRender ↗Hugging Face (pymaster) Modellkort huggingface.coPublicerad 30 jul 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-09). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.