VoiceMem
Ett öppet minnessystem för röstassistenter som minns både fakta och känslor, och hämtar minnen medan användaren fortfarande pratar.
- Minne
- Röstassistent
 1 / 5
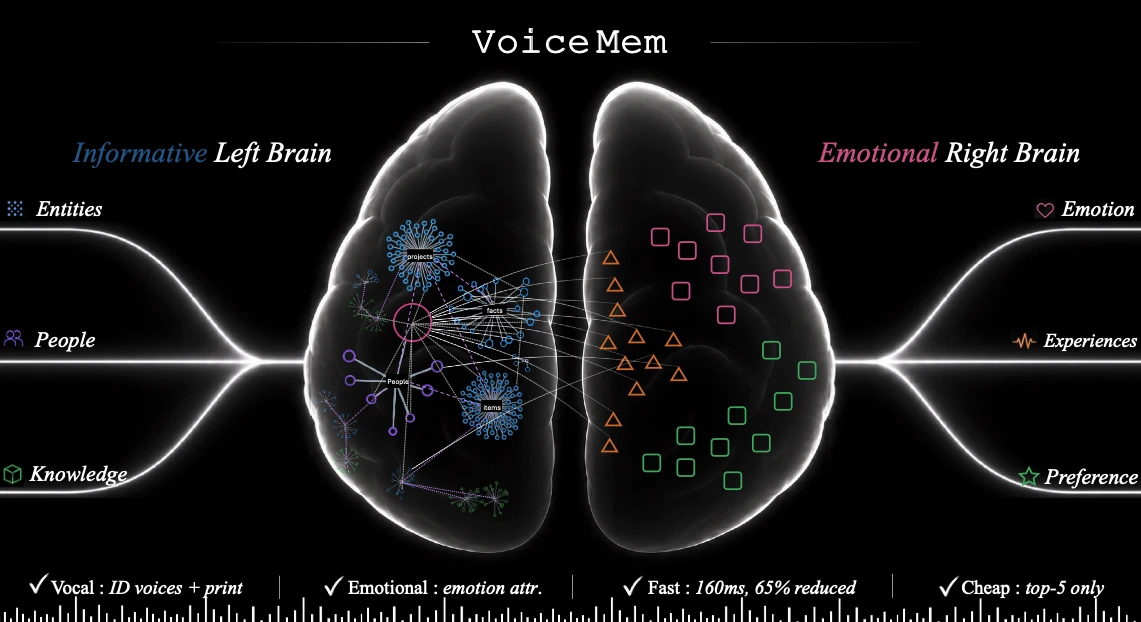
Översikt över VoiceMem [3]
Om VoiceMem[1][2][3][5]
VoiceMem ger röstassistenter ett minne, så att de vet vem de pratar med nästa gång. Systemet har två delar som kallas hjärnhalvor. Den vänstra håller ordning på fakta, personer och kunskap. Den högra håller reda på känslor, preferenser och personlighet, både på kort och lång sikt.
Allt sker strömmande: medan användaren fortfarande pratar delas ljudet upp, skrivs ut, analyseras och sparas i en minnesgraf. När assistenten ska svara väljs först rätt slags minne och sedan rankas de bästa, och bara de fem mest relevanta läggs in i modellens sammanhang. Det håller nere mängden text som skickas till språkmodellen. Systemet minns också talare, ljudhändelser, samtal med flera personer och musik.
Enligt projektet når VoiceMem 91,2 procent på testet LoCoMo jämfört med 61,68 procent för Mem0, svarar på 134 millisekunder jämfört med 1 440 för Mem0 och använder 430 minnestokens jämfört med 6 956 för Mem0. På PersonaMem, som mäter förståelse av personer, når det 69,44 procent. Forskarna har också tagit fram datamängden ChatMem-400K och tränat röstmodeller som Qwen2.5-Omni, Qwen3-Omni och Step-Audio2-Mini att själva använda minnet.
Koden är öppen under Apache 2.0 och kan installeras med pip. I projektets exempel används en OpenAI-nyckel för språkmodellen, men alla delar går enligt projektet att byta ut. Arbetet leds av forskare vid Nanyang Technological University tillsammans med bland annat National University of Singapore, Tsinghua University och The Chinese University of Hong Kong.
Det viktigaste[1][2][3]
- Två hjärnhalvor: en för fakta och en för känslor, preferenser och personlighet.
- Hämtar minnen medan användaren fortfarande pratar.
- Enligt projektet 91,2 procent på LoCoMo mot 61,68 procent för Mem0, med svar på 134 millisekunder.
- Använder bara cirka 430 minnestokens per tur, mot 6 956 för Mem0.
- Öppen kod under Apache 2.0, plus datamängden ChatMem-400K och minnestränade röstmodeller.
Källor
- [1] VoiceMem — The Soul of Voice AI ↗VoiceMem (Nanyang Technological University m.fl.) Officiell sida xzf-thu.github.ioPublicerad okänt datum Läst 25 okt 2026
- [5] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [3] xzf-thu/VoiceMem ↗GitHub (xzf-thu) Officiell sida github.comPublicerad 27 aug 2026 Läst 25 okt 2026
- [2] VoiceMem: Streaming Dual-Brain Memory for Real-Time Interaction ↗arXiv Forskningsartikel arxiv.orgPublicerad 26 aug 2026 Läst 25 okt 2026
- [4] zhifeixie/VoiceMem_MF_Qwen3_6_35B_A3B_Qlora ↗Hugging Face (zhifeixie) Modellkort huggingface.coPublicerad 20 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Nanyang Technological University (NTU)
- Prompt Relay 11 apr 2026