ZGCM-1
En helt öppen språkmodell på 7,39 miljarder parametrar för matematik och sökning med verktyg, där både vikter, träningsdata och träningskod är släppta.
- Språkmodell
- Resonemang
- Sök & kunskap
- Agenter
- Kör lokalt
 1 / 3
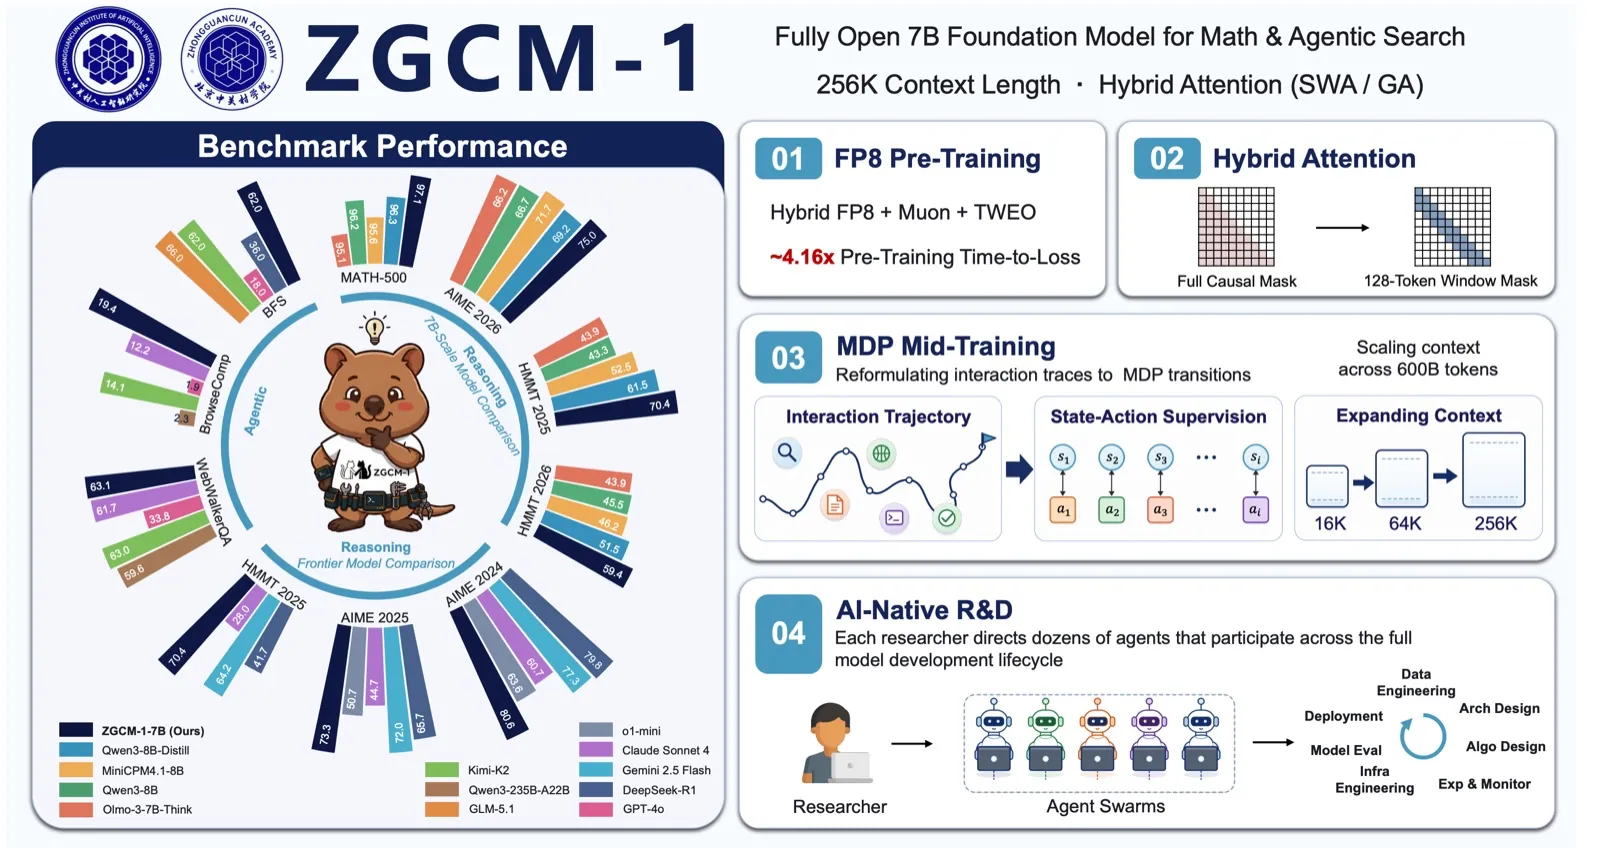
Översikt: testresultat och de viktigaste tekniska delarna i ZGCM-1 [1]
Om ZGCM-1[1][2][4]
ZGCM-1 är en språkmodell från Zhongguancun Academy och Zhongguancun Institute of Artificial Intelligence i Peking. Den har 7,39 miljarder parametrar, är tränad från grunden och byggd för matematiskt resonemang och för att söka information med verktyg, till exempel genom att söka på webben och läsa sidor i flera steg. Den klarar upp till 256 000 tokens i sammanhang och har både ett läge där den tänker efter innan den svarar och ett läge där den svarar direkt.
Modellen använder en blandning av två sorters uppmärksamhet: de flesta lager tittar bara på de närmaste 128 tokens, och några få lager ser hela texten. Enligt rapporten gör det träningen på långa texter nästan fyra gånger snabbare än vanlig uppmärksamhet. Den är förtränad på omkring 4,19 biljoner tokens och sedan tränad vidare på omkring 600 miljarder tokens med allt längre sammanhang. Enligt projektet har AI-agenter, styrda av forskarna, deltagit i hela utvecklingen, från datahantering till utvärdering.
Enligt den tekniska rapporten når ZGCM-1 97,13 % på MATH-500, 75,00 % på AIME 2026 och 70,42 % på HMMT 2025, och har bäst genomsnittlig placering på 14 resonemangstest bland sju jämförda modeller i storleken 7–8 miljarder parametrar. På sökning med verktyg når den 63,09 % på WebWalkerQA och 19,43 % på BrowseComp.
Projektet är helt öppet: vikter och träningsdata finns på Hugging Face och koden för databehandling, förträning, vidareträning och finjustering finns på GitHub, allt under MIT-licens.
Det viktigaste[1][2]
- Helt öppen: vikter, träningsdata, träningskod och träningsloggar är släppta, under MIT-licens.
- 7,39 miljarder parametrar och upp till 256 000 tokens i sammanhang.
- Både ett tänkande läge och ett läge med direkta svar i samma modell.
- Enligt rapporten 97,13 % på MATH-500 och 75,00 % på AIME 2026.
- Enligt rapporten bäst genomsnittlig placering på 14 resonemangstest bland sju jämförda modeller i storleken 7–8B.
- Kan söka på webben och läsa sidor i upp till 64 steg; enligt rapporten 63,09 % på WebWalkerQA.
Källor
- [1] ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search ↗Zhongguancun Academy Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] OpenAI hacked, Jev, Dream RSI, Qwen 3.8 Omni, Gemini 3.8 Live, Bonsai 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 20 sep 2026 Läst 25 okt 2026
- [2] ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search ↗arXiv Forskningsartikel arxiv.orgPublicerad 11 sep 2026 Läst 25 okt 2026
- [3] zgcagi/ZGCM-1-7B ↗Hugging Face (zgcagi) Modellkort huggingface.coPublicerad 7 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-20). [4]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.