4DAnyone
Gör om en vanlig video av en person, filmad med en enda kamera, till en 4D-modell som kan ses från nya vinklar medan personen rör sig.
- 3D
- Animation & rörelse
- Videogenerering
 1 / 5
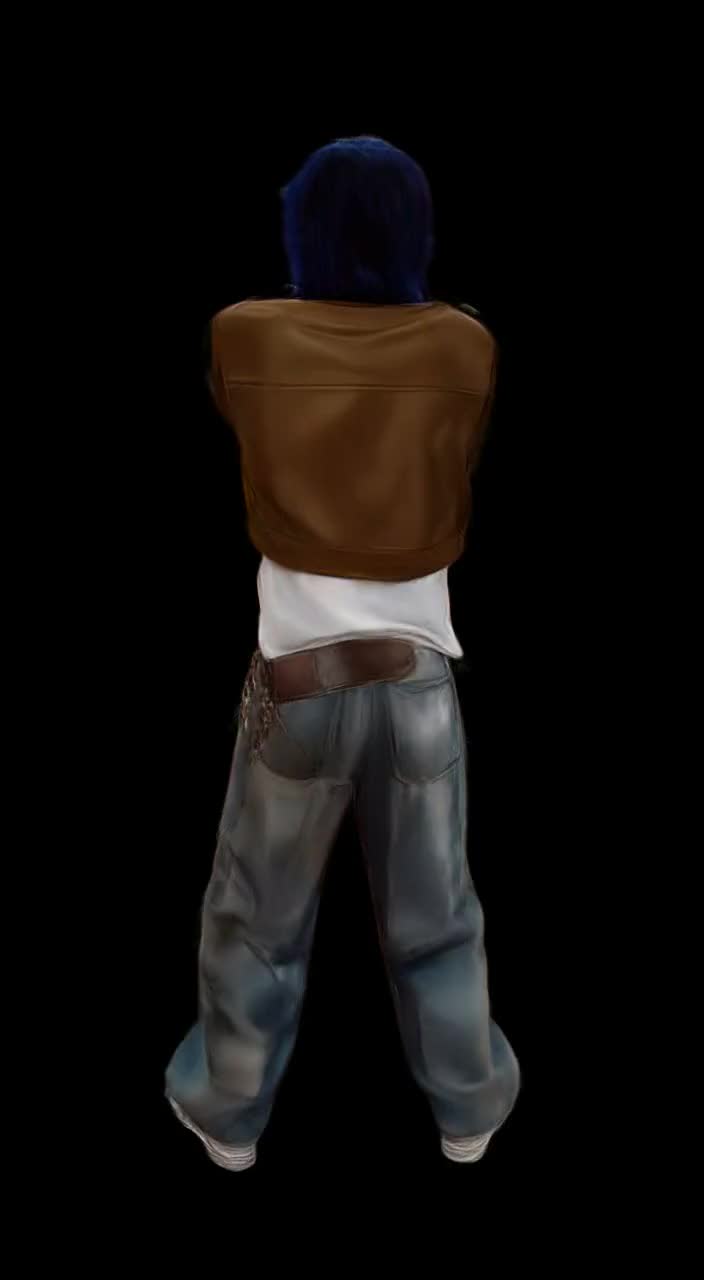
Rendering av en person från den färdiga 4D-modellen (4D Gaussian Splatting) [1]
Om 4DAnyone[1][2][3][5]
4DAnyone är ett forskningsprojekt som återskapar människor i 4D, alltså i 3D över tid, från en helt vanlig video. Normalt kräver sådana modeller en uppsättning synkroniserade och kalibrerade kameror runt personen. 4DAnyone klarar sig med en enda video, utan kända kamerainställningar och utan stativ, genom att i stället generera de videor som en sådan kamerarigg skulle ha spelat in.
Det svåra är att de genererade vyerna måste hänga ihop tillräckligt bra för att man ska kunna bygga en 4D-modell av dem, och det kräver tiotals vyer. Forskarna löser det med två tekniker som komprimerar och delar information mellan grupper av vyer, och med ett 3D-skelett från originalvideon som styr genereringen i varje vy. De färdiga videorna används sedan för att träna en 4D Gaussian Splatting-modell.
Enligt projektsidan presterar 4DAnyone bättre än tidigare metoder både i videokvalitet från nya vinklar och i den slutliga 4D-rekonstruktionen. Efter lanseringen har forskarna släppt en snabbare destillerad version, 4DAnyone-Turbo, minskat minnesbehovet så att modellen går att köra på ett RTX 4090 och lagt till ett grafiskt gränssnitt.
Arbetet kommer från Zhejiang University, Robbyant och Ant Group, HKUST och CUHK, och har antagits till SIGGRAPH Asia 2026. Koden ligger hos Ant Research på GitHub.
Det viktigaste[1][3]
- Kräver bara en vanlig video med en kamera: ingen kalibrering, inga kända kamerapositioner och inget stativ.
- Genererar dussintals nya vyer runt personen som sedan blir en 4D Gaussian Splatting-modell.
- Ett 3D-skelett från originalvideon styr genereringen, vilket enligt forskarna ger bättre resultat på vardagsvideor än djupuppskattningar.
- 4DAnyone-Turbo (släppt 2 september 2026) avbrusar enligt GitHub-sidan 5,58 gånger snabbare än basversionen.
- Enligt GitHub-sidan räcker under 24 GB grafikminne, och en video på 121 bildrutor tar i snitt 27 sekunder på ett RTX 4090.
- Antagen till SIGGRAPH Asia 2026.
Källor
- [1] 4DAnyone: Create Anyone in 4D from a Casual Monocular Video ↗Zhejiang University, Robbyant, Ant Group, HKUST och CUHK Officiell sida 4danyone.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] 4DAnyone: Create Anyone in 4D from a Casual Monocular Video ↗Ant Research Officiell sida github.comPublicerad okänt datum Läst 25 okt 2026
- [4] AntResearch/4DAnyone ↗Hugging Face (AntResearch) Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] Deepseek Vision, Ornith 1.5, GEN 1.5, Happy Shrimp, SenseNova U1.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 23 aug 2026 Läst 25 okt 2026
- [2] 4DAnyone: Create Anyone in 4D from a Casual Monocular Video ↗arXiv Forskningsartikel arxiv.orgPublicerad 20 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-23). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Robbyant
- Zero-WAM 26 aug 2026
- LingBot-World 2.0 9 jul 2026