Zero-WAM
En robotmodell som lär sig nya uppgifter genom att titta på en video av en människa som gör dem, i stället för att få en otydlig textinstruktion.
- Robotik
- Världsmodeller
 1 / 5
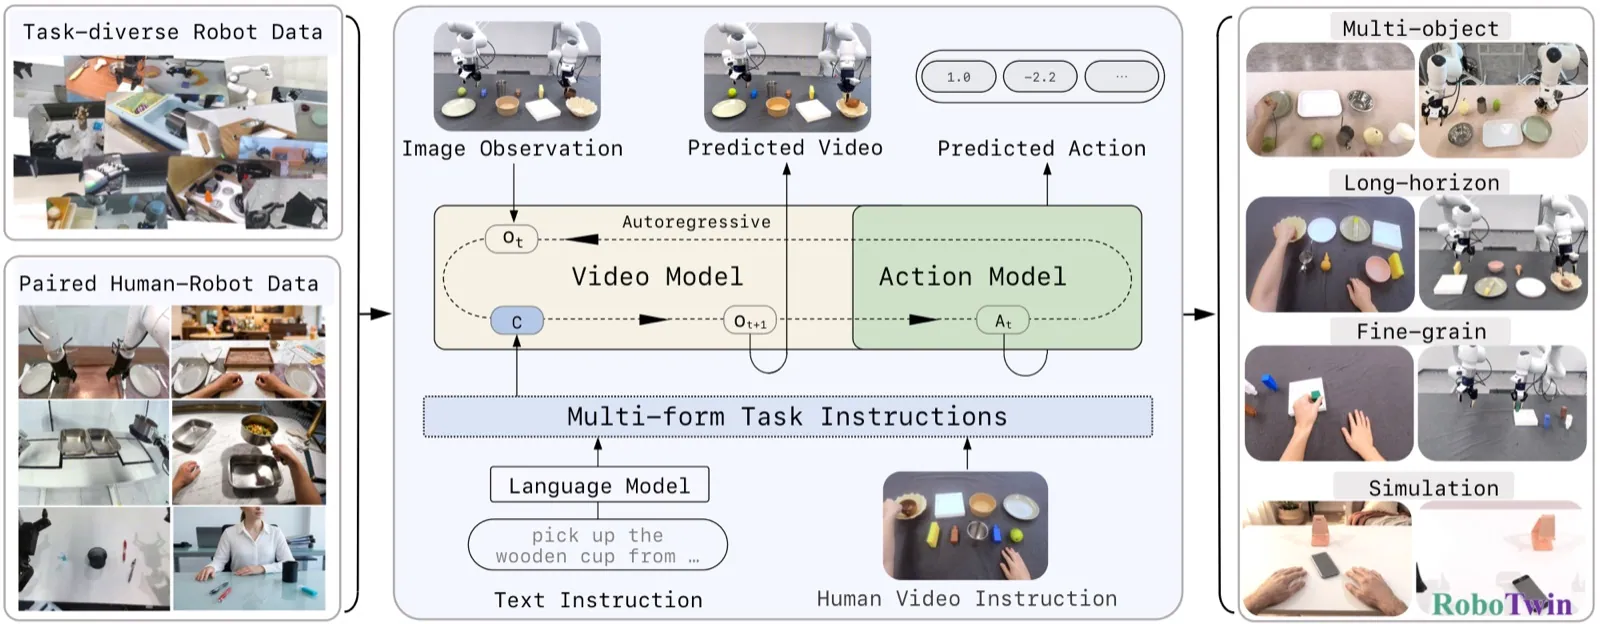
Så fungerar Zero-WAM: en modell som tar antingen text eller en människovideo som instruktion [1]
Om Zero-WAM[1][2][3]
Zero-WAM är ett forskningsprojekt från Robbyant (Ant Group) tillsammans med HKUST och HKUST (Guangzhou). Idén är att en robot ska kunna utföra uppgifter den aldrig tränats på, på samma sätt som en språkmodell kan lösa en ny uppgift bara genom att få ett exempel i sin instruktion. I stället för text får roboten en video där en människa visar vad som ska göras, eftersom en video visar hur uppgiften ska gå till på ett sätt som ord ofta inte klarar.
Modellen är en så kallad världs- och handlingsmodell (world-action model) som både förutser hur videon fortsätter och vilka rörelser roboten ska göra. Eftersom det finns lite data där samma uppgift visas både av en människa och en robot byggde forskarna en automatisk process som gör om robotfilmer till matchande förstapersonsvideor av människor och sorterar bort dåliga exempel. Resultatet blev datasetet HumanGen med 74 200 par av människo- och robotvideor över 8 600 uppgifter. Ett särskilt träningsmål (IFP) tvingar modellen att faktiskt hämta information från människovideon i stället för att gissa utifrån det den redan sett.
Enligt artikeln når Zero-WAM i genomsnitt 47 % lyckade försök (46,95 %) på sju uppgifter i simulatorn RoboTwin 2.0 som den aldrig tränats på, 29,5 procentenheter bättre än den starkaste jämförbara modellen, LingBot-VA. Forskarna visar också försök med riktiga robotar, bland annat långa sekvenser med flera föremål och precisionsuppgifter som att trycka in ett bordsben. Modellvikterna och datasetet finns på Hugging Face och koden på GitHub.
Det viktigaste[1][2]
- Roboten får uppgiften som en video av en människa i stället för som text.
- Datasetet HumanGen har 74 200 par av människo- och robotvideor över 8 600 uppgifter.
- Enligt forskarna lyckas den i snitt i 46,95 % av fallen på sju helt nya uppgifter i RoboTwin 2.0, mot 17,45 % för LingBot-VA.
- Modellvikter, dataset och kod är publicerade.
Källor
- [1] Zero-WAM: In-Context World-Action Modeling from Human Videos for Open-Ended Task Generalization ↗Robbyant och HKUST Officiell sida robbyant-research.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [2] Zero-WAM: In-Context World-Action Modeling from Human Videos for Open-Ended Task Generalization ↗arXiv Forskningsartikel arxiv.orgPublicerad 26 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Robbyant
- 4DAnyone 20 aug 2026
- LingBot-World 2.0 9 jul 2026