Bonsai 2 27B
En kraftigt komprimerad version av Qwen3.8 27B som tar bara 5,9 GB men enligt PrismML behåller 98,2 % av originalmodellens förmåga, så att en modell i 27B-klassen med bildförståelse kan köras lokalt.
- Språkmodell
- Resonemang
- Kod
- Agenter
- Bildförståelse
- Multimodal
- Kör lokalt
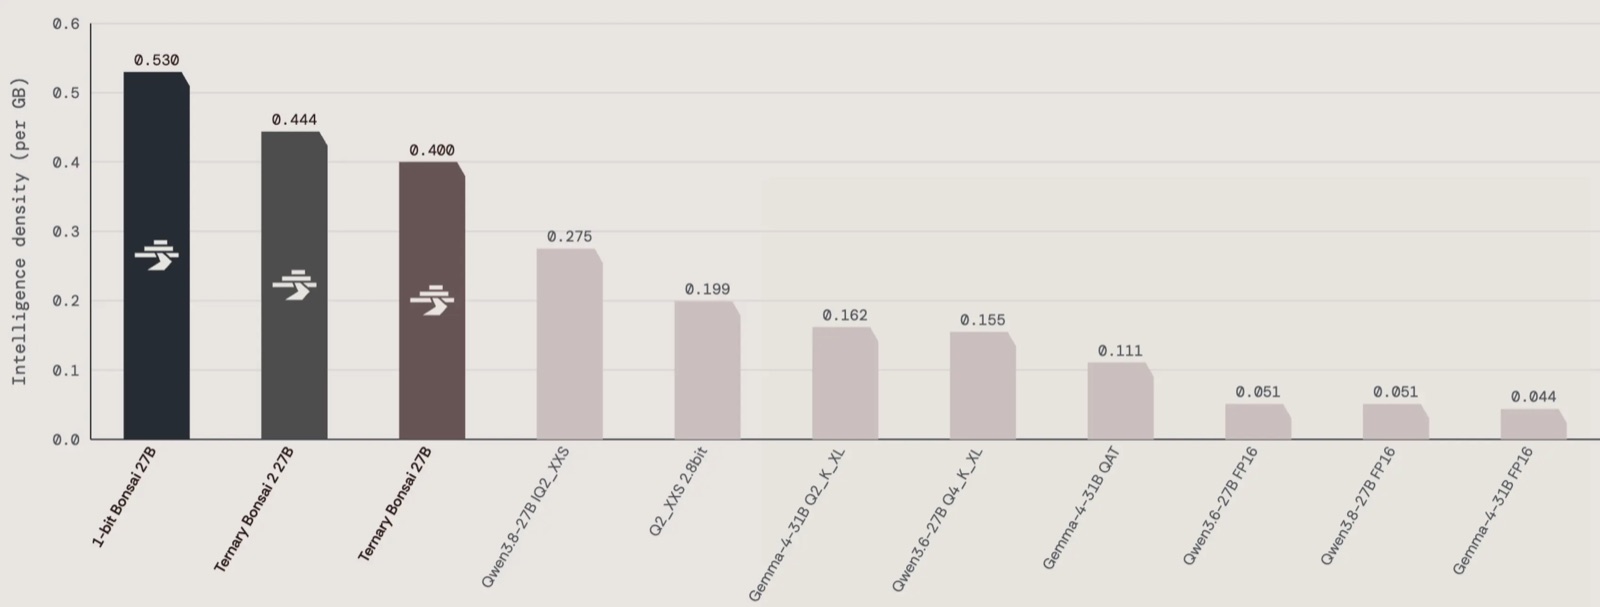
PrismML:s mått på förmåga per gigabyte: Bonsai-modellerna jämfört med andra modeller i 27B-klassen [1]
Om Bonsai 2 27B[1][2][3]
Bonsai 2 27B, eller Ternary Bonsai 2 27B som PrismML också kallar den, är en komprimerad version av Alibabas Qwen3.8 27B. Varje vikt i modellen får bara ett av tre värden (−1, 0 eller +1) med en gemensam skalfaktor per grupp, vilket ger i snitt 1,76 bitar per vikt. Hela modellen tar därmed 5,9 GB, mer än nio gånger mindre än originalet. Den förstår både text och bilder och kan läsa upp till 262 000 tokens.
Enligt PrismML får den 83,9 i snitt på en samling tester inom resonemang, matte, kod, instruktionsföljning, bildförståelse och agentuppgifter, mot 85,4 för fullversionen av Qwen3.8 27B. Det motsvarar 98,2 % av originalets förmåga, mot 95 % för föregångaren Bonsai 27B som släpptes i juli 2026. PrismML lyfter särskilt fram att den behåller förmågan i kodagenter, verktygsanvändning och längre agentuppgifter, där små fel annars brukar förstärkas.
Modellen är också snabb och energisnål. Enligt PrismML når den upp till 143 tokens per sekund på ett Nvidia RTX 5090 och 46,8 tokens per sekund på en Mac med M5 Max, och på ett RTX 4090 drar den 0,714 mWh per token, 40 % mindre än en 8B-modell i full precision. Den körs på Nvidia-kort via CUDA och på Mac, iPhone och iPad via MLX med PrismML:s egna kärnor för lågbitsberäkning. Vikterna är öppna under Apache 2.0.
Samtidigt med 27B-modellen finns mindre modeller i Bonsai 2-serien på 9B, 4B och 2B.
Det viktigaste[1]
- Tar 5,9 GB, mer än nio gånger mindre än originalmodellen Qwen3.8 27B.
- Enligt PrismML behåller den 98,2 % av originalets samlade testresultat (83,9 mot 85,4).
- Förstår både text och bilder och läser upp till 262 000 tokens.
- Enligt PrismML upp till 143 tokens per sekund på RTX 5090 och 46,8 på M5 Max.
- Öppna vikter under Apache 2.0; körs på Nvidia-kort och på Apples enheter.
Källor
- [3] OpenAI hacked, Jev, Dream RSI, Qwen 3.8 Omni, Gemini 3.8 Live, Bonsai 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 20 sep 2026 Läst 25 okt 2026
- [1] Introducing Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint ↗PrismML Officiell sida prismml.comPublicerad 17 sep 2026 Läst 25 okt 2026
- [2] prism-ml/Ternary-Bonsai-2-27B-gguf ↗PrismML (Hugging Face) Modellkort huggingface.coPublicerad 16 sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-09-20). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- Ternary Bonsai 16 apr 2026
Mer från PrismML
- Ternary Bonsai 16 apr 2026 · inaktuell