Ternary Bonsai
En familj små språkmodeller (8B, 4B och 1,7B) där varje vikt bara tar 1,58 bitar, så att de blir ungefär nio gånger mindre än vanliga modeller och kan köras på telefoner och bärbara datorer.
- Språkmodell
- Kör lokalt
 1 / 4
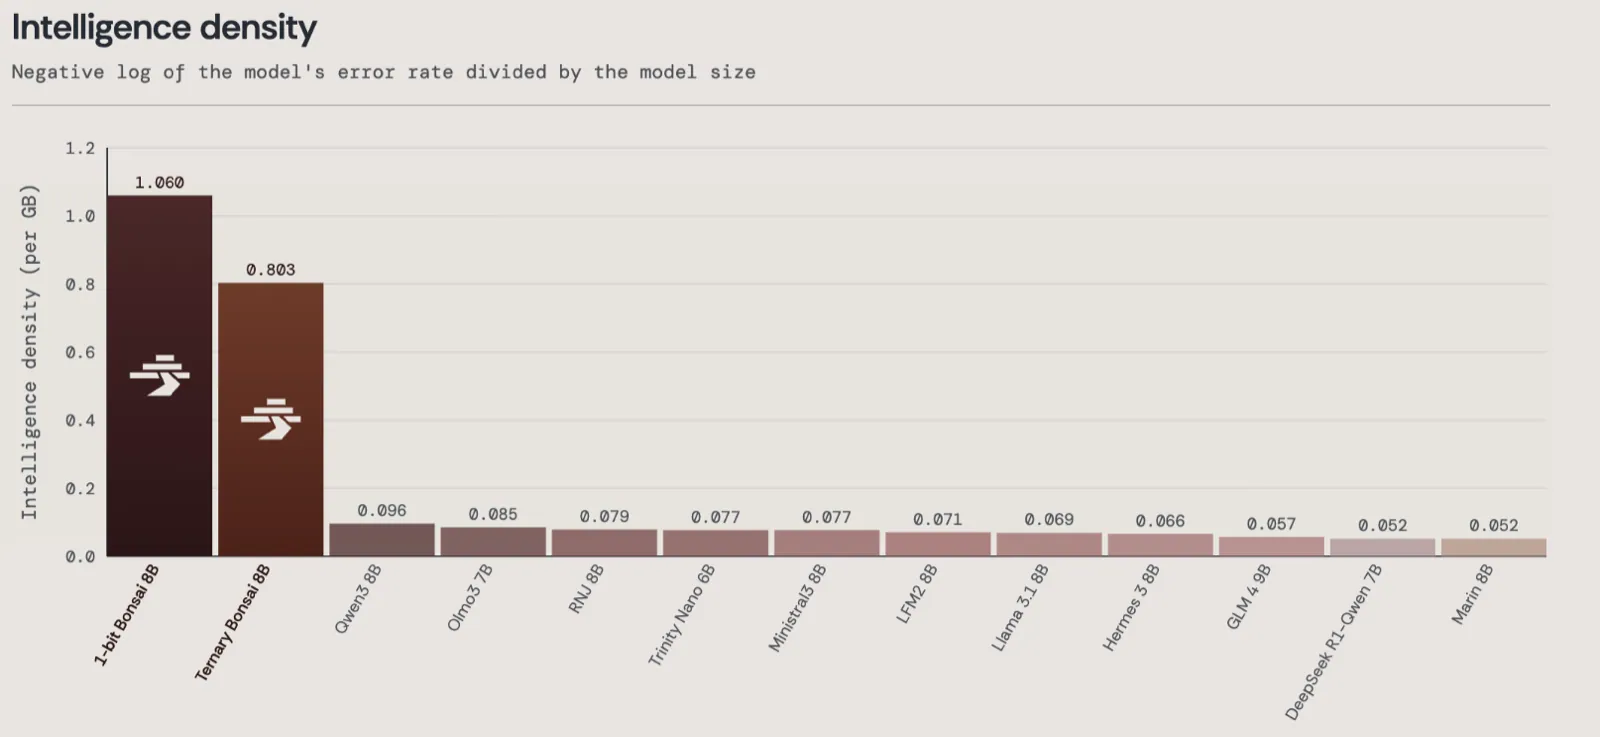
PrismML:s mått på förmåga per gigabyte för Ternary Bonsai 8B jämfört med andra 8B-modeller [1]
Om Ternary Bonsai[1][2][3]
Ternary Bonsai är PrismML:s andra familj av extremt komprimerade språkmodeller, efter 1-bitsmodellerna i 1-bit Bonsai. Varje vikt får ett av tre värden (−1, 0 eller +1), vilket motsvarar 1,58 bitar, med en gemensam skalfaktor för varje grupp om 128 vikter. Komprimeringen gäller hela nätverket, även inbäddningar och utdatalager. Modellerna finns i storlekarna 8B, 4B och 1,7B och tar ungefär nio gånger mindre minne än vanliga 16-bitarsmodeller.
Enligt PrismML får Ternary Bonsai 8B (1,75 GB) i snitt 75,5 på deras tester, fem poäng mer än 1-bit Bonsai 8B, och ligger bara efter Qwen3 8B (16,38 GB) bland jämförbara modeller. På en Mac med M4 Pro kör den 82 tokens per sekund och på en iPhone 17 Pro Max 27 tokens per sekund, med ungefär 3–4 gånger bättre energieffektivitet än fullprecisionsmodeller. Modellerna körs på Apples enheter via MLX och vikterna är öppna under Apache 2.0.
Senare har PrismML släppt Bonsai 27B (juli 2026) och Bonsai 2-serien (september 2026), med Bonsai 2 27B som flaggskepp.
Det viktigaste[1]
- Varje vikt tar 1,58 bitar i hela nätverket, cirka nio gånger mindre än en 16-bitarsmodell.
- Enligt PrismML får 8B-modellen 75,5 i snitt, fem poäng mer än 1-bit Bonsai 8B, med bara 600 MB mer minne.
- 82 tokens per sekund på M4 Pro och 27 på iPhone 17 Pro Max, enligt PrismML.
- Öppna vikter under Apache 2.0.
Källor
- [2] Introducing Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint ↗PrismML Officiell sida prismml.comPublicerad 17 sep 2026 Läst 25 okt 2026
- [3] Claude Opus 4.7, Qwen 3.6, Ernie Image, Happy Oyster, HY World 2.0, Gemini 3.1 TTS: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 19 apr 2026 Läst 25 okt 2026
- [1] Introducing Ternary Bonsai: Top Intelligence at 1.58 Bits ↗PrismML Officiell sida prismml.comPublicerad 16 apr 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från PrismML
- Bonsai 2 27B 17 sep 2026