FastH3 Omni
En snabbare, destillerad version av MiniMax videomodell H3 som gör video med synkat ljud och tal utifrån en prompt plus referensbilder, videoklipp och röstprov – enligt skaparna upp till cirka 12 gånger snabbare.
- Videogenerering
- Multimodal
- Röstkloning
 1 / 9
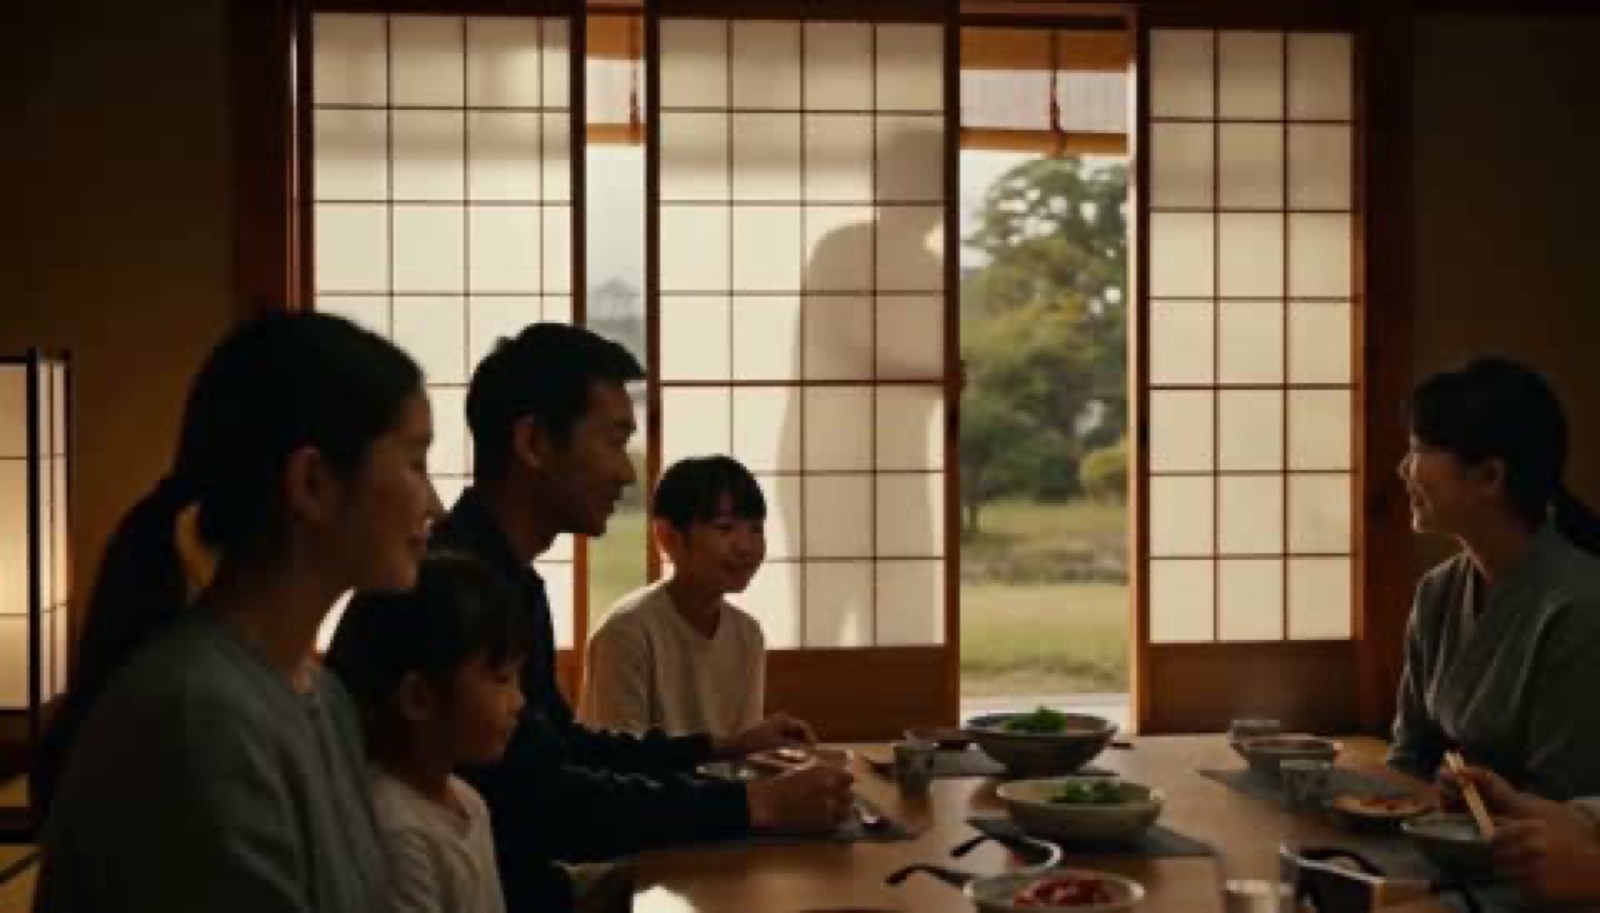
Bild ur en video skapad från tre referensbilder: mannen kommer sent till en familjemiddag [1]
Om FastH3 Omni[1][2][3][5]
FastH3 Omni kommer från FastVideo-teamet vid Hao AI Lab (UCSD) och bygger på MiniMax öppna video- och ljudmodell MiniMax H3. Man ger modellen en textbeskrivning och ett antal referenser – upp till nio bilder, tre videoklipp och tre ljudklipp, högst tolv totalt – och får tillbaka en färdig video med synkroniserat stereoljud. Referenserna kan vara en person som ska vara med, en produkt, en miljö eller en röst vars klang personen i videon ska tala med. Videorna blir 24 bilder per sekund och i testerna 5, 10 eller 15 sekunder långa i 1344 × 768 pixlar.
Poängen är farten. Originalmodellen behöver 50 beräkningssteg, FastH3 Omni klarar sig med 8 tack vare två destilleringstekniker (Parallel Decoding Distillation och Distribution Matching Distillation) som NVIDIA:s FastGen-team har tagit fram. Enligt FastVideo blir hela kedjan 5,6–11,9 gånger snabbare i 27 jämförda fall på åtta NVIDIA GB200-kort, till exempel 14 sekunder i stället för 140 för ett 15 sekunders klipp, och vissa uppgifter går i realtid. Träningen tog enligt teamet cirka 7 800 GPU-timmar på 64 NVIDIA B300. Modellen är framtagen tillsammans med Nuva Lab.
Vikterna finns på Hugging Face i flera varianter: en BF16-version för servrar, NVFP4-vikter för att köra lokalt på NVIDIA DGX Spark eller RTX 5090 (i 480p som standard), FP8-vikter och färdiga versioner för ComfyUI. Användningen styrs av MiniMax H3 Community License. Den tillåter kommersiell användning med villkor, men undantar uttryckligen EU, Storbritannien, Sydkorea och USA från de områden där modellen får användas – den får alltså inte användas i Sverige enligt licensen.
Det viktigaste[4][1][2][3]
- Obs: MiniMax H3-licensen gäller inte i EU, Storbritannien, Sydkorea eller USA. För användning i Sverige krävs en separat licens från MiniMax, som de enligt licensen kan bevilja efter förfrågan.
- Video med synkat stereoljud från en prompt plus upp till nio bilder, tre videoklipp och tre ljudklipp som referenser.
- 8 beräkningssteg i stället för originalets 50; enligt FastVideo 5,6–11,9 gånger lägre total väntetid på åtta GB200-kort.
- Enligt FastVideo realtidsgenerering för vissa uppgifter i 768p.
- Kan köras lokalt på NVIDIA DGX Spark eller RTX 5090 med särskilda NVFP4-vikter.
Källor
- [3] MiniMax-H3 (modellkort och LICENSE) ↗MiniMax Modellkort huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [4] MiniMax H3 Community License Agreement ↗MiniMax Officiell sida huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [5] Cybersecurity chaos, AI for DNA, Kimi K3.1, Claude Duet, Dessa, Fibo 2, Minimax 3.1: AI NEWS ↗AI Search Video youtube.comPublicerad 24 okt 2026 Läst 25 okt 2026
- [1] FastVideo FastH3 Omni: Open Source Real-Time Minimax FastH3 Ref2VA on NVIDIA Blackwell, RTX Spark, and RTX GPUs. ↗Hao AI Lab @ UCSD Officiell sida haoailab.comPublicerad 20 okt 2026 Läst 25 okt 2026
- [2] FastH3 Omni — BF16 Release ↗FastVideo Modellkort huggingface.coPublicerad 5 okt 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Ersätter
- FastH3 Preview v1 27 aug 2026
Mer från Hao AI Lab
- FastH3 Preview v1 27 aug 2026 · inaktuell