FastH3 Preview v1
En öppen, snabbare version av MiniMax H3 som gör video med ljud från text i bara fyra steg, från FastVideo-gruppen vid Hao AI Lab.
- Videogenerering
- Musik & ljud
 1 / 3
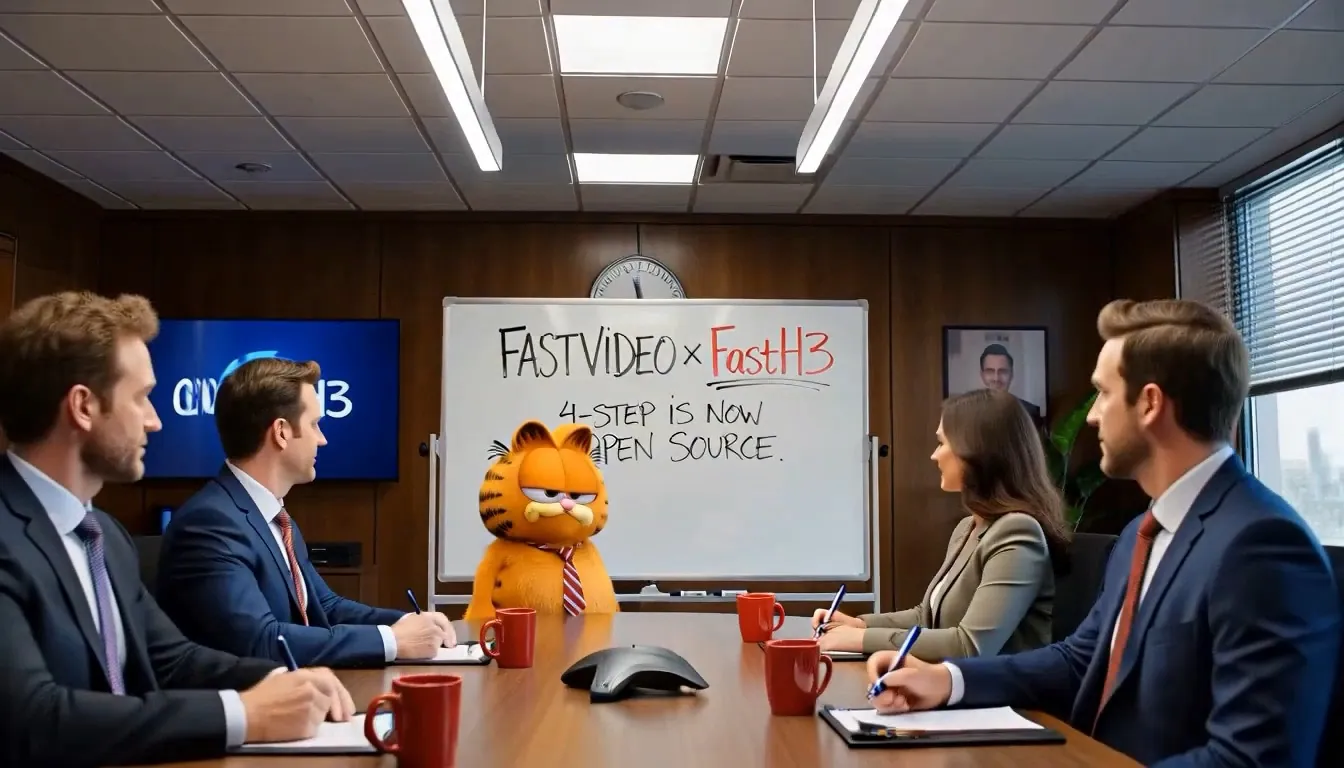
Bildruta ur bloggens introduktionsklipp, skapat med FastH3 [1]
Om FastH3 Preview v1[1][2][3]
FastH3 Preview v1 är en destillerad version av MiniMax H3, en modell som skapar video med synkroniserat ljud från en textbeskrivning. FastVideo-teamet vid Hao AI Lab (UC San Diego) har tränat om basmodellens transformer så att den rekommenderade versionen bara behöver fyra beräkningssteg i stället för 49. Text- och videokodare och övriga delar återanvänds från MiniMax H3-Base, som enligt bloggen har 33 miljarder parametrar.
Enligt Hao AI Lab tar ett 15 sekunder långt klipp i 768p under 13 sekunder att skapa på åtta B200-grafikkort (12,88 s uppmätt), och på ett enda B200-kort blir det upp till drygt 14 gånger snabbare än basmodellen. Samma modell klarar olika upplösningar, bildformat och längder.
Preview v1 klarar bara text till video med ljud; varianter för start- och slutbild och för referensbilder var under utveckling. Vikterna finns på Hugging Face och omfattas av MiniMax H3 Community License. Träningskoden skulle släppas senare. Partners var bland andra Nuva Lab, NVIDIA och MiniMax.
Modellen har sedan dess följts av FastH3 Omni.
Det viktigaste[4][1]
- Obs: bygger på MiniMax H3, vars licens inte gäller i EU, Storbritannien, Sydkorea eller USA. För användning i Sverige krävs en separat licens från MiniMax, som de enligt licensen kan bevilja efter förfrågan.
- Fyra beräkningssteg i stället för basmodellens 49.
- Enligt Hao AI Lab under 13 sekunder för ett 15 sekunder långt 768p-klipp med ljud på åtta B200-kort.
- Upp till drygt 14 gånger snabbare än MiniMax H3 på ett enda B200-kort, enligt bloggen.
- Öppna vikter under MiniMax H3 Community License.
Källor
- [4] MiniMax H3 Community License Agreement ↗MiniMax Officiell sida huggingface.coPublicerad okänt datum Läst 25 okt 2026
- [3] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [1] FastH3 Preview v1 ↗Hao AI Lab (FastVideo) Officiell sida haoailab.comPublicerad 27 aug 2026 Läst 25 okt 2026
- [2] FastVideo/FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree ↗FastVideo (Hugging Face) Modellkort huggingface.coPublicerad 27 aug 2026 Läst 25 okt 2026
Historik
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Hao AI Lab
- FastH3 Omni 20 okt 2026