GLM-5.3-Flash
Z.ai:s billiga, öppna modell som ser bilder och video och som enligt företaget slår GLM-5.2 och närmar sig Claude Opus 4.8 i kod, till en tiondel av priset.
- Språkmodell
- Kod
- Agenter
- Multimodal
- Bildförståelse
 1 / 6
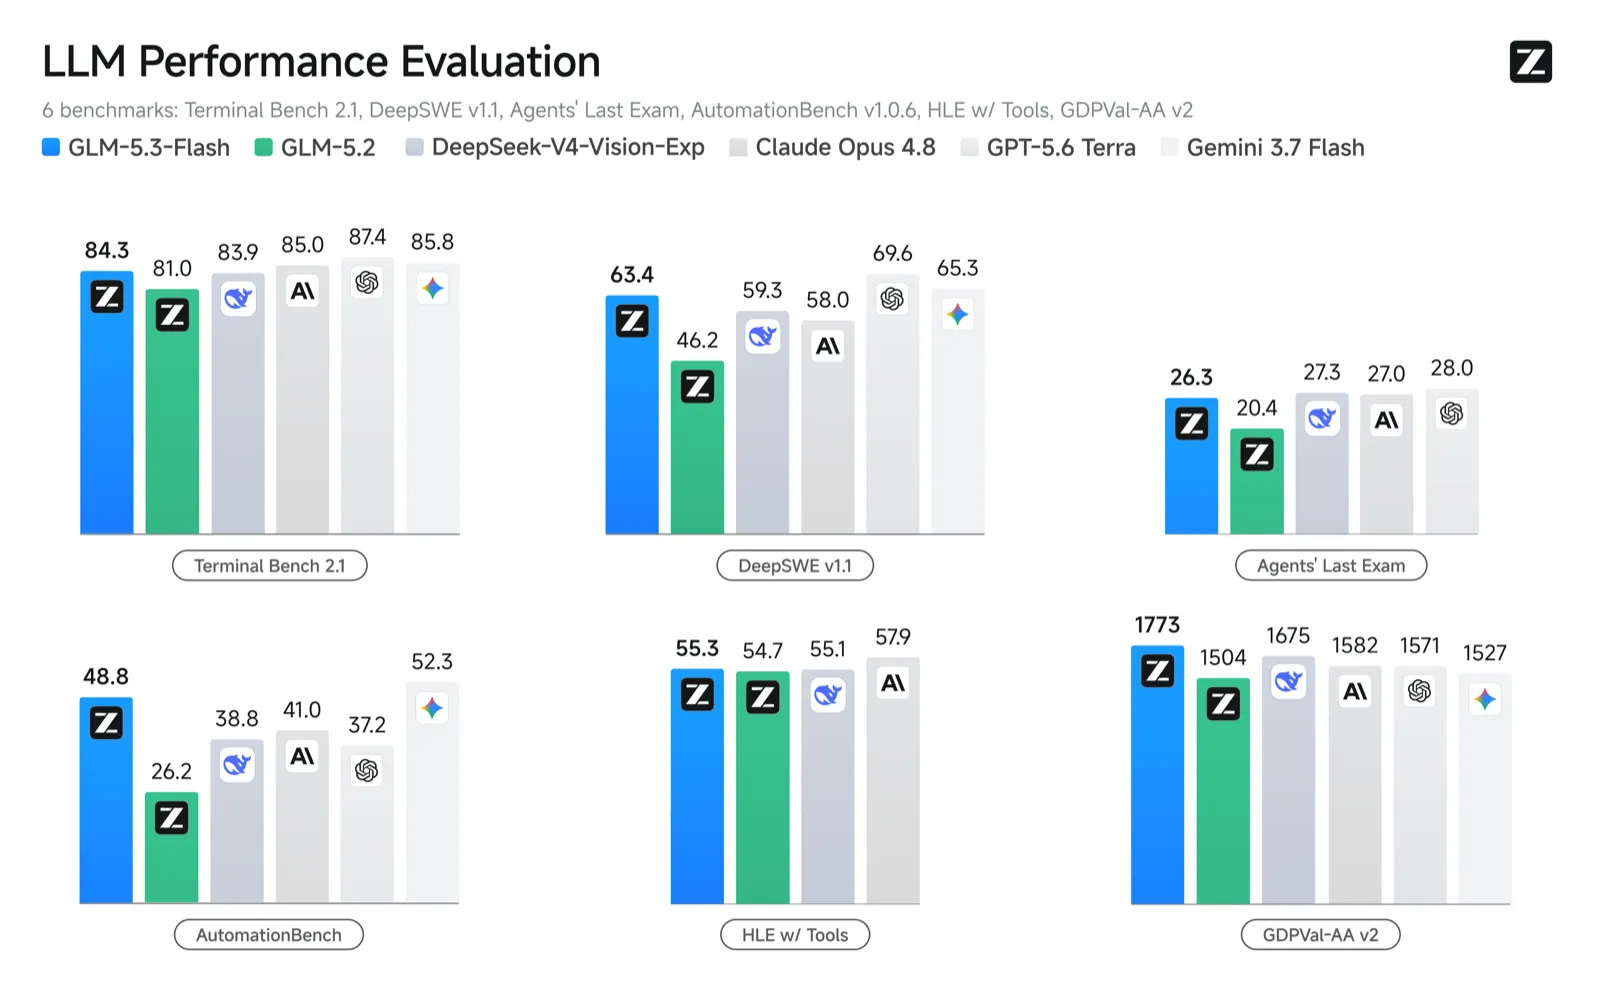
Z.ai:s jämförelse av GLM-5.3-Flash mot andra modeller på kod-, agent- och bildtester [2]
Om GLM-5.3-Flash[1][2][3][4][5][6][7]
GLM-5.3-Flash släpptes av Z.ai (tidigare Zhipu) i slutet av augusti 2026. Innan lanseringen testades den anonymt under namnet ox-alpha på OpenCode och OpenRouter, där den enligt Z.ai snabbt blev veckans mest använda modell. Det är den första modellen i GLM-5-serien som är multimodal från grunden: den tar emot text, bilder, video och filer och svarar med text.
Modellen har 320 miljarder parametrar totalt, varav bara 18 miljarder används per token. Den bygger på en helt ny grundmodell, tränad på 30 biljoner tokens, och är den första GLM-modellen som blandar gles och linjär uppmärksamhet (attention). Det gör långa texter mycket billigare att köra, och den läser upp till 1 miljon tokens. Enligt Z.ai använder den tre gånger mindre beräkning för uppmärksamheten och ett 4,4 gånger mindre minne för sammanhanget än GLM-5.3.
Z.ai säger att den slår GLM-5.2 på i stort sett alla tester, till en tiondel av priset, och kommer nära Claude Opus 4.8 i kod och agentuppgifter. Synen används i kodarbetet: modellen kan rendera det den byggt, titta på resultatet och rätta fel, till exempel en presentationsbild där texten hamnat fel. I ZCode kan den styra webbläsare och datorprogram.
I en separat bloggpost i september berättar Z.ai att GLM-5.3 själv hjälpte till att bygga systemet som kör GLM-5.3-Flash, på över 100 000 kinesiska AI-chip. En agent driven av GLM-5.3 arbetade tillsammans med ingenjörer och fick detaljerad återkoppling från tester och mätningar. Enligt Z.ai gick det från första körning till produktion på under två veckor, och kapaciteten tredubblades jämfört med startläget, till en kostnad per token i nivå med vanliga NVIDIA-grafikkort. Under de första sex dagarna behandlades över 62 biljoner tokens.
Vikterna finns på Hugging Face under MIT-licens. I API:t kostar modellen 0,15 dollar per miljon tokens in och 0,50 dollar ut, och det finns även en snabbare variant, GLM-5.3-FlashX, på cirka 200 tokens per sekund.
Det viktigaste[1][4][5]
- Avslöjad som den anonyma testmodellen ox-alpha, som enligt Z.ai blev mest använd på både OpenCode och OpenRouter.
- 320B parametrar men bara 18B aktiva; ny blandning av gles och linjär uppmärksamhet ger billiga långa sammanhang upp till 1M tokens.
- Enligt Z.ai 57 poäng på Artificial Analysis Intelligence Index för 0,045 dollar per uppgift, en nivå som tidigare kostat ungefär tio gånger mer.
- Z.ai Code Bench på max-nivå: 29,0 mot 29,5 för Claude Opus 4.8, enligt Z.ai.
- Driftsystemet byggdes med hjälp av en GLM-5.3-agent på under två veckor och fick tre gånger högre kapacitet än startläget.
- MIT-licens; i API:t 0,15 dollar per miljon tokens in och 0,50 dollar ut.
Källor
- [3] GLM-5.3-Flash ↗Z.ai (API-dokumentation) Officiell sida docs.z.aiPublicerad okänt datum Läst 25 okt 2026
- [4]
- [7] OpenAI hacked, Jev, Dream RSI, Qwen 3.8 Omni, Gemini 3.8 Live, Bonsai 2: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 20 sep 2026 Läst 25 okt 2026
- [5] Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure ↗Z.ai Officiell sida z.aiPublicerad 17 sep 2026 Läst 25 okt 2026
- [6] GLM 5.3 Flash, Qwen 3.8 Flash Next, Minimax FastH3, Tencent Hy4: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 30 aug 2026 Läst 25 okt 2026
- [1] GLM-5.3-Flash: Frontier Intelligence, Flash Cost ↗Z.ai Officiell sida z.aiPublicerad 26 aug 2026 Läst 25 okt 2026
- [2] zai-org/GLM-5.3-Flash ↗Z.ai (Hugging Face) Modellkort huggingface.coPublicerad 25 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-30 och 2026-09-20). [6]
Placeringar i topplistor
- EuroEval – svenska (generativa modeller)med exempel i frågan (few-shot); öppna vikter#1 · 1.28 ± 0.11
- #9 · 88.94% ± 1.91
- #12 · 1642 (1625–1660)
- #18 · 45.19% ± 3.46
- #18 · 60.59% ± 2.03
- #19 · 42
- Terminal-Bench 4.0Claude Code, tankenivå none#23 · 35.8% ± 3.5
- #30 · 1608 ± 6
- #35 · 1476 ± 5
- #45 · 83.93% ± 0.43
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Z.ai (Zhipu)
- GLM-5.3 14 aug 2026
- GLM-5.1 7 apr 2026 · inaktuell
- GLM-5V-Turbo apr 2026