GLM-5V-Turbo
Z.ai:s seende kodmodell som tittar på skisser, skärmbilder och video och gör om dem till fungerande appar eller utför uppgifter i grafiska gränssnitt.
- Bildförståelse
- Kod
- Agenter
- Multimodal
 1 / 5
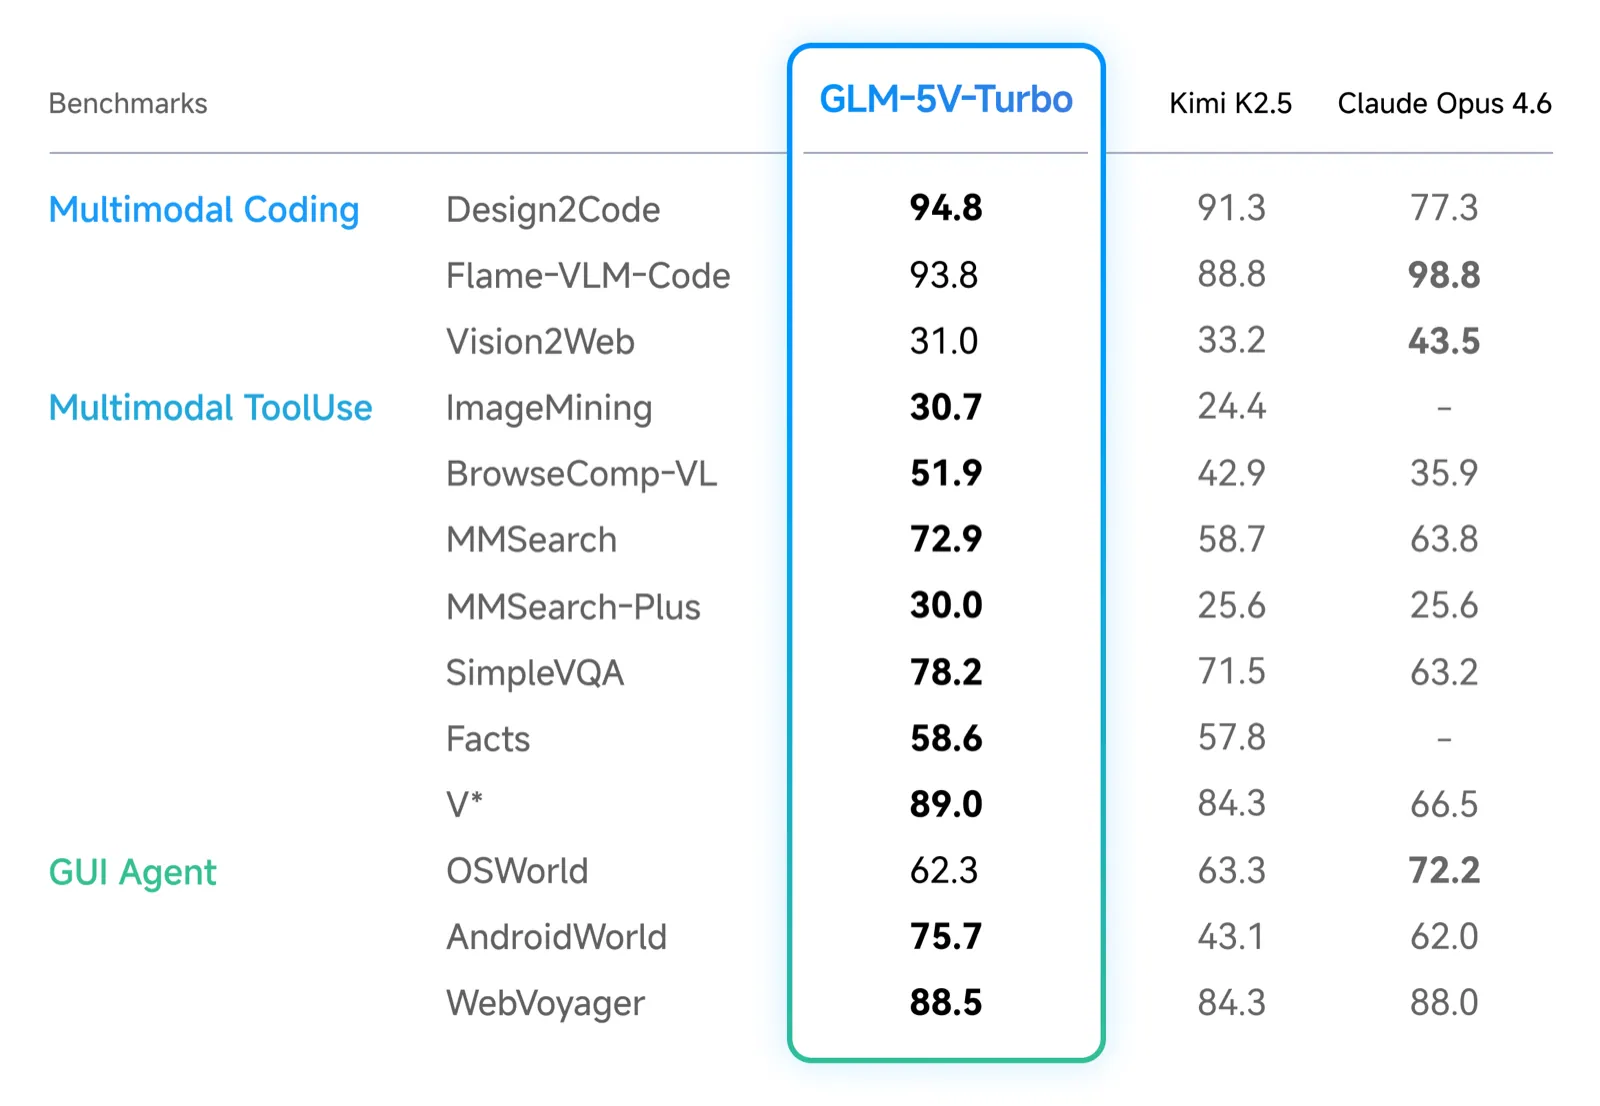
Z.ai:s resultat för multimodal kod, verktygsanvändning och grafiska agenter, mot Kimi K2.5 och Claude Opus 4.6 [1]
Om GLM-5V-Turbo[1][2][3][4]
GLM-5V-Turbo är Z.ai:s (tidigare Zhipu) första multimodala grundmodell för kod, lanserad i början av april 2026. Den tar emot bilder, video, filer och text och svarar med text, och är byggd för agentarbete: att förstå det den ser, planera och sedan agera. Den är mer en assistent som ser och gör saker än en chattbot.
Typiska användningar enligt Z.ai är att göra om en designskiss eller referensbild till ett körbart webbgränssnitt, att utforska en webbplats tillsammans med Claude Code och skriva kod utifrån den, att hitta layout-, överlappnings- och färgfel i skärmbilder och föreslå rättningar, och att hjälpa agenten OpenClaw att förstå webbsidor, knappar och diagram. Modellen kan också peka ut föremål i bilder med koordinater och följa föremål i video.
Tekniskt bygger den på en ny bildkodare, CogViT, och har tränats med förstärkningsinlärning på över 30 typer av uppgifter, från matematik och naturvetenskap till grafiska agenter och kodagenter. Enligt Z.ai leder den på flera tester för kod utifrån bilder och för bildbaserad sökning, medan Claude Opus 4.6 är bättre på bland annat Vision2Web och OSWorld. Z.ai uppger att den rena textkodningen inte blivit sämre.
Modellen läser upp till 200 000 tokens och skriver upp till 128 000. Den finns bara via Z.ai:s API; inga öppna vikter har släppts, och priset står inte på Z.ai:s egen prislista (nyhetssajten The Decoder uppger 1,20 dollar per miljon tokens in och 4 dollar ut). Senare under året släppte Z.ai GLM-5.3-Flash, som också ser bilder och video.
Det viktigaste[1][2]
- Enligt Z.ai 94,8 på Design2Code (kod från design), mot 91,3 för Kimi K2.5 och 77,3 för Claude Opus 4.6.
- Enligt Z.ai 75,7 på AndroidWorld och 88,5 på WebVoyager, men efter Claude Opus 4.6 på OSWorld (62,3 mot 72,2).
- Gör om designskisser och skärmbilder till körbar kod och hittar layoutfel i skärmbilder.
- Fungerar med Claude Code och OpenClaw; kan följa föremål i video och peka ut saker i bilder.
- 200k tokens kontext, upp till 128k tokens svar; bara via API.
Källor
- [1] GLM-5V-Turbo ↗Z.ai (API-dokumentation) Officiell sida docs.z.aiPublicerad okänt datum Läst 25 okt 2026
- [3] GLM-5.3-Flash: Frontier Intelligence, Flash Cost ↗Z.ai Officiell sida z.aiPublicerad 26 aug 2026 Läst 25 okt 2026
- [4] Gemma 4, Claude Code leak, Qwen 3.6, Wan 2.7, OmniVoice, DreamLite, GLM-5V: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 5 apr 2026 Läst 25 okt 2026
- [2] Zhipu AI's GLM-5V-Turbo turns design mockups directly into executable front-end code ↗The Decoder Artikel the-decoder.comPublicerad 3 apr 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-05). [4]
Placeringar i topplistor
- #97 · 1401 ± 13
- #110 · 1434 ± 6
Placering i varje lista när den lästes av. Klicka för källa och datum.
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från Z.ai (Zhipu)
- GLM-5.3-Flash 26 aug 2026
- GLM-5.3 14 aug 2026
- GLM-5.1 7 apr 2026 · inaktuell