HarnessEval
Ett nytt sätt att testa världsmodeller där en AI-agent granskar varje genererad video som en detektiv, med underagenter och verktyg, och lämnar en spårbar motivering i stället för bara en siffra.
- Världsmodeller
- Agenter
- Videogenerering
 1 / 4
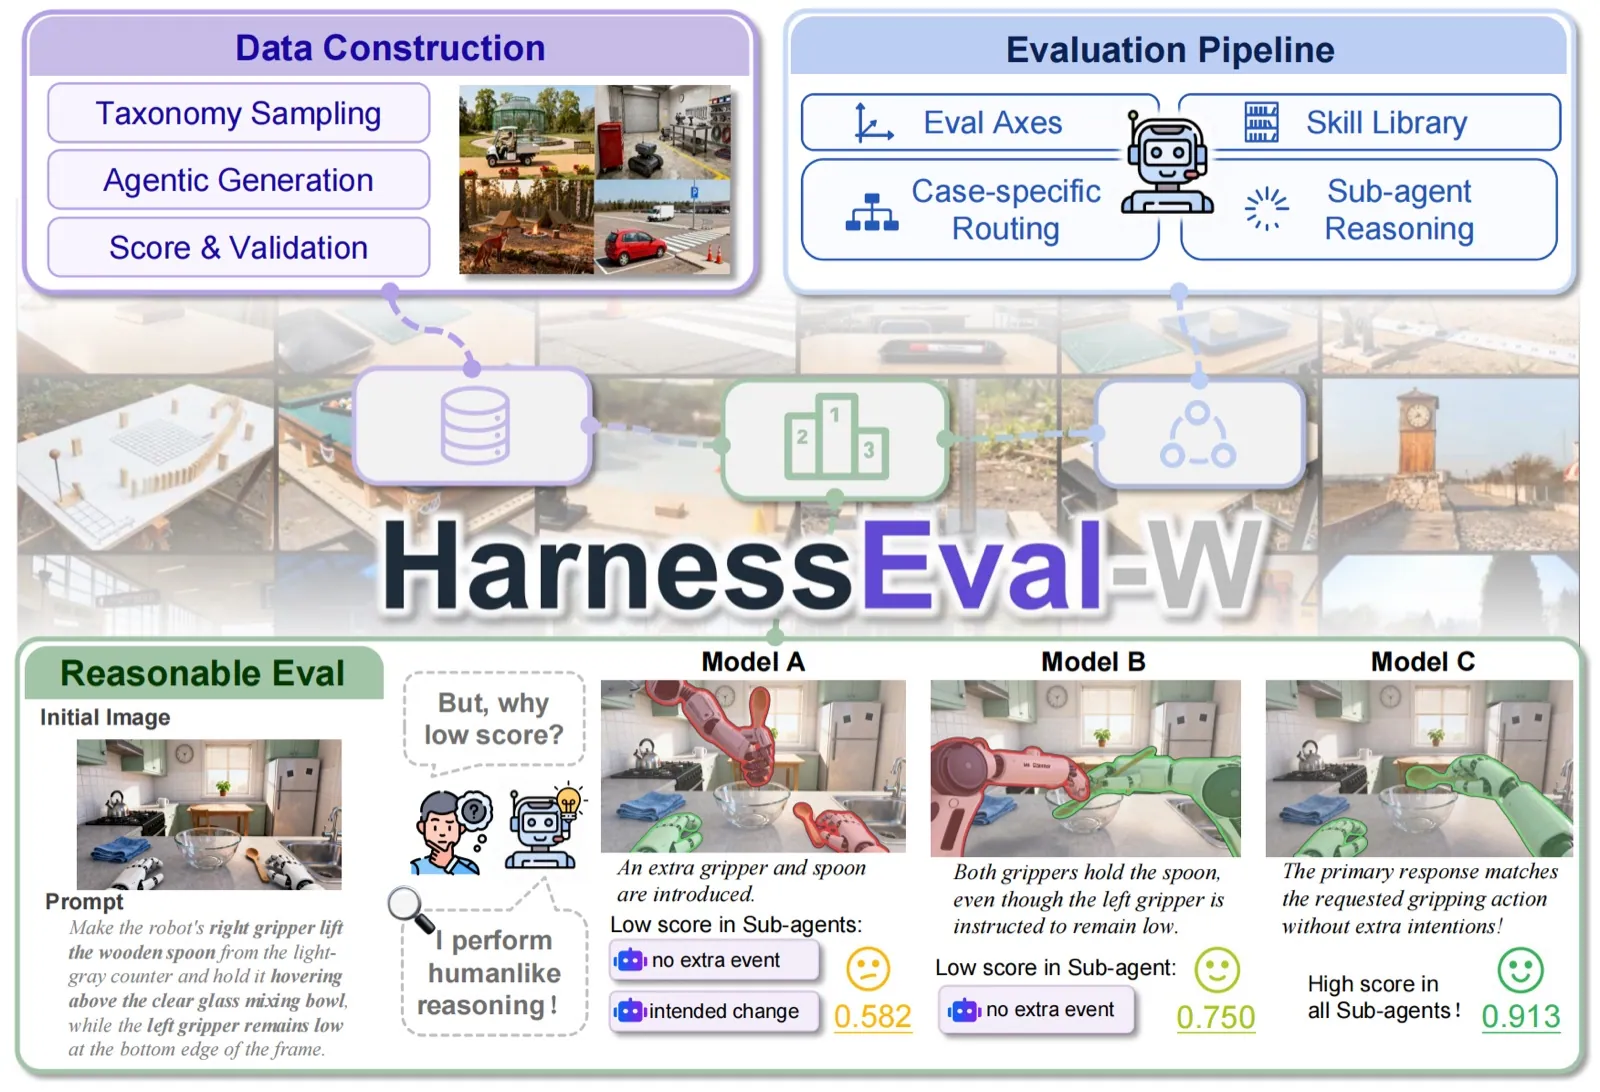
Översikt: hur testfallen tas fram, hur utvärderingen går till och exempel på motiverade poäng för tre modeller [3]
Om HarnessEval[1][2][3][4][5]
HarnessEval är MirroS idé om att utvärdera AI med en så kallad harness, alltså en agent med verktyg och arbetsflöden, i stället för en fast poängmall. Det första exemplet heter HarnessEval-W och är ett test för interaktiva världsmodeller, alltså modeller som skapar video utifrån en startbild och handlingar som kamerarörelser eller textinstruktioner. MirroS jämför arbetssättet med Sherlock Holmes: agenten letar ledtrådar, kopplar ihop dem och drar en slutsats.
Testet bedömer tre saker. Bildkvalitet: ser videon trovärdig och sammanhängande ut? Rätt övergångar: utförs den begärda handlingen, till exempel att kameran rör sig, att ett föremål ändras eller att något fysiskt händer, vid rätt tidpunkt? Och beständighet: ser världen likadan ut när man kommer tillbaka till en plats, och fortsätter saker som händer utanför bild som de ska?
För varje testfall väljer huvudagenten vilka av nio färdigheter som passar, till exempel en som kontrollerar fysisk rimlighet eller en som kontrollerar att en plats är densamma vid återbesök. Varje fråga bryts ner i mindre delfrågor som underagenter och verktyg besvarar, och resultatet blir ett bevisträd som visar vad som testades och varför poängen blev som den blev. Testfallen tas själva fram av agenter som genererar startbilder och handlingar och sorterar bort orimliga fall.
Testet omfattar 330 fall och enligt projektsidan har 18 världsmodeller utvärderats. Koden och testet är öppna på GitHub, och en publik uppsättning på 100 fall med topplista släpptes i september 2026. Projektsidan anger inte vilken AI-modell agenterna själva använder.
Det viktigaste[1][2][3]
- En agent planerar varje utvärdering, delar upp den i delfrågor och skickar dem till specialiserade underagenter och verktyg.
- Bedömer bildkvalitet, om handlingar utförs rätt och om världen förblir konsekvent över tid.
- Varje poäng kommer med ett bevisträd som visar exakt vad som testades och varför.
- 330 testfall; enligt projektsidan har 18 världsmodeller utvärderats.
- Koden är öppen och en publik uppsättning på 100 fall med topplista finns på Hugging Face.
Källor
- [2]
- [5] Deepseek Vision, Ornith 1.5, GEN 1.5, Happy Shrimp, SenseNova U1.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 23 aug 2026 Läst 25 okt 2026
- [1] HarnessEval: The Era of Harness for Benchmarking ↗MirroS Officiell sida mirros.aiPublicerad 17 aug 2026 Läst 25 okt 2026
- [3] HarnessEval-W: Agentifying the Evaluation of Visual Worlds ↗MirroS (GitHub) Officiell sida github.comPublicerad 17 aug 2026 Läst 25 okt 2026
- [4] HarnessEval-W: Agentifying the Evaluation of Visual Worlds ↗arXiv Forskningsartikel arxiv.orgPublicerad 17 aug 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-08-23). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från MirroS
- AgentGarten 8 okt 2026