Mira-Scene
Gör om en enda bild av ett rum till en 3D-scen där varje möbel och föremål är ett eget 3D-objekt på rätt plats, så att scenen kan redigeras och användas i simuleringar.
- 3D
- Bildförståelse
 1 / 5
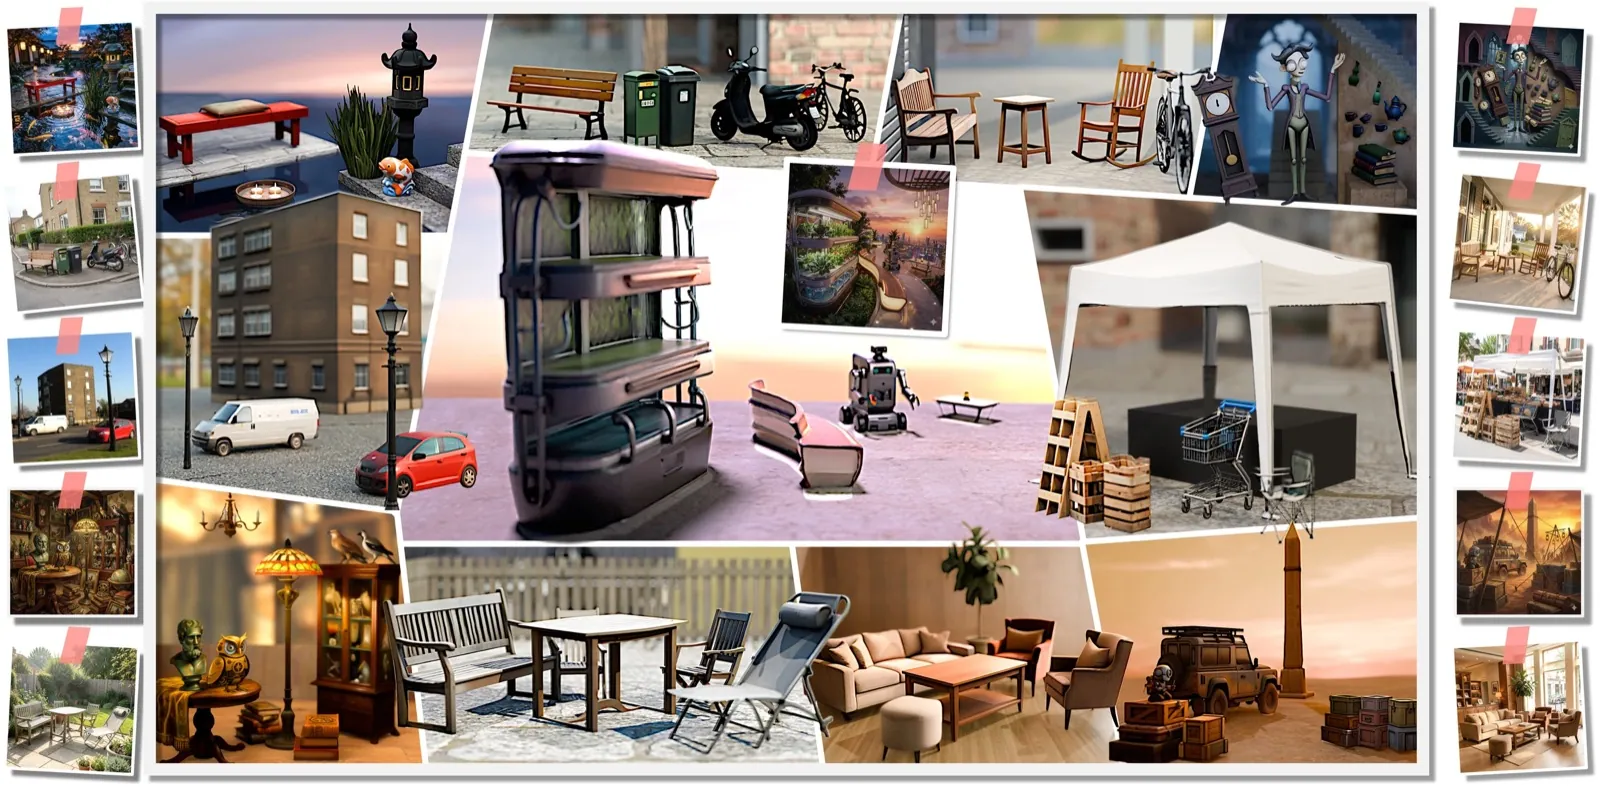
Mira-Scene skapar objektens form och deras placering i scenen samtidigt [1]
Om Mira-Scene[1][2][4]
Mira-Scene är ett forskningsprojekt om att återskapa en hel 3D-scen från en enda bild. Dagens AI-modeller kan göra mycket detaljerade 3D-objekt från en bild, men att placera flera objekt rätt i förhållande till varandra är fortfarande svårt. Metoder som skapar hela scenen på en gång tappar detaljer i objekten, medan metoder som gör objekten ett och ett ofta placerar dem fel.
Mira-Scene gör objekten ett och ett men löser placeringen på ett nytt sätt. I stället för att gissa varje objekts position och vridning direkt förutsäger modellen, för varje synlig bildpunkt, var på objektets yta den punkten ligger (en så kallad Canonical Coordinate Map). Tillsammans med ett punktmoln av scenen från en djupuppskattning ger det täta kopplingar mellan objektet och scenen, och ur dem räknas objektets placering fram. En diffusionsmodell skapar objektens form och de här kopplingarna samtidigt. Eftersom metoden kan tränas på vanliga 3D-objekt behövs inga dyra, märkta scener.
Enligt forskarna placerar Mira-Scene objekt klart bättre än jämförda metoder, med 39,8 % bättre 3D-IoU och 16,5 % bättre 2D-IoU än SAM3D, trots begränsad öppen träningsdata. Projektsidan visar tolv återskapade scener som går att rotera i 3D, jämförelser med scener som GPT-6 Astra byggt från grunden, och exempel där scenerna används i Blender och i robotsimulatorn Isaac, där föremål faller, flyttas och krockar.
Arbetet kommer från University of Hong Kong och VAST. Kod, vikter (MIT-licens enligt Hugging Face) och ett dataset finns tillgängliga.
Det viktigaste[1]
- Gör om en enda bild till en 3D-scen där varje föremål är ett eget, detaljerat 3D-objekt.
- Placerar objekten genom att koppla varje bildpunkt till en punkt på objektets yta, i stället för att gissa position och vridning direkt.
- Enligt forskarna 39,8 % bättre 3D-IoU och 16,5 % bättre 2D-IoU än SAM3D på att placera objekt.
- Kan tränas på vanliga 3D-objekt, utan märkta scener.
- De återskapade scenerna kan redigeras och användas i Blender och robotsimulatorn Isaac.
- Kod, vikter och dataset är öppna.
Källor
- [4] GPT 6 Sol, Gemini 3.8 TTS, Grok 4.7, Opus 5.5, Mimo 2.6, WorldCrafter: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 27 sep 2026 Läst 25 okt 2026
- [5] Waifus incoming, GPT 6 Sol, Grok 4.7, Opus 5.5, Mimo 2.6, Step 5, OpenMuse: AI NEWS ↗AI Search Video youtube.comPublicerad 26 sep 2026 Läst 25 okt 2026
- [2] Mira-Scene: Pixel-Aligned Layouts for Generative 3D Scene Reconstruction ↗arXiv Forskningsartikel arxiv.orgPublicerad 20 sep 2026 Läst 25 okt 2026
- [3] Yang-Tian/Mira-Scene ↗Hugging Face (Yang-Tian) Modellkort huggingface.coPublicerad 18 sep 2026 Läst 25 okt 2026
- [1] Mira-Scene: Pixel-Aligned Layouts for Generative 3D Scene Reconstruction ↗VAST (Eden) Officiell sida vast-eden.aiPublicerad sep 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (video 2026-09-26). [5]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från VAST
- AniGen 9 apr 2026