MMPhysVideo
En träningsmetod som får videomodeller att följa fysikens lagar bättre, så att vatten som stänker och saker som rullar ser trovärdiga ut, utan extra kostnad när videon skapas.
- Videogenerering
 1 / 5
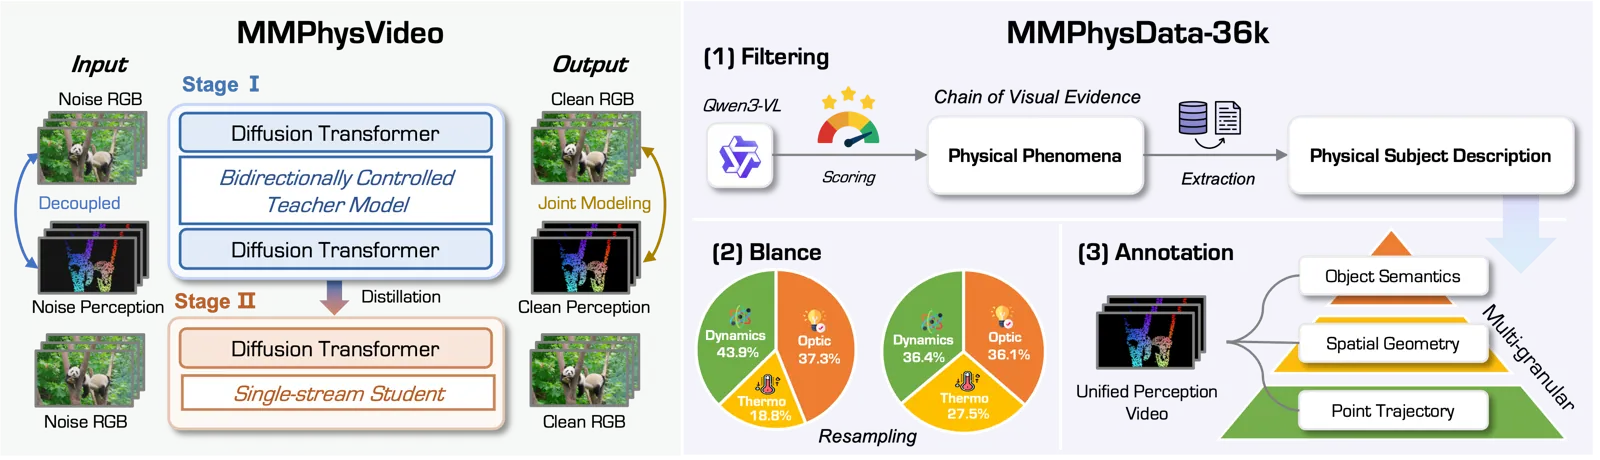
Så fungerar MMPhysVideo: en lärare med två grenar för video och perception, som sedan överförs till en elevmodell [1]
Om MMPhysVideo[1][2][3]
MMPhysVideo angriper ett vanligt problem med AI-video: bilderna ser snygga ut, men rörelserna bryter ofta mot fysiken. Forskarna menar att det beror på att videomodellerna bara lär sig från pixlar. Lösningen är att låta modellen samtidigt lära sig från extra information om vad som händer i bilden: vilka objekt det är (semantik), deras form och djup (geometri) och hur punkter rör sig över tid. Allt detta görs om till ett bildliknande format som videomodellen kan hantera direkt.
Träningen sker i två steg. En lärarmodell med två parallella grenar, en för vanlig video och en för den extra informationen, kopplas ihop försiktigt så att de inte stör varandra. Därefter överförs lärarens kunskap om fysik till en vanlig elevmodell med en enda gren. Därför kostar metoden inget extra när videon genereras. Forskarna har också byggt MMPhysPipe, ett system för att samla in och märka upp fysikrika videor, där bild- och språkmodellen Qwen3-VL väljer ut videor och pekar ut de föremål som är fysikaliskt intressanta.
Enligt forskarna förbättrar MMPhysVideo både fysikalisk trovärdighet och bildkvalitet för flera videomodeller, bland annat CogVideoX-2B, CogVideoX-5B och Wan2.1-1.3B, och når toppresultat jämfört med tidigare metoder. Projektsidan visar exempel som honung i mjölk, däck genom vattenpölar och vin som hälls i ett glas.
Arbetet kommer från CASIA (Chinese Academy of Sciences Institute of Automation) och StepFun, där projektledaren och två av de ansvariga forskarna arbetar. Kod och dataset var när detta skrevs markerade som "kommer snart" och GitHub-länken till koden gick inte att öppna. Artikeln uppdaterades i augusti 2026 med en ny titel, "Physically Plausible Video Generation Through Joint RGB-Perception Modeling".
Det viktigaste[1][2]
- Låter videomodellen lära sig av objekt, form och rörelsebanor, inte bara pixlar.
- Ingen extra kostnad när videon skapas: kunskapen förs över till en vanlig modell med en gren.
- Enligt forskarna bättre fysik och bildkvalitet för CogVideoX-2B, CogVideoX-5B och Wan2.1-1.3B.
- Eget system, MMPhysPipe, för att samla in och märka upp fysikrika videor.
- Kod och data var ännu inte släppta när detta skrevs.
Källor
- [1] MMPhysVideo: Scaling Physical Plausibility in Video Generation via Joint Multimodal Modeling ↗CASIA och StepFun Officiell sida shubolin028.github.ioPublicerad okänt datum Läst 25 okt 2026
- [3] Mythos, Deepseek Expert, HappyHorse, Muse Spark, AceStep XL, GLM-5.1, Waypoint 1.5: AI NEWS ↗AI Search Nyhetsbrev aisearch.substack.comPublicerad 12 apr 2026 Läst 25 okt 2026
- [2] MMPhysVideo: Physically Plausible Video Generation Through Joint RGB-Perception Modeling ↗arXiv Forskningsartikel arxiv.orgPublicerad 3 apr 2026 Läst 25 okt 2026
Historik
- 25 okt 2026Tillagd i listan efter AI Search (nyhetsbrev 2026-04-12). [3]
Vår bedömning
Inte bedömd än. Alla kan ändra.
Kommentarer
Inga kommentarer än. Skriv gärna vilket projekt den kan passa i.
Mer från StepFun
- Step 5 Preview sep 2026
- StepAudio 3 sep 2026